세 줄 요약
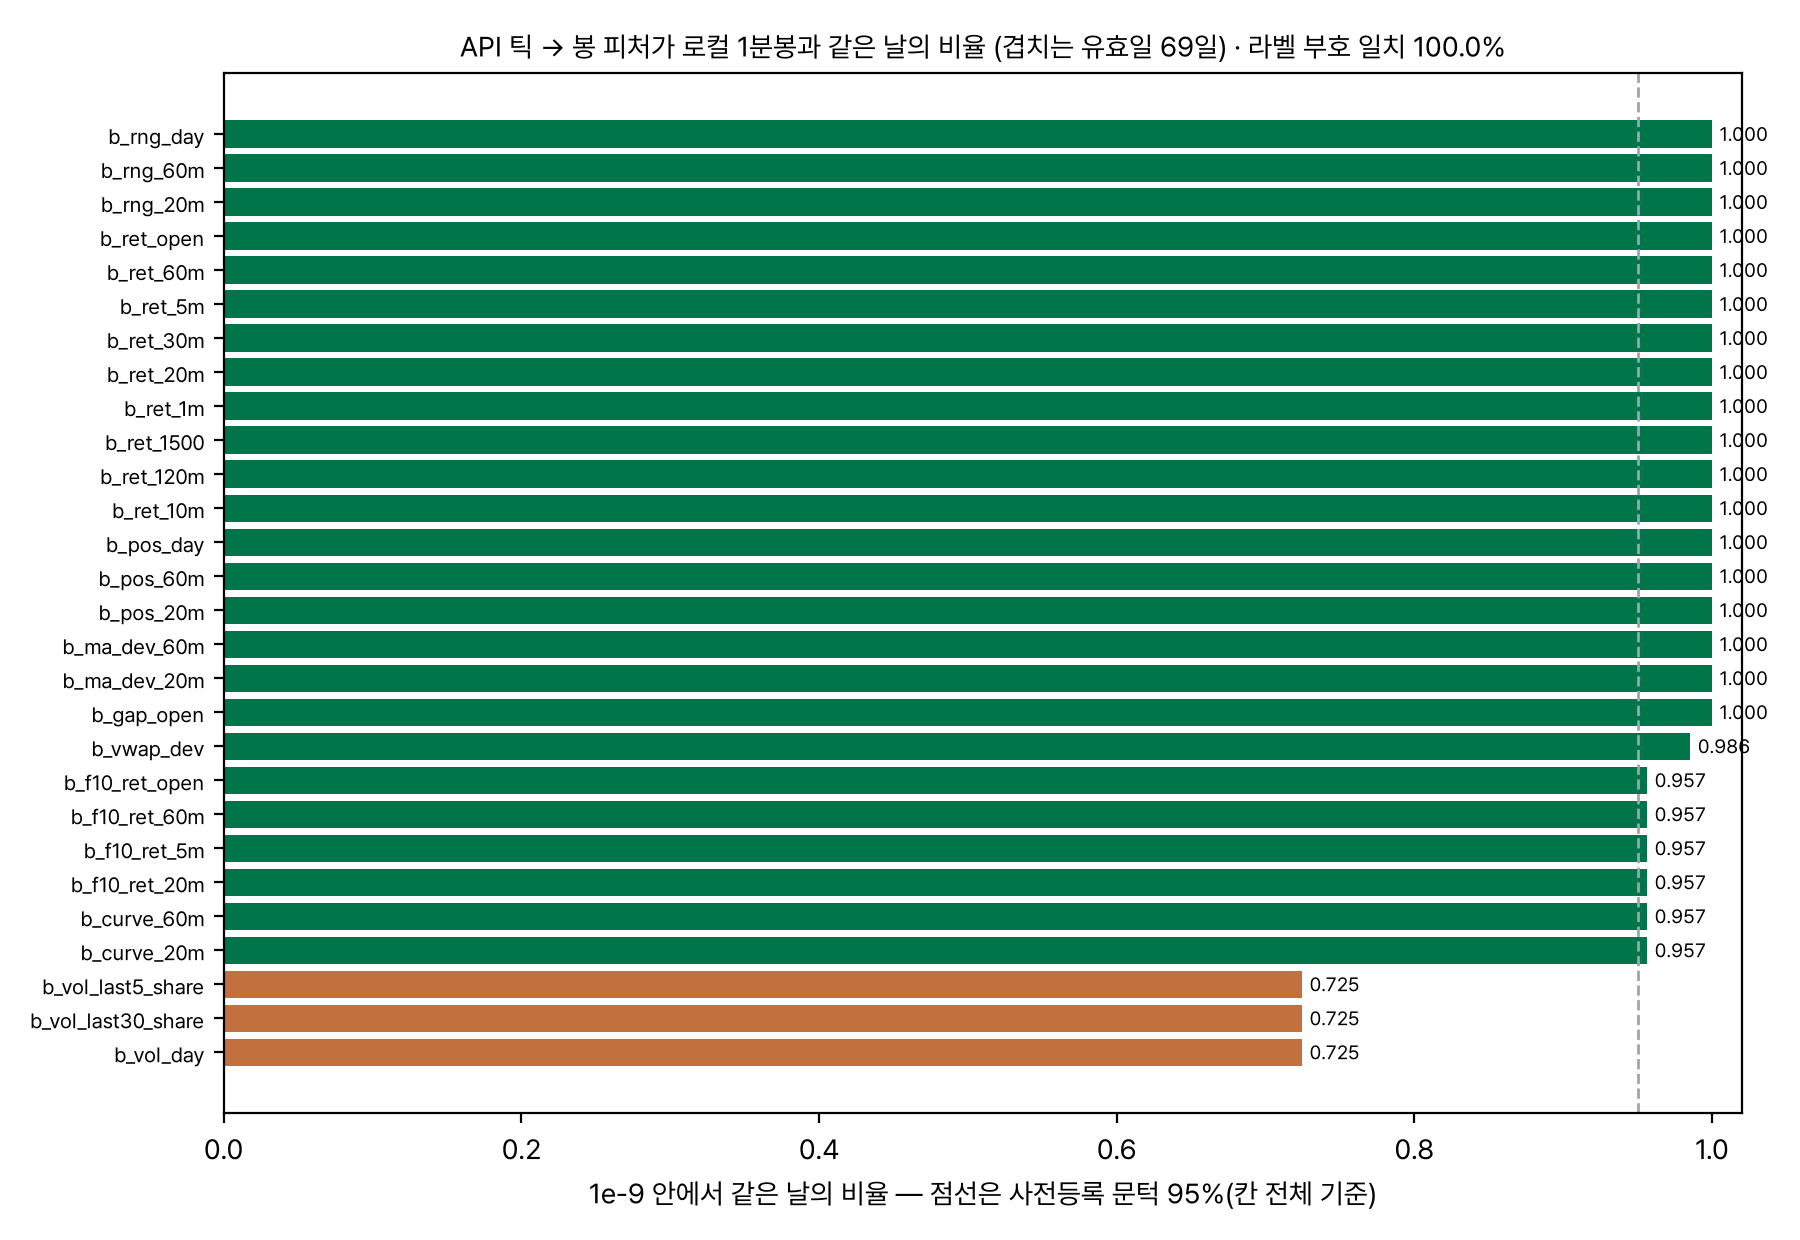
- API 틱으로 만든 라벨은 로컬 1분봉과 100% 같았다.
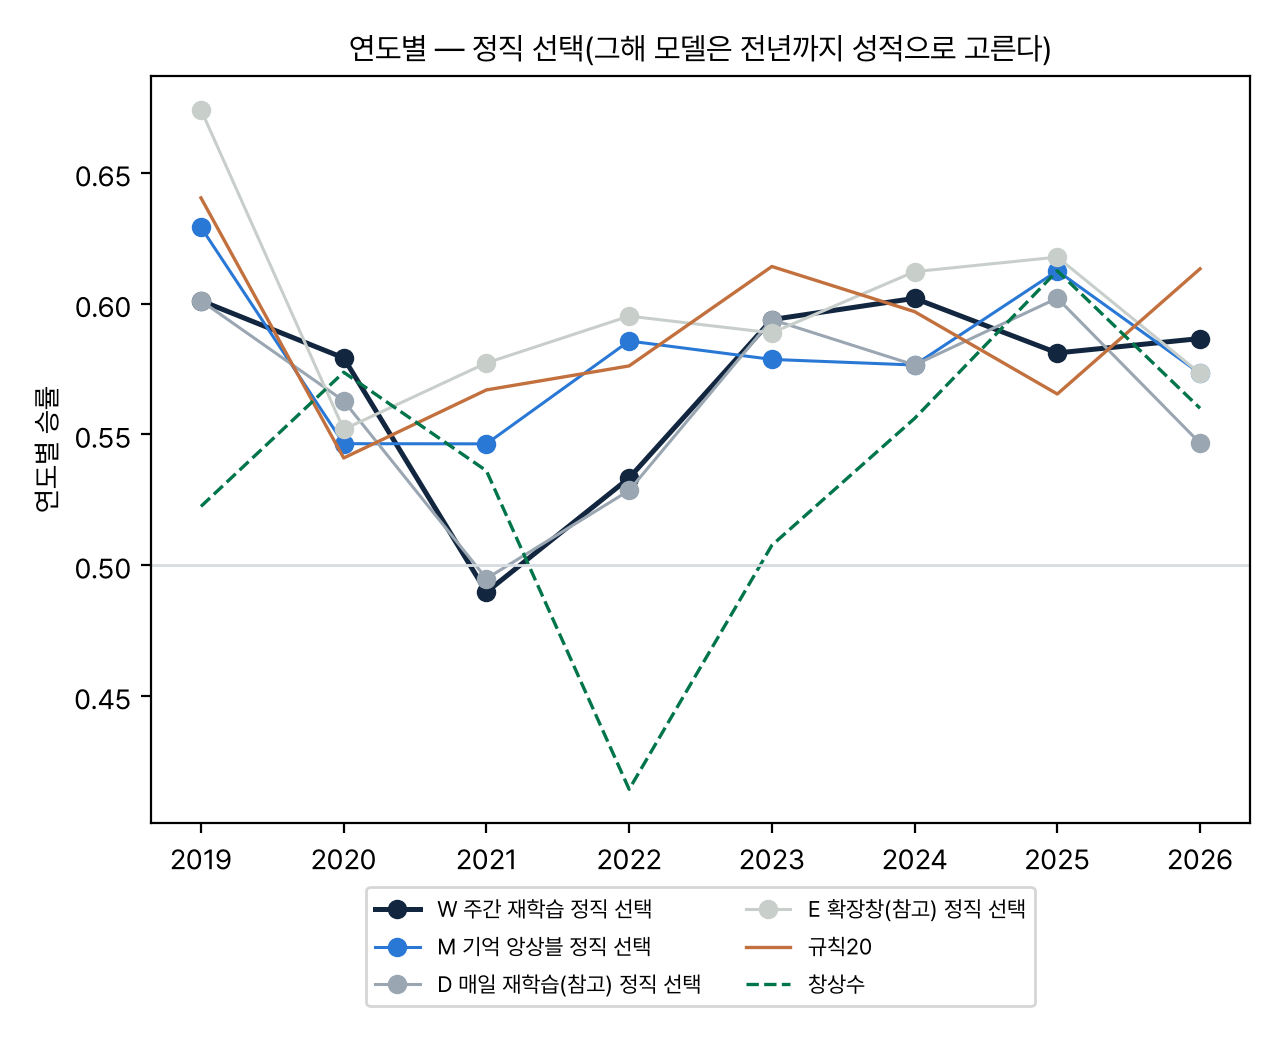
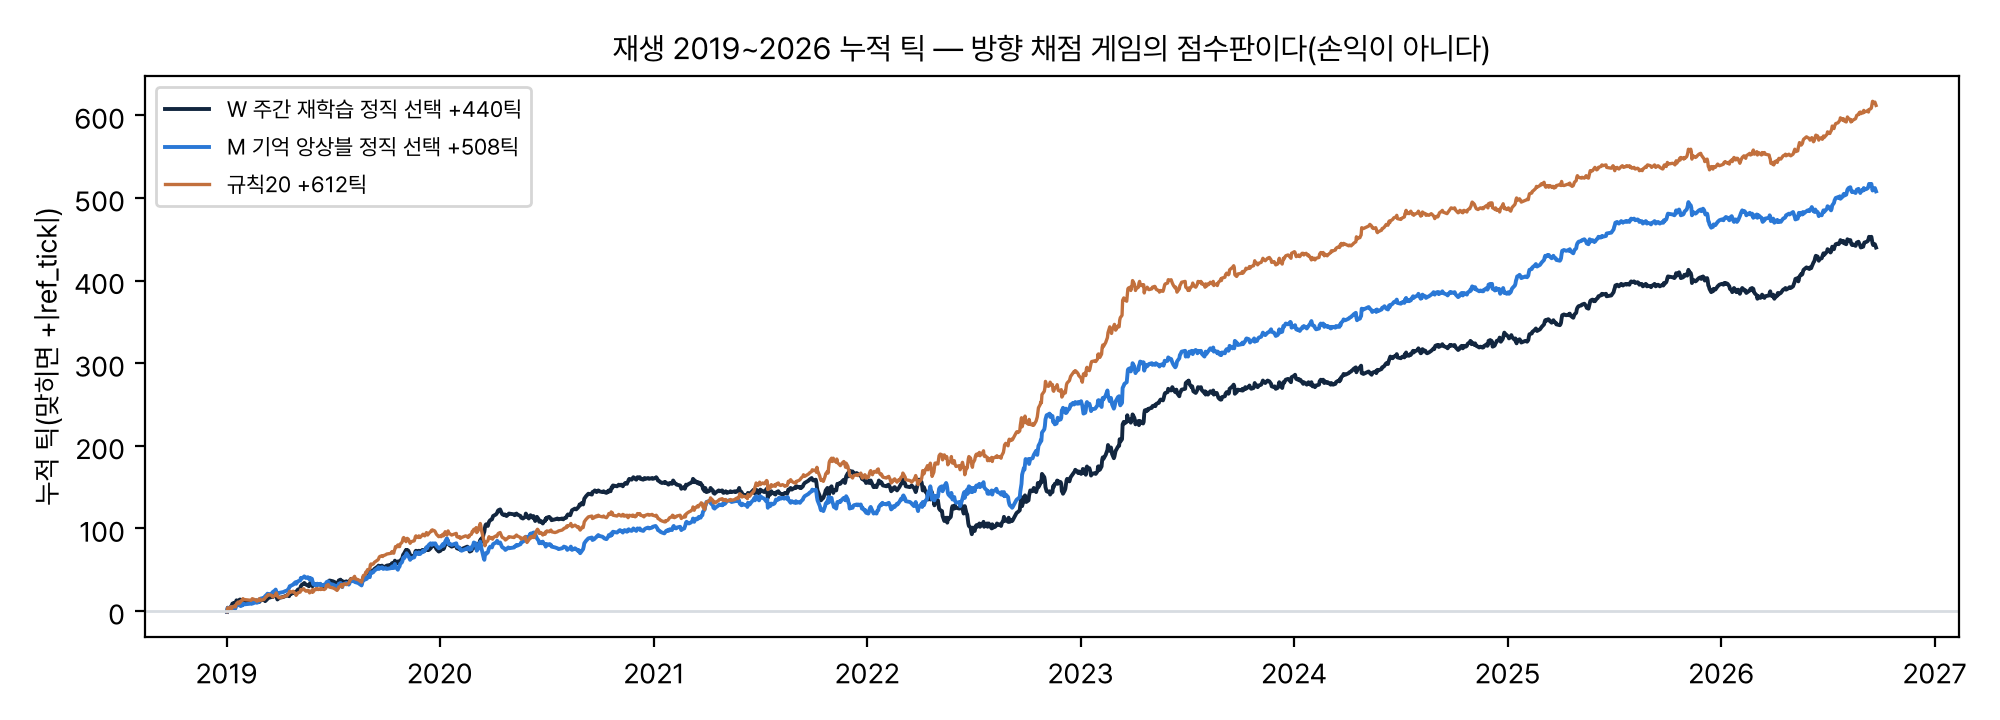
- 그 위에서 주간 재학습 설계를 2019~2026년에 재생하면 정직 선택 승률이 56.97% 로, 20분 모멘텀 규칙 58.84% 를 넘지 못한다(짝지은 McNemar p=0.2168). 매일 재학습으로 바꿔도 나아지지 않는다(56.30%).
- 그리고 4개월 틱 창 한 번이 하루 사용량 한도의 약 80% 를 쓴다.
무엇을 물었나
종속변수는 하나다. 15:34 까지의 정보로 그날 15:45 동시호가가 15:35 직전 가격보다 오르나 내리나. 바꾼 것은 데이터의 출처(인포맥스 데이터 API)와, 그 출처가 강제하는 학습 설계다.
- H34
- API 틱으로 만든 라벨과 봉 피처가 로컬 1분봉과 같다. 같으면 로컬 과거를 «그때 API가 줬을 데이터»로 써서 설계를 재생할 수 있다.
- H35
- 4개월 창으로 매주 다시 배운 모델(W)이 20분 모멘텀 규칙을 넘는다.
- H36
- 학습 표본이 60일 안팎이면 작은 모델(8열 로지스틱)이 큰 모델(52열 트리)을 넘는다.
- H37
- 원자료 없이 체크포인트 스냅샷으로 쌓은 기억(M)이 4개월 창보다 낫다.
- H38
- API 틱에만 있는 호가 잔량과 체결 성향이 동시호가 방향을 돕는다.
- H39
- 매일 재학습(D)이 주간 재학습(W)보다 낫다. 아니라면 주간 운영에 손해가 없다.
기호: 틱 = 국채선물 호가 한 칸(0.01). P_ref = 15:35:00 직전 마지막 체결가. P45 = 15:45:00 동시호가 체결가. ref_tick = P45 − P_ref(틱), 라벨은 그 부호이고 0 인 날은 뺀다. 규칙20 = 15:14→15:34 수익률의 부호. 창 상수 = 그날 기준 4개월 창 유효일의 다수 방향. 적응 상수120 = 직전 120 유효일의 다수 방향. 정직 선택 = 시험연도 이전 성적으로만 모델을 고른 값. McNemar = 같은 날의 적중/실패를 짝지어 한쪽만 맞힌 날 수(b:c)로 보는 검정. 재생 = 로컬 1분봉 과거로 API 설계를 다시 돌리는 평가.
API 가 주는 것과 한도
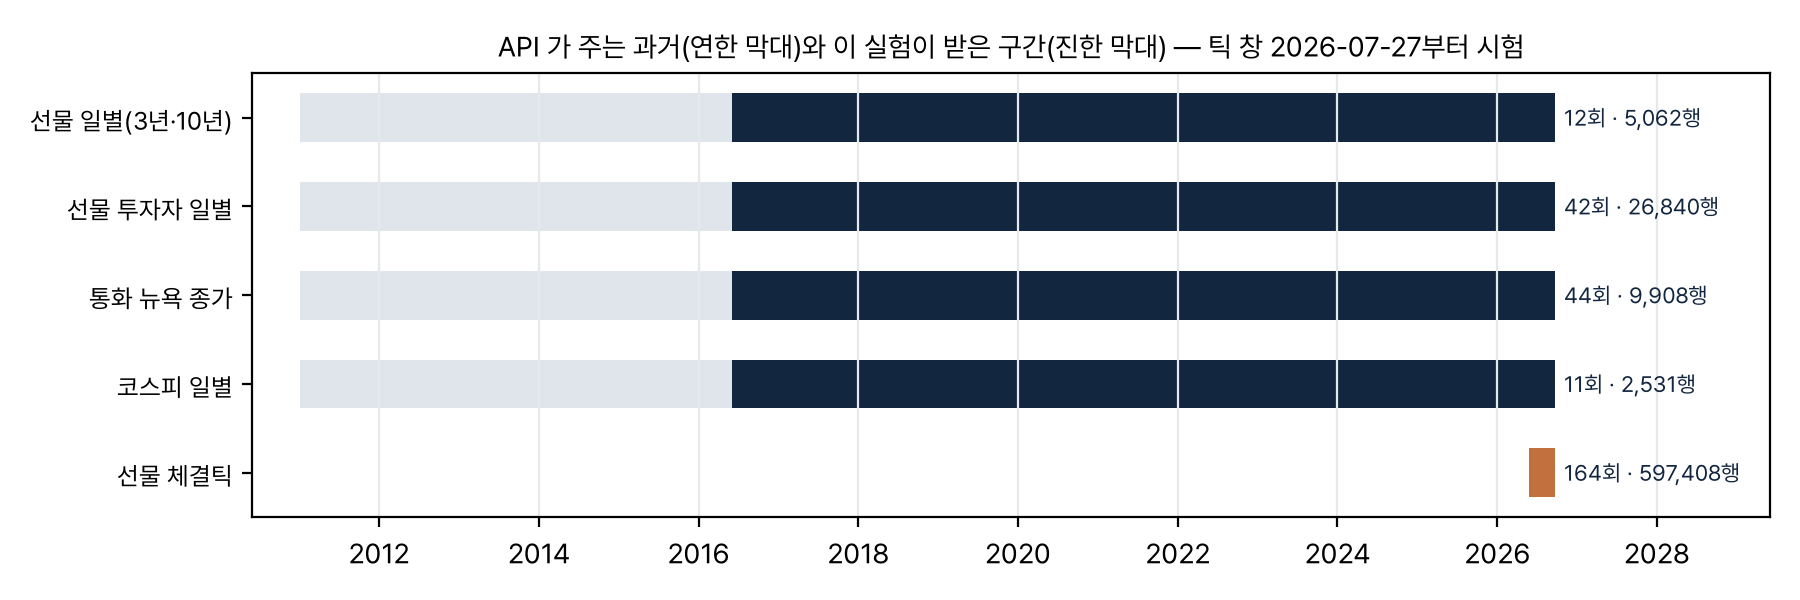
| 항목 | 값 |
|---|---|
| 플랜 | Standard — 하루 1,024MB · 분당 120회 |
| 거부 | access_limit(분당 초과, 1분 안에 풀림) ·
error timeout(범위가 큼 → 시간대 조각) · 일별 사용량 제한 초과(키 전체,
자정에 초기화) |
| 틱 창 | «오늘 − 4개월» 다음 날부터 |
| 세는 용량 | 받은 JSON 의 약 3배 — gzip 으로 받아도(전송 7%) 한도는 그대로 |
| 틱 창 한 번 | 164회 · 597,408행 · JSON 264MB → 세는 용량 약 800MB |
| 하루 예측 | 15회 · 8,492행 · JSON 3.6MB, 체결 지연 약 1초 |
이 한도 때문에 실행 전에 설계를 두 번 고쳤다. 개정 2 로 3년 선물 틱은 개장 2분과 13:30 이후, 10년 선물은 개장 2분과 14:00 이후만 받는다. 그래도 한 번에 다 받을 수 없어 정본 런은 틱을 이틀 자정에 나눠 받았다(받은 것은 메모리에만 두었다).
데이터셋
| 표 | 기간 | 행(유효일) | 봉·라벨 원천 | 일별 원천 | 쓰임 |
|---|---|---|---|---|---|
| API 표 | 2026-05-28 ~ 09-23 | 82 (70) | API 체결틱 | API | H34 · H38 · 서빙 체크포인트 |
| 재생 표 | 2016-12-14 ~ 2026-09-23 | 2,396 (1,849) | 로컬 1분봉(API 와 같은 가림) | API | H35~H37 · H39, 시험 2019~2026년 1,499일 |
| 블록 | 열 | 무엇 |
|---|---|---|
b_ 봉 | 28 | 3년 선물 1·5·10·20·30·60·120분 수익률, 시가 대비, 갭, 20·60분 레인지·위치·이평괴리, «일중»(개장 2분 + 13:30~15:34) 위치·레인지·거래량·VWAP 괴리, 15:00→15:34 수익률 / 10년 선물 5·20·60분·시가 대비, 3−10 커브 20·60분 |
d_ 일별 | 24 | 전일 3년 선물 수익률·5일 합·미스프라이싱(종가−이론가)·시장/이론 베이시스·미결제 변화·거래량 z·협의대량 비중 / 10년 수익률·3−10 수익률차 변화 / 투자자 순매수(외국인·증권·은행·투신· 보험·개인)·외국인 5일 / 뉴욕 종가 변화(달러지수·엔·유로·원) / 코스피 / 만기까지 일수·요일 |
m_ 미시구조 | 8 | 5호가·총호가 잔량 불균형, 호가 건수 불균형, 스프레드, 5·20·60분·하루 체결 성향 불균형 — API 틱에만 있다(재생 불가) |
학습 설계와 분할
| 설계 | 학습 표본 | API 로 가능한가 |
|---|---|---|
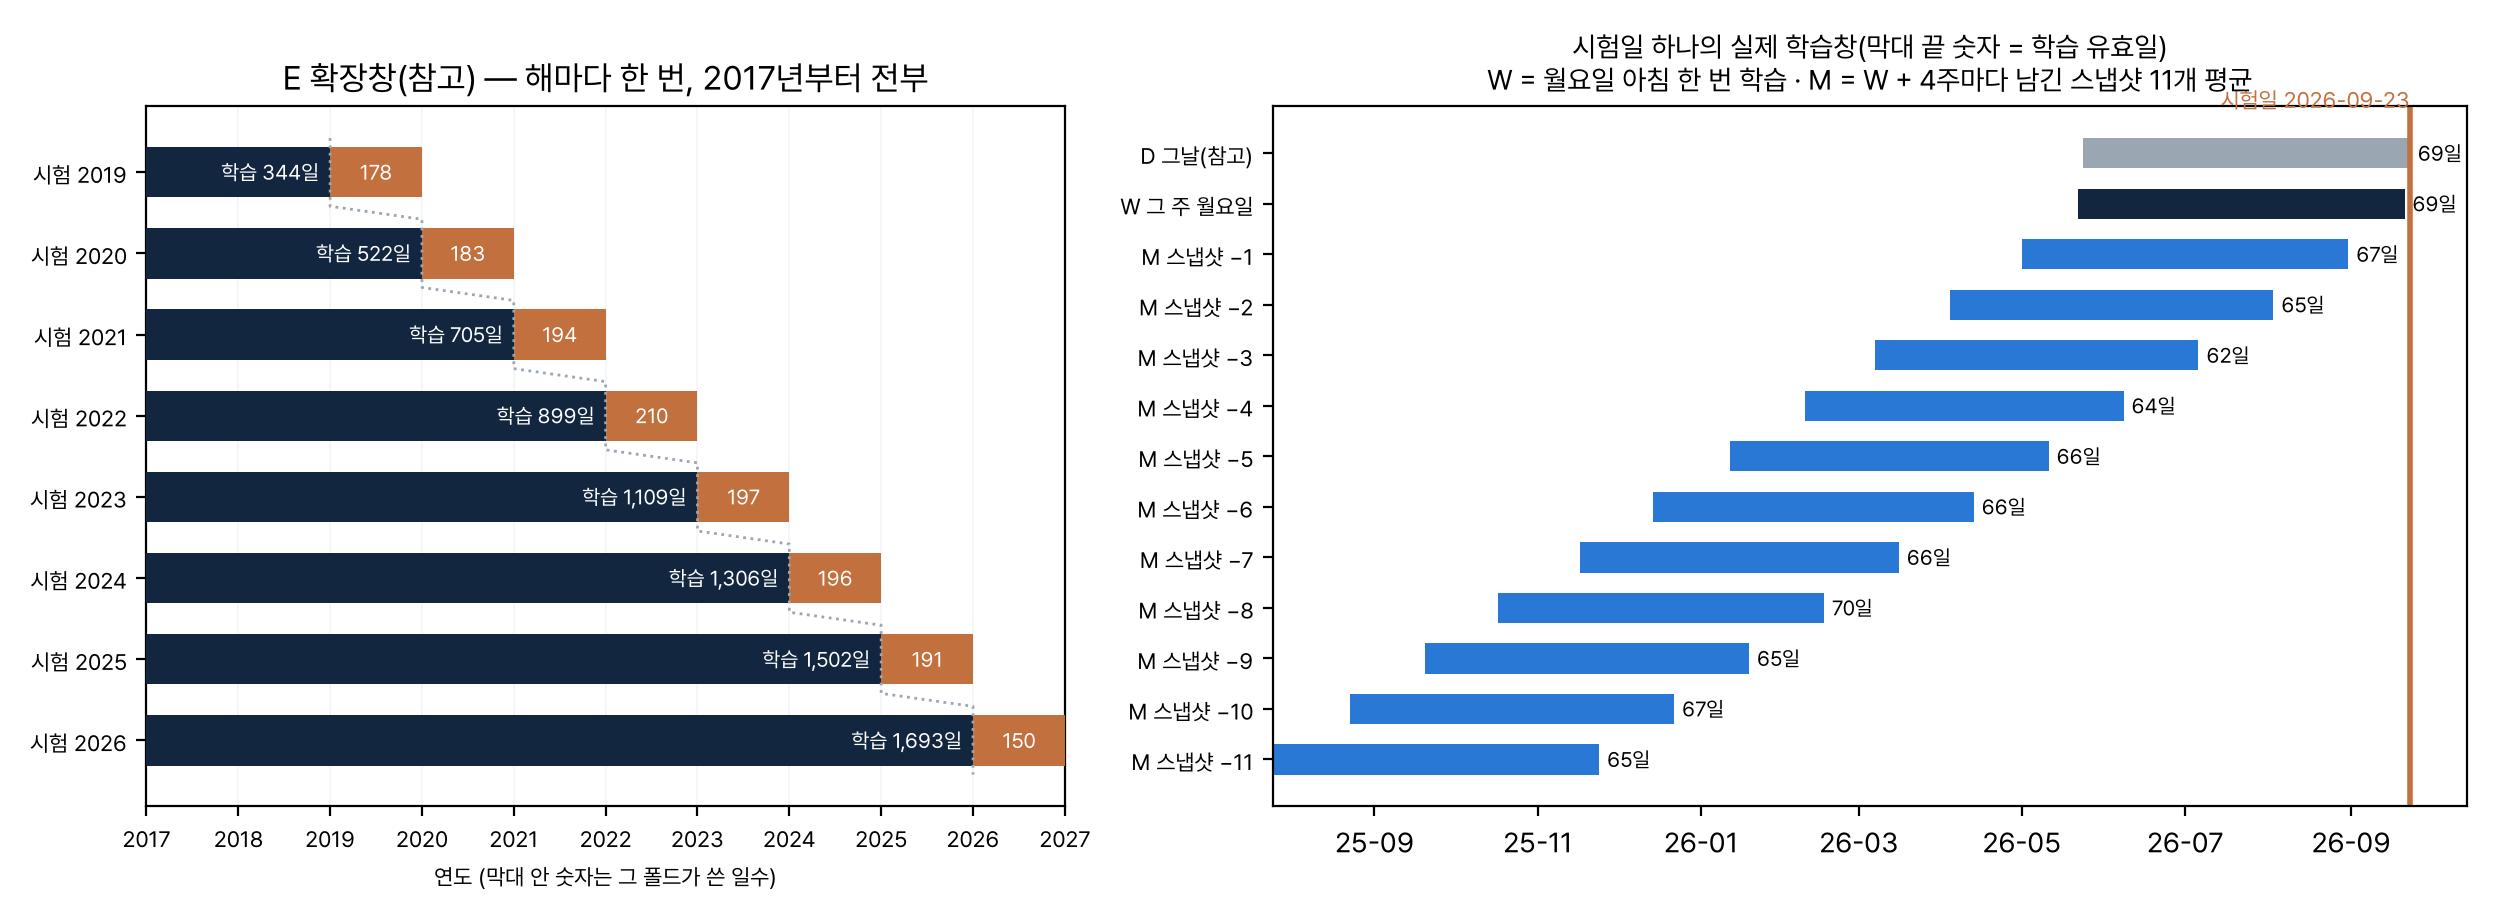
| W 주간 재학습 | 그 주 월요일 m 기준 (m − 4개월, m) 의 유효일. 월요일 아침 한 번 학습해 그 주 내내 쓴다 | 가능 — 월요일 API 가 주는 틱이 정확히 이 창 |
| D 매일 재학습(참고) | 그날 t 기준 (t − 4개월, t) | 가능하지만 매일 틱 창을 다시 받는다 |
| M 기억 앙상블 | W 모델을 4주마다 스냅샷으로 남겨, 그 주 W + 이전 스냅샷 11개의 확률 평균 | 운영하며 쌓인다(원자료 없이 약 1년 기억) |
| E 확장창(참고) | 시험연도 이전 전부(2017~), 해마다 한 번 | 불가 — 로컬 데이터가 있을 때의 참고선 |
모델
| 이름 | 피처 | 설정 |
|---|---|---|
log_s 작은 로지스틱 | 8열: b_ret_20m·b_ret_5m·b_pos_20m·b_pos_day·b_vwap_dev·b_curve_20m·b_ret_open·d_mis_prev | 중앙값 대치 → 표준화 → L2 로지스틱 C=1.0 |
log 로지스틱 | b_ + d_ 52열 | 중앙값 대치 → 표준화 → L2 로지스틱 C=0.1 |
et ExtraTrees | 52열 | 400그루 · 깊이 4 · 잎 최소 5 · max_features=√ |
lgb LightGBM | 52열 | 100그루 · 학습률 0.05 · 잎 7 · 자식 최소 10 · 행/열 표본 0.8 · L2 1.0 |
paper 1변수 회귀 | b_ret_1500 | 최소제곱 ref_tick = α + β·x, 방향 sign(α + β·x) |
et_m | 52열 + m_ 8열 | et 와 같다(API 창 전용, H38) |
아래 구조도는 서빙 체크포인트(API 유효일 70일, 2026-05-29~09-23 로 학습한 객체)에서 그렸다. 그리기 전에 런이 기록한 예측 경로 확률(9/21, 22, 23)을 API 에서 다시 받아 1e-9 로 재현했다.
작은 로지스틱 회귀 log_s — 서빙 모델
미리 고른 8열(마감 전 20·5분 수익률, 20분·일중 위치, VWAP 괴리, 3−10 커브 20분, 시가 대비, 전일 미스프라이싱)을 표준화해 L2(C=1.0) 로지스틱으로 상승 확률을 낸다. 4개월 창의 유효일은 60일 안팎이다 — 모수가 적은 모델이 과적합을 덜 한다는 가설(H36)의 앞쪽이다. 첫 시험연도의 사전등록 모델이기도 하다.
로지스틱 회귀 log
봉·일별 52열 전부를 표준화해 강한 L2(C=0.1) 로 묶은 로지스틱이다. 같은 선형 계열에서 열을 여섯 배 넣으면 어떻게 되는지 보는 짝이다.
ExtraTrees et
봉·일별 52열로 무작위 분기 결정트리 400그루(깊이 4·잎 최소 5·분기마다 √52≈7열 후보)를 키워 잎의 상승 비율을 평균한다. 시드 0·1·2 세 벌의 평균이다. 가설 H36 의 뒤쪽(큰 모델)이자, 미시구조를 더한 `et_m` 의 기준이다.
n 은 그 노드를 지난 학습 표본 수다.| 분기 위치 \ 피처 | d_wd | b_pos_day | b_pos_60m | b_f10_ret_5m | b_ret_20m | d_basis_theo_prev | b_rng_day | d_inv_for5_prev | d_inv_inv_prev | b_ret_30m | d_dte | b_ret_120m | b_gap_open | b_pos_20m | b_ret_60m | d_basis_mkt_prev | b_ret_1500 | b_ret_5m | b_f10_ret_20m | b_vwap_dev | b_curve_20m | b_ret_open | d_inv_bank_prev | d_kospi | d_ret5_prev | b_rng_20m | b_f10_ret_open | b_ma_dev_60m | d_inv_ind_prev | b_vol_last30_share | b_ma_dev_20m | b_rng_60m | b_f10_ret_60m | d_vol_z_prev | d_inv_ins_prev | d_ret10_prev | b_ret_1m | b_curve_60m | d_fx_usdkrw | d_inv_sec_prev | b_vol_day | d_curve_chg_prev | d_ret_prev | d_fx_usdjpy | d_inv_for_prev | b_ret_10m | b_vol_last5_share | d_block_share_prev | d_fx_eurusd | d_fx_dollar | d_mis_prev | d_oi_chg_prev | 합 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 깊이 0 (뿌리) | 11 | 15 | 15 | 11 | 14 | 6 | 20 | 12 | 20 | 16 | 10 | 11 | 8 | 7 | 17 | 9 | 12 | 8 | 16 | 10 | 10 | 6 | 5 | 5 | 2 | 10 | 11 | 13 | 4 | 9 | 10 | 8 | 6 | 5 | 11 | 2 | 1 | 6 | 2 | 1 | 2 | 2 | 2 | 2 | 0 | 3 | 2 | 1 | 2 | 0 | 3 | 4 | 398 |
| 깊이 1 | 33 | 22 | 22 | 26 | 28 | 16 | 16 | 23 | 19 | 17 | 16 | 19 | 14 | 19 | 15 | 22 | 9 | 17 | 23 | 14 | 21 | 15 | 14 | 8 | 19 | 16 | 17 | 7 | 13 | 8 | 8 | 9 | 15 | 7 | 5 | 10 | 7 | 7 | 8 | 7 | 3 | 5 | 6 | 11 | 8 | 12 | 5 | 6 | 5 | 7 | 4 | 5 | 688 |
| 깊이 2 | 40 | 33 | 33 | 26 | 15 | 24 | 24 | 18 | 17 | 23 | 26 | 21 | 22 | 24 | 21 | 22 | 19 | 10 | 12 | 18 | 13 | 19 | 20 | 27 | 12 | 18 | 10 | 15 | 19 | 15 | 14 | 11 | 7 | 18 | 11 | 16 | 16 | 15 | 14 | 18 | 15 | 18 | 14 | 8 | 15 | 8 | 10 | 9 | 10 | 6 | 12 | 4 | 885 |
| 깊이 3 | 35 | 20 | 18 | 20 | 24 | 34 | 18 | 22 | 17 | 15 | 19 | 19 | 24 | 18 | 15 | 15 | 26 | 28 | 8 | 17 | 14 | 18 | 19 | 12 | 18 | 6 | 11 | 12 | 11 | 13 | 12 | 16 | 15 | 13 | 15 | 13 | 16 | 11 | 13 | 11 | 14 | 9 | 12 | 12 | 9 | 7 | 9 | 10 | 9 | 10 | 3 | 6 | 791 |
| 분기 합 | 119 | 90 | 88 | 83 | 81 | 80 | 78 | 75 | 73 | 71 | 71 | 70 | 68 | 68 | 68 | 68 | 66 | 63 | 59 | 59 | 58 | 58 | 58 | 52 | 51 | 50 | 49 | 47 | 47 | 45 | 44 | 44 | 43 | 43 | 42 | 41 | 40 | 39 | 37 | 37 | 34 | 34 | 34 | 33 | 32 | 30 | 26 | 26 | 26 | 23 | 22 | 19 | 2,762 |
어느 깊이에서 어느 피처가 몇 번 갈랐나(그루 400개 합).
LightGBM lgb
봉·일별 52열로 잎 7개짜리 트리 100그루를 학습률 0.05 로 차례로 더하는 그래디언트 부스팅이다(행·열 표본 0.8, L2 1.0). 시드 세 벌의 평균이다. 배깅과 다른 방식(잔차를 줄여 가는 방식)의 트리 계열을 하나 둔다.
n 은 그 노드를 지난 학습 표본 수다.| 분기 위치 \ 피처 | d_inv_inv_prev | d_inv_ind_prev | b_f10_ret_5m | d_fx_usdjpy | d_inv_bank_prev | b_gap_open | d_vol_z_prev | b_rng_day | b_vol_last30_share | b_ret_60m | b_vol_last5_share | d_fx_usdkrw | b_f10_ret_20m | b_pos_day | b_vol_day | d_inv_for5_prev | b_ret_5m | b_rng_20m | d_kospi | b_f10_ret_open | b_pos_60m | d_block_share_prev | b_ret_120m | b_ret_open | d_basis_mkt_prev | d_fx_dollar | d_mis_prev | d_oi_chg_prev | d_ret_prev | d_basis_theo_prev | d_fx_eurusd | d_ret10_prev | d_wd | b_ret_10m | b_ret_1500 | b_rng_60m | d_curve_chg_prev | d_inv_ins_prev | d_inv_sec_prev | b_curve_60m | b_ret_20m | d_ret5_prev | b_curve_20m | b_f10_ret_60m | b_pos_20m | b_vwap_dev | d_dte | d_inv_for_prev | b_ma_dev_20m | b_ma_dev_60m | b_ret_1m | b_ret_30m | 합 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 깊이 0 (뿌리) | 8 | 17 | 9 | 2 | 5 | 3 | 5 | 7 | 6 | 4 | 3 | 2 | 6 | 4 | 1 | 0 | 4 | 1 | 0 | 2 | 2 | 0 | 1 | 0 | 3 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 2 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 100 |
| 깊이 1 | 12 | 4 | 9 | 8 | 9 | 6 | 5 | 3 | 3 | 4 | 6 | 3 | 1 | 4 | 3 | 4 | 1 | 3 | 3 | 0 | 1 | 6 | 3 | 4 | 2 | 2 | 1 | 3 | 4 | 2 | 2 | 4 | 3 | 3 | 1 | 1 | 1 | 1 | 2 | 1 | 0 | 0 | 0 | 1 | 1 | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 141 |
| 깊이 2 | 6 | 4 | 3 | 5 | 1 | 5 | 3 | 1 | 2 | 0 | 0 | 4 | 1 | 0 | 4 | 4 | 1 | 3 | 3 | 4 | 2 | 0 | 1 | 1 | 0 | 3 | 3 | 2 | 1 | 2 | 1 | 0 | 0 | 0 | 1 | 2 | 2 | 1 | 1 | 1 | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 80 |
| 깊이 3 | 2 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 1 | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 12 |
| 분기 합 | 28 | 25 | 21 | 15 | 15 | 14 | 14 | 11 | 11 | 9 | 9 | 9 | 8 | 8 | 8 | 8 | 7 | 7 | 7 | 6 | 6 | 6 | 5 | 5 | 5 | 5 | 5 | 5 | 5 | 4 | 4 | 4 | 4 | 3 | 3 | 3 | 3 | 3 | 3 | 2 | 2 | 2 | 1 | 1 | 1 | 1 | 1 | 1 | 0 | 0 | 0 | 0 | 333 |
| 손실 감소(gain) 몫 | 11.7% | 8.2% | 5.7% | 4.5% | 3.9% | 4.6% | 3.7% | 3.6% | 4.9% | 2.8% | 2.5% | 2.4% | 3.1% | 2.6% | 3.1% | 2.1% | 1.3% | 1.7% | 1.3% | 1.6% | 1.5% | 1.6% | 1.0% | 2.8% | 1.3% | 1.5% | 0.8% | 0.9% | 1.1% | 0.7% | 1.8% | 0.8% | 1.2% | 1.2% | 1.6% | 0.7% | 0.9% | 0.3% | 0.8% | 0.5% | 0.5% | 0.4% | 0.0% | 0.1% | 0.5% | 0.1% | 0.3% | 0.1% | 0.0% | 0.0% | 0.0% | 0.0% | 100% |
어느 깊이에서 어느 피처가 몇 번 갈랐나(그루 100개 합).
설명변수 하나짜리 회귀 paper
15:00→15:34 수익률 x 하나로 최소제곱 ref_tick = α + β·x 를 맞추고 sign(α + β·x) 를 방향으로 낸다. 확률이 아니라 부호다. 모수가 둘뿐인 가장 작은 학습 모델 — 작은 표본에서 무엇이 버티는지의 하한이다.
ExtraTrees + 미시구조 et_m
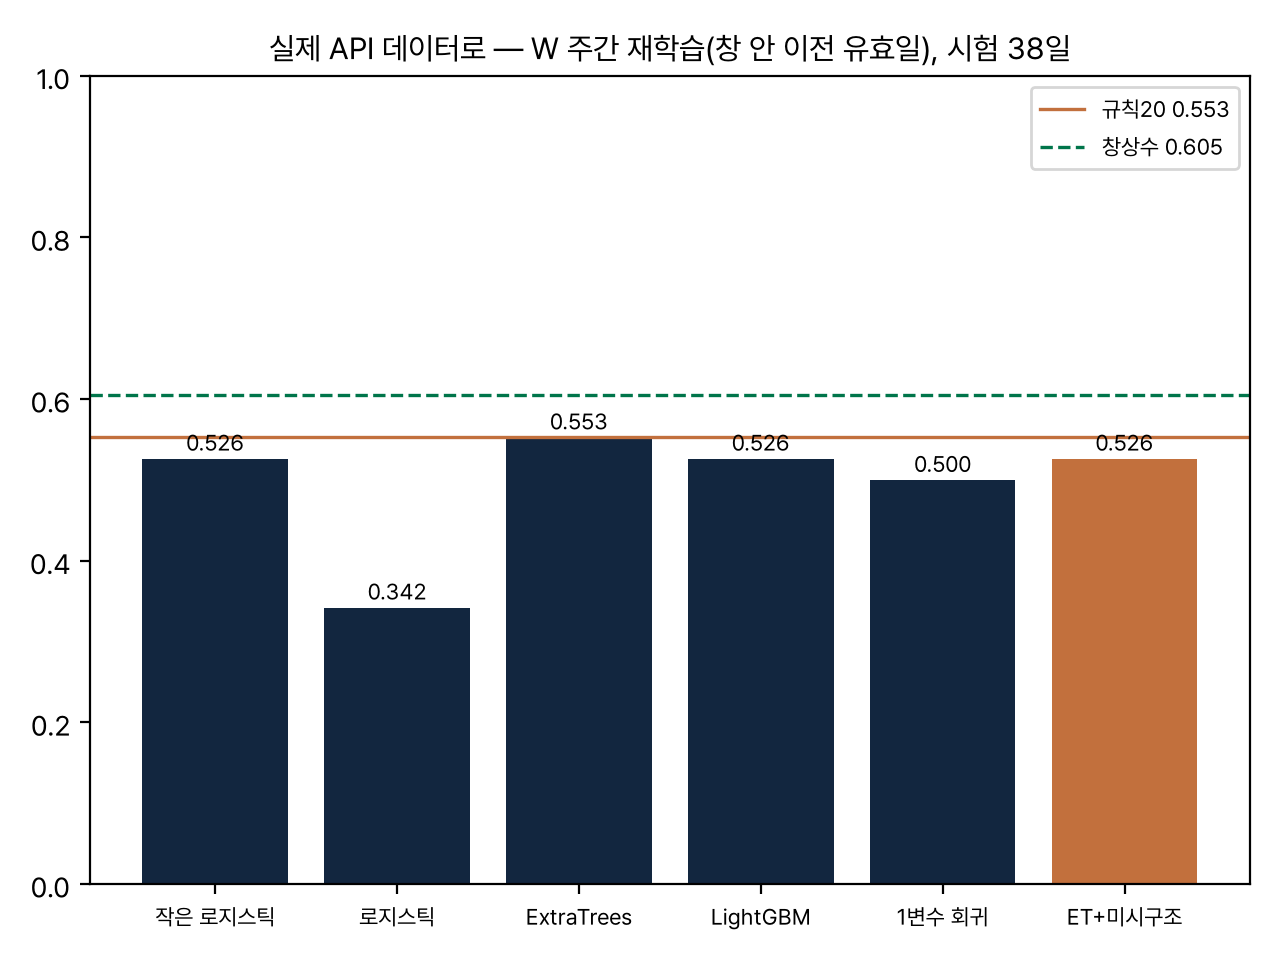
`et` 와 같은 설정에 API 틱에만 있는 8열(5호가·총호가 잔량 불균형, 호가 건수 불균형, 스프레드, 5·20·60분·하루 체결 성향 불균형)을 더한 60열 모델이다. 가설 H38 — 로컬 틱에 없어 과거 재생이 불가능하고 API 창에서만 잰다.
n 은 그 노드를 지난 학습 표본 수다.| 분기 위치 \ 피처 | d_wd | m_ob5_imb | b_pos_day | b_ret_60m | b_rng_day | b_f10_ret_5m | m_ob_imb | b_curve_20m | b_pos_60m | d_inv_inv_prev | b_gap_open | b_ret_20m | b_ret_120m | d_basis_theo_prev | b_ret_5m | m_cnt5_imb | b_f10_ret_20m | b_pos_20m | d_dte | b_vwap_dev | b_ret_1500 | b_ret_30m | b_f10_ret_open | b_vol_day | b_rng_20m | d_basis_mkt_prev | d_inv_for5_prev | b_ret_open | d_inv_bank_prev | b_vol_last30_share | b_rng_60m | d_inv_ind_prev | d_inv_sec_prev | b_curve_60m | b_ma_dev_20m | d_inv_for_prev | d_inv_ins_prev | d_kospi | d_block_share_prev | d_vol_z_prev | b_vol_last5_share | d_ret10_prev | b_f10_ret_60m | d_mis_prev | d_ret5_prev | b_ma_dev_60m | b_ret_1m | d_curve_chg_prev | d_ret_prev | d_fx_usdkrw | b_ret_10m | d_fx_dollar | d_fx_usdjpy | d_fx_eurusd | d_oi_chg_prev | m_aggr_20m | m_aggr_5m | m_aggr_60m | m_aggr_day | m_spread | 합 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 깊이 0 (뿌리) | 7 | 22 | 11 | 22 | 17 | 12 | 20 | 10 | 12 | 9 | 10 | 15 | 18 | 3 | 10 | 15 | 11 | 8 | 2 | 6 | 10 | 11 | 7 | 7 | 8 | 7 | 14 | 6 | 5 | 7 | 1 | 5 | 1 | 4 | 6 | 1 | 2 | 4 | 1 | 3 | 6 | 5 | 5 | 2 | 6 | 5 | 0 | 0 | 2 | 3 | 1 | 3 | 5 | 3 | 3 | 0 | 0 | 0 | 0 | 0 | 399 |
| 깊이 1 | 28 | 20 | 23 | 14 | 24 | 15 | 14 | 17 | 18 | 18 | 14 | 11 | 12 | 13 | 14 | 15 | 16 | 10 | 14 | 20 | 12 | 15 | 17 | 13 | 9 | 10 | 18 | 14 | 15 | 15 | 8 | 14 | 11 | 4 | 13 | 10 | 15 | 7 | 12 | 11 | 6 | 10 | 7 | 11 | 7 | 10 | 5 | 5 | 7 | 5 | 4 | 8 | 7 | 1 | 3 | 0 | 0 | 0 | 0 | 0 | 669 |
| 깊이 2 | 28 | 27 | 28 | 17 | 18 | 18 | 20 | 28 | 18 | 17 | 19 | 21 | 16 | 23 | 20 | 17 | 18 | 24 | 23 | 16 | 23 | 19 | 14 | 16 | 19 | 18 | 17 | 21 | 12 | 13 | 18 | 9 | 13 | 20 | 15 | 14 | 12 | 17 | 14 | 13 | 10 | 6 | 13 | 7 | 11 | 10 | 15 | 14 | 7 | 9 | 12 | 9 | 5 | 9 | 7 | 0 | 0 | 0 | 0 | 0 | 877 |
| 깊이 3 | 30 | 19 | 13 | 21 | 13 | 24 | 15 | 11 | 18 | 22 | 20 | 16 | 16 | 23 | 17 | 13 | 14 | 17 | 20 | 15 | 11 | 11 | 17 | 19 | 18 | 19 | 5 | 8 | 16 | 11 | 15 | 14 | 17 | 13 | 7 | 14 | 10 | 10 | 10 | 9 | 13 | 14 | 9 | 14 | 10 | 7 | 11 | 12 | 15 | 13 | 10 | 5 | 7 | 6 | 4 | 0 | 0 | 0 | 0 | 0 | 761 |
| 분기 합 | 93 | 88 | 75 | 74 | 72 | 69 | 69 | 66 | 66 | 66 | 63 | 63 | 62 | 62 | 61 | 60 | 59 | 59 | 59 | 57 | 56 | 56 | 55 | 55 | 54 | 54 | 54 | 49 | 48 | 46 | 42 | 42 | 42 | 41 | 41 | 39 | 39 | 38 | 37 | 36 | 35 | 35 | 34 | 34 | 34 | 32 | 31 | 31 | 31 | 30 | 27 | 25 | 24 | 19 | 17 | 0 | 0 | 0 | 0 | 0 | 2,706 |
어느 깊이에서 어느 피처가 몇 번 갈랐나(그루 400개 합).
결과
| 설계 | 승률 | 누적 | 해마다 고른 모델 |
|---|---|---|---|
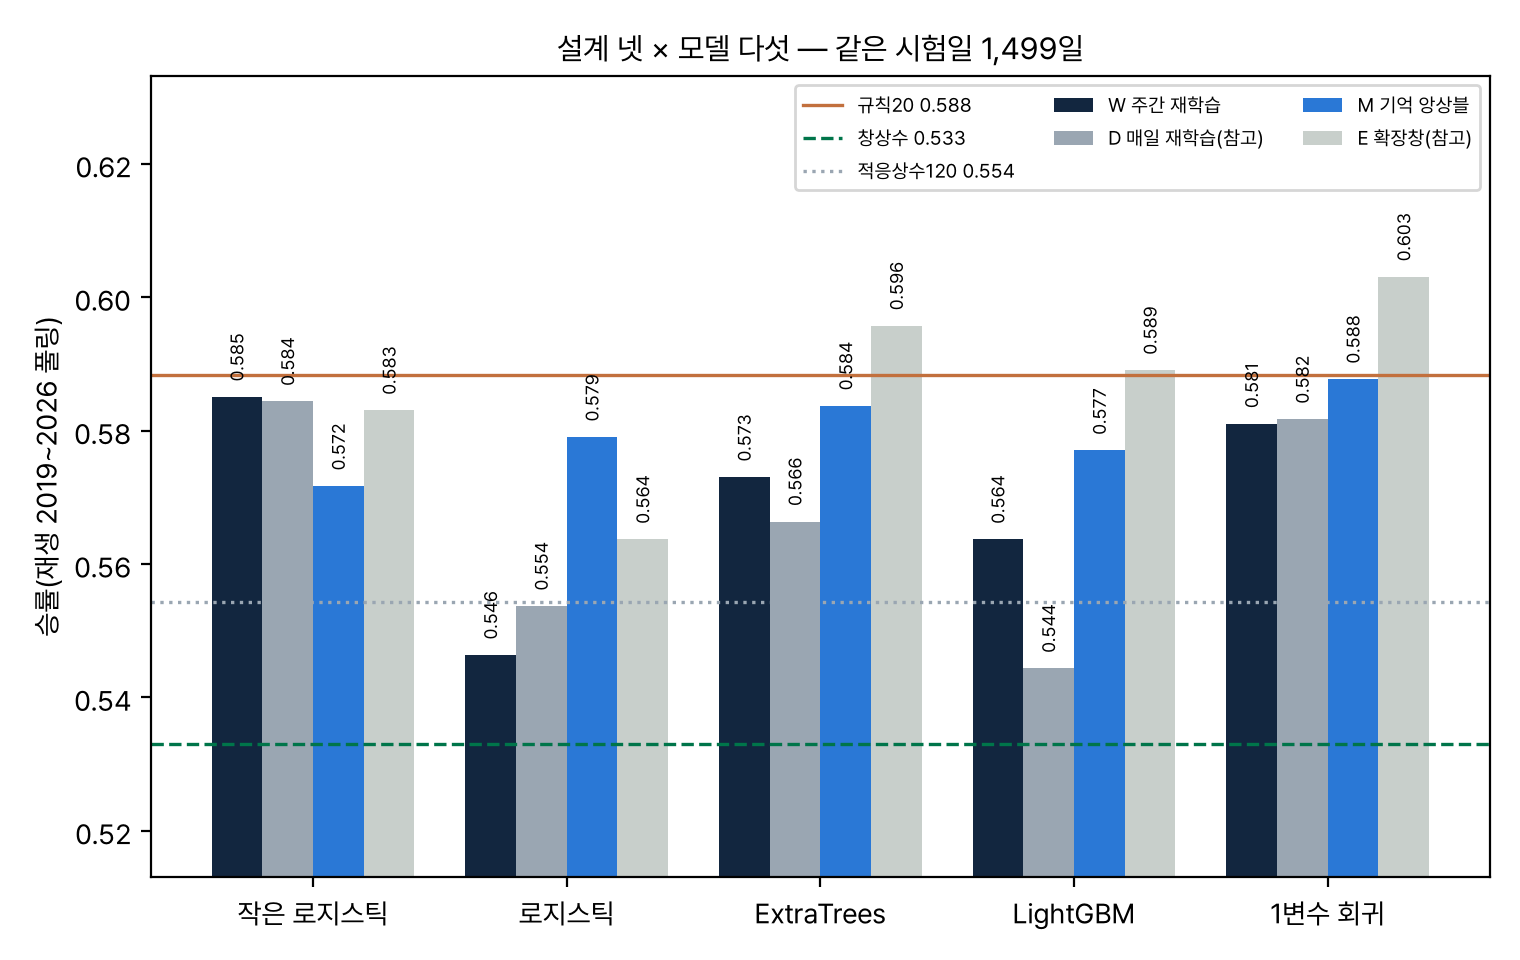
| W 주간 재학습 | 0.5697 | +440틱 | log_s → et ×2 → paper → log_s → paper ×2 → log_s |
| D 매일 재학습 | 0.5630 | +400틱 | W 와 같고 2026 만 paper |
| M 기억 앙상블 | 0.5811 | +508틱 | log_s → log ×4 → paper ×3 |
| E 확장창 | 0.5991 | +626틱 | log_s ×2 → paper ×6 |
| 규칙20 | 0.5884 | +612틱 | — |
| 창 상수 | 0.5330 | +48틱 | — |
| 적응 상수120 | 0.5544 | +274틱 | — |
가설별로 읽기
| # | 비교 | 앞 vs 뒤 | b:c | p | 판정 |
|---|---|---|---|---|---|
| H34 | API 틱 ↔ 로컬 | 라벨 100% · 칸 96.1% | — | — | 지지 |
| H35 | W 정직 ↔ 규칙20 | 0.5697 vs 0.5884 | 225:253 | 0.2168 | 미지지 |
| H36 | W log_s ↔ W et | 0.5851 vs 0.5730 | 185:167 | 0.3649 | 미지지 |
| H37 | M 정직 ↔ W 정직 | 0.5811 vs 0.5697 | 214:197 | 0.4300 | 미지지 |
| H38 | API W et_m ↔ et | 0.5263 vs 0.5526 (38일) | 0:1 | 1.0 | 판정 불가 |
| H39 | D 정직 ↔ W 정직 | 0.5630 vs 0.5697 | 51:61 | 0.3952 | 미지지 |
- 4개월 창으로 배운 모델은 규칙 수준에 머문다. 학습 유효일 60~70일로 배울 수 있는 것이 «마감 전 모멘텀» 정도이고 규칙20 이 그것을 공짜로 준다. 가장 좋은 주간 모델(작은 로지스틱 58.51%)도 규칙 아래다.
- 작고 단순한 모델이 조금 낫다. 작은 로지스틱과 1변수 회귀가 52열 모델보다 높지만 유의하지 않다.
- 기억을 늘리면 나아지는 방향이다. M(+1.14%p)과 E(+2.94%p) 모두 W 보다 높다. API 만으로는 M 을 운영하며 쌓는 길뿐이다.
- 주간 재학습으로 잃는 것은 없다(H39). 매일 재학습이 오히려 0.67%p 낮다.
- 주간 재학습은 창 상수는 유의하게 넘는다(0.5697 vs 0.5330, 242:187, p=0.0091).
대회 모델과 운영
- 서빙 체크포인트
checkpoints/serving.joblib=log_s(W 재생 풀링 1위 0.5851), API 유효일 70일로 학습. 예측 경로 동등성: 9/21, 22, 23 을 그날만 다시 받아 만든 피처와 확률이 학습 표와 같다(0.171395, 0.197325, 0.549428). - 예측:
infer11.py predict: 15:34 직후 그날 틱을endTime=153400으로 받는다(약 11MB). - 재학습:
infer11.py train --out …: 월요일 아침. 세는 용량 약 800MB 라 하루 한도의 80% 를 쓰고, 같은 키를 쓰는 배치의 장중 수급 수집과 겹친다. 이틀에 나눠 받기, 플랜 상향, 받는 시간대 축소 중 하나가 필요하다. - 규칙20 을 넘지 못했으므로 대회 제출 대장에는 올리지 않았다.
한계
재생은 로컬 1분봉을 «그때 API가 줬을 것»의 대리로 쓴 것이다(거래량 계열 일치율 72.5%). «일중» 봉 피처는 개장 2분 + 13:30 이후에서 잰 것이라 하루 전체로 잰 값과 다르다. API 창 38일은 판정에 쓰기에 짧다. 레짐별 분해는 하지 않았다. 누설 카나리아(피처 하나의 부호가 기저율을 10%p 넘게 맞히는가)는 재생과 API 모두 0건이다.
산출물
results/20260928_000523_api/metrics.json: 지표, 판정, 동등성, API 사용량 원장results/20260928_000523_api/per_day.parquet: 날짜별 예측 확률(원자료 아님)results/20260928_000523_api/checkpoints/: API 데이터로만 학습한 체크포인트 7개code/:api11(수집, 한도 대기),feat11(봉, 라벨, 피처),data11,models11,infer11(예측, 재학습), 그림