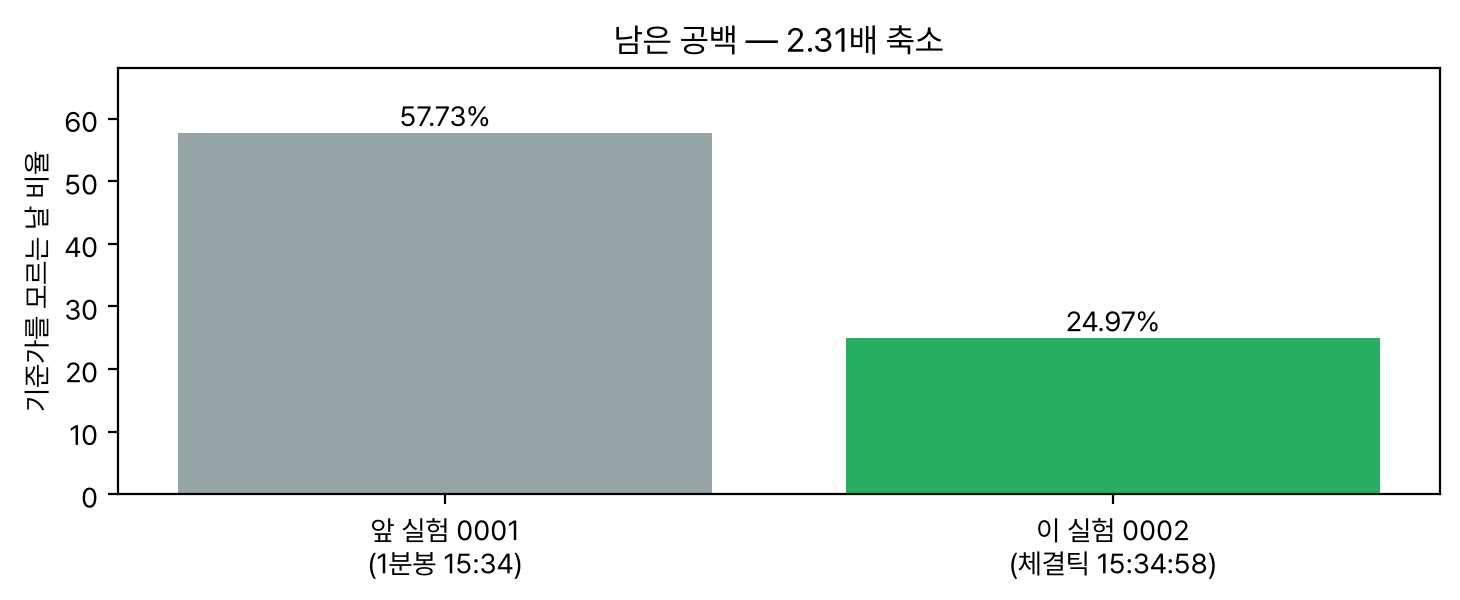
이 실험의 가치는 실패한 방식에 있다. 설계의 전제 — 기준가를 관측하면 제출 시점이 만든 격차가 해소된다 — 는 실제로 성립했다(격차가 57.73%에서 24.97%로 축소). 그러나 그것이 적중률로 이어지지 않았다. 즉 축소된 불확실성이 예측 가능한 부분이 아니었다. 이번에는 사전 등록한 상수 기준선이 그 사실을 처음부터 드러냈다.
가설과 결론
- 가설
- 체결틱을 사용하면 15:34:58 까지 관측할 수 있으므로 채점 기준가를 거의 아는 상태에서 방향을 직접 분류할 수 있다. 그러면 선행 실험(0001)이 회귀로 메우려 했던 제출 시점 격차가 제거되어 적중률이 선행 실험을 상회한다.
- 결론
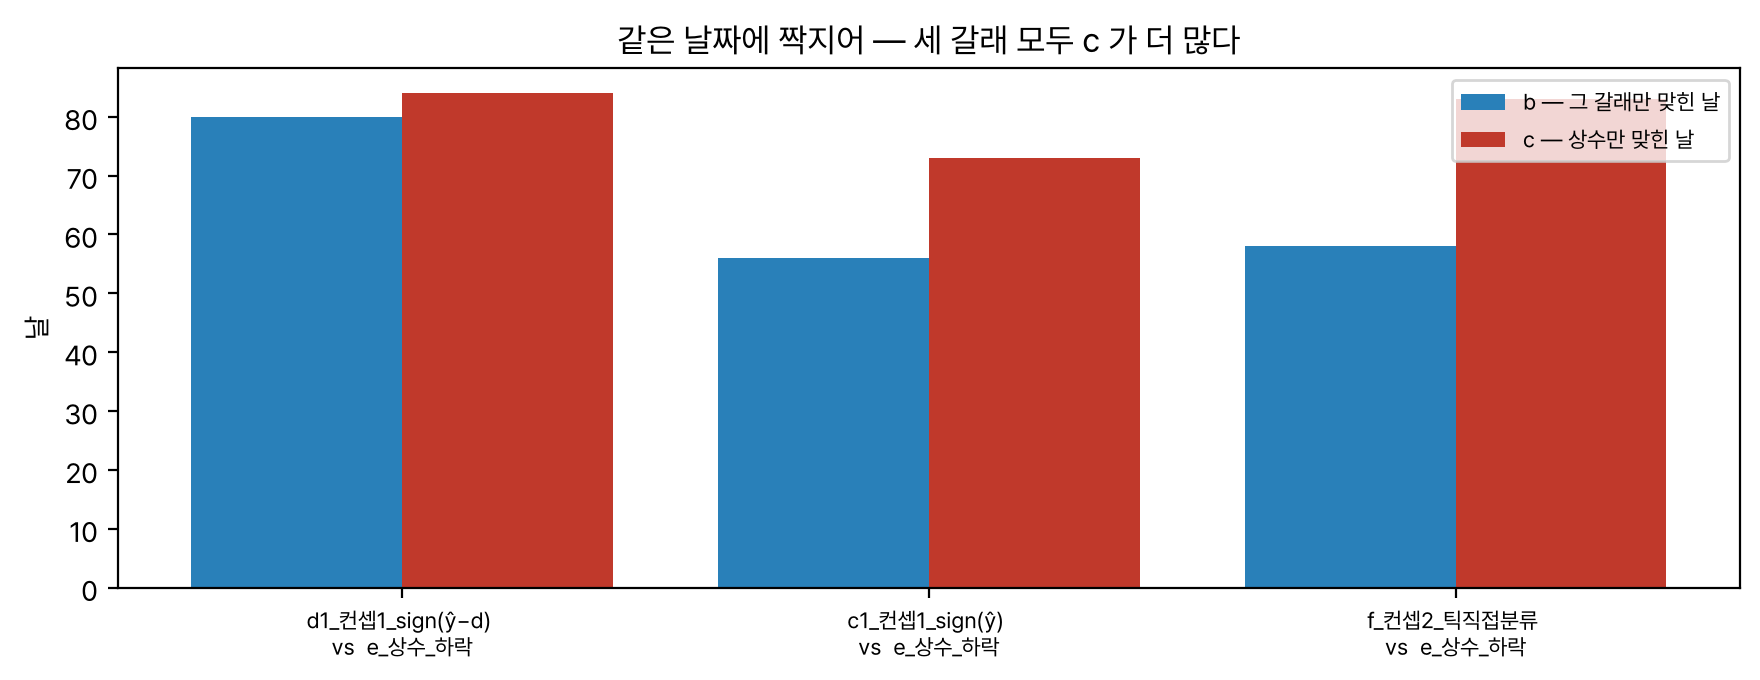
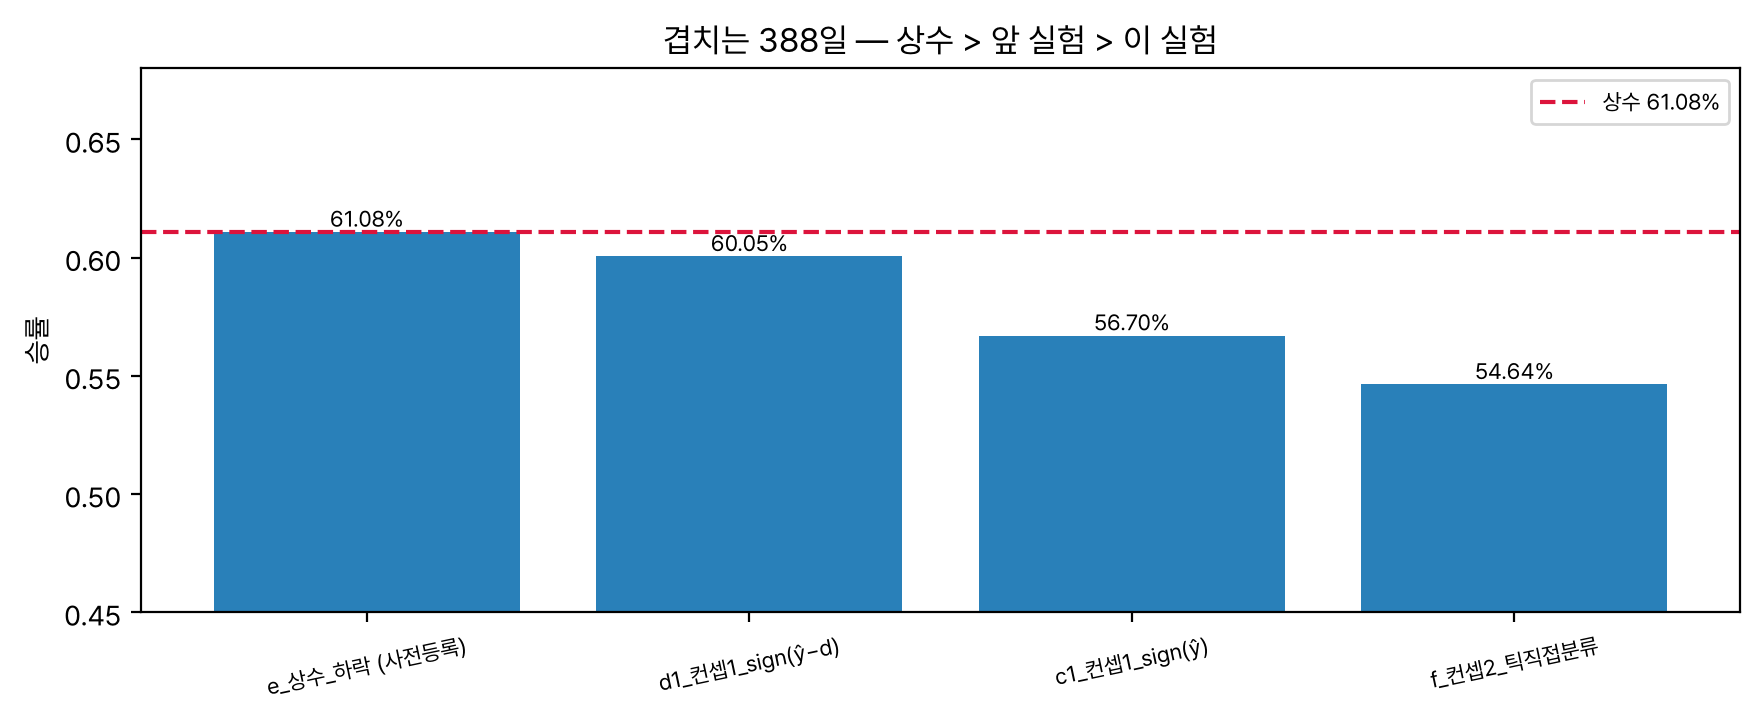
- 미지지. 격차는 실제로 축소됐으나(57.73% → 24.97%, 2.31배) 적중률은 54.64% 로 선행 실험(60.05%)에도, 사전 등록한 상수 기준선(61.08%)에도 미치지 못했다. 기저율 추정에 의존하지 않는 동일 날짜 짝지은 검정에서도 상수 대비 −6.44%p (b=58, c=83, p=0.043)다. 가설이 예측한 것과 방향 자체가 반대다.
- 부수 결론
- 사전 등록한 판정 기준 셋이 모두 구조적으로 통과 불가능한 형태였다(미결제약정 완전 일치 · 시드 분산의 2배 · 갈리는 날 각자 50% 초과). 사전 등록은 값을 미리 정하는 것만이 아니라 그 기준이 판정 능력을 갖는지를 미리 확인하는 것까지 포함해야 한다.
용어 사전
선행 실험(0001)과 중복되는 항목도 있으나 여기서 다시 정의한다 — 이 문서 하나만으로 읽히게 하기 위해서다.
- 동시호가
- 장 마지막에 주문을 모아 한 가격으로 체결하는 방식. 3년 국채선물은 15:45 에 이 방식으로 당일 종가가 확정된다.
- 틱(tick)
- 가격의 최소 변동 단위. 이 상품은 0.01 포인트가 1틱이다.
- 체결틱 (trade tick)
- 체결이 일어날 때마다 한 줄씩 쌓이는 기록(시각·가격·수량 등). 1분봉이 1분을 한 줄로 요약한 것이라면, 체결틱은 개별 거래 단위다.
- 호가
- 매수·매도 의사로 제출된 주문의 가격과 수량. 이 실험이 사용하는 체결틱 표에는 호가가 없다 — 따라서 생성 가능한 피처가 제한된다.
- 틱규칙 (tick rule)
- 호가 정보가 없을 때 체결이 매수 주도인지 매도 주도인지 직전 체결가와 비교해 추정하는 방법. 상승이면 +1, 하락이면 −1.
- 미결제약정
- 아직 청산되지 않고 남아 있는 선물 계약 수. 증가는 신규 포지션 유입, 감소는 청산으로 해석한다.
- P_ref (기준가)
- 대회 채점의 출발점. 15:35 직전 마지막 체결가.
- P45
- 정답 가격. 15:45 동시호가로 확정된 당일 종가.
- P_obs_3458
- 이 실험이 제출 시점에 실제로 보는 값 — 15:34:58 까지의 마지막 체결가. 기준가와 동일하지 않다(차이는 뒤에서 실측한다).
- 0틱 무효일
- 정답이 0틱이라 방향이 정의되지 않는 날. 학습·채점에서 제외하되 건수는 항상 함께 보고한다.
- 기저율 · 다수 클래스
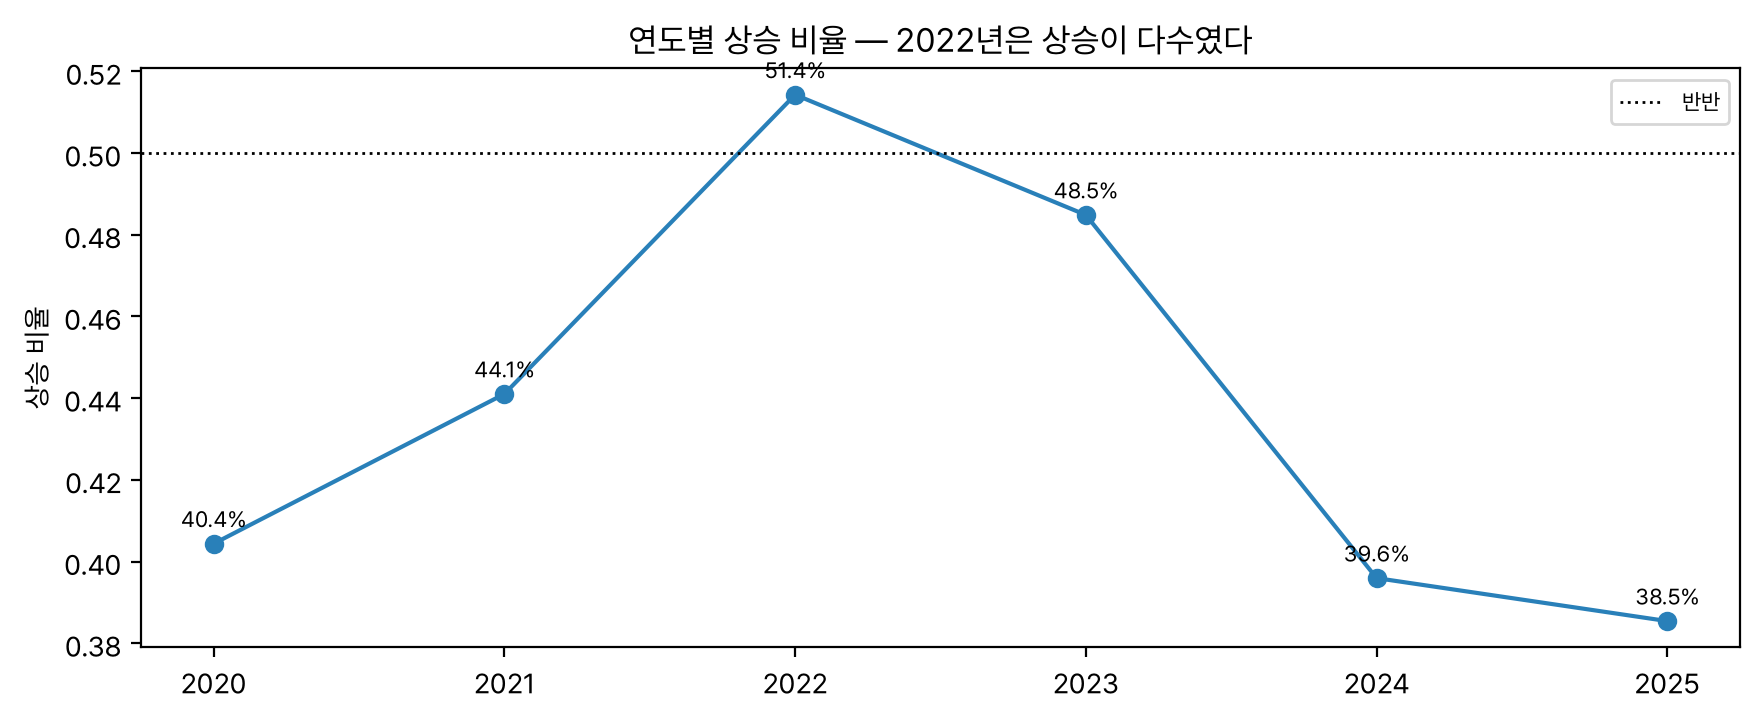
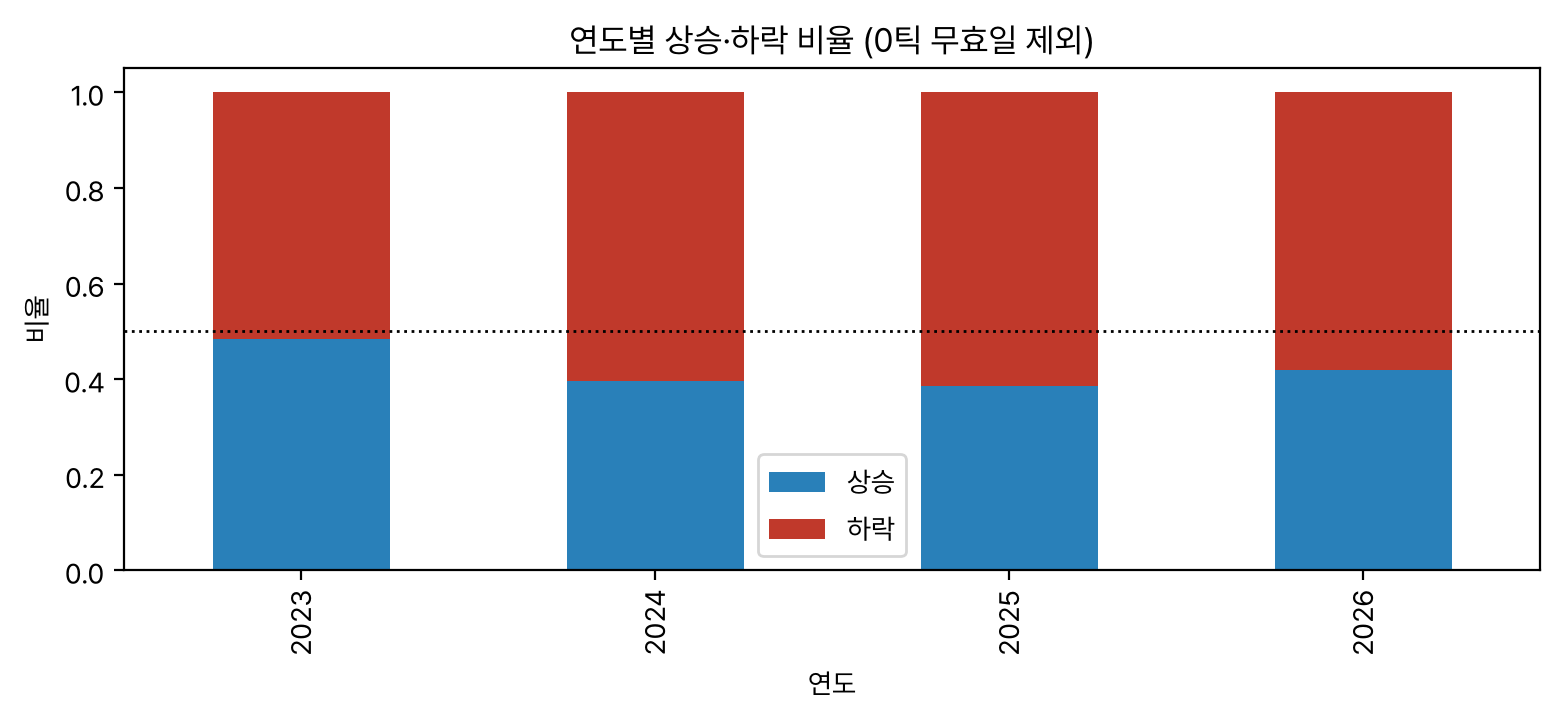
- 해당 기간에 상승한 날의 비율이 기저율이고, 더 많은 쪽이 다수 클래스다. 예컨대 상승일이 39%면 다수 클래스는 “하락”이며, 매일 하락이라고만 답해도 61%를 맞힌다.
- 상수 기준선
- 학습 없이 매일 같은 방향만 제출하는 갈래. 여기서는 “매일 하락”. 모델이 이 수준을 넘지 못하면 학습의 의미가 없다.
- 사전 등록
- 실험 실행 전에 판정 기준과 설정을 파일에 고정하는 것. 결과를 확인한 뒤 유리한 방향으로 기준을 변경하는 일을 막는다.
- McNemar 검정
- 두 방식을 동일 날짜에 짝지어 비교하는 방법. “둘 다 맞힌 날”과 “둘 다 틀린 날”은 제외하고 한쪽만 맞힌 날의 개수만 비교한다. 기저율을 추정할 필요가 없으므로 이 실험의 판정 근거로 사용한다.
- b · c
- McNemar 표에서 b는 그 갈래만 맞힌 날 수,
c는 상수 기준선만 맞힌 날 수.
b < c이면 상수가 더 우수하다는 뜻이다. - 난수 시드
- 학습에 무작위 요소가 있을 때 그 난수를 고정하는 값. 시드를 바꿔 반복 실행하면 결과의 변동 폭을 알 수 있다.
- 워크포워드 검증
- 과거 구간으로 학습하고 그 다음 해로 시험하기를 해마다 반복하는 평가 방식. 미래 정보가 학습에 유입되는 것을 막는다.
- 적중률
- 방향을 맞힌 날의 비율. 이 대회에는 비용·수수료 개념이 없으므로 손익이 아니라 적중률이 성과 지표다.
- 누적틱
- 맞힌 날은 +, 틀린 날은 − 부호로 정답 크기(틱)를 합산한 값. 적중률이 같아도 변동이 큰 날을 맞혔는지 구분하기 위해 함께 보고한다.
- 이항검정 p값
- “무작위(적중률 50%)였더라도 이 정도 성적이 우연히 나올 확률”. 작을수록 우연으로 설명하기 어렵다. 이 문서의 p값은 McNemar 검정을 제외하면 전부 단측이며, 양측인 경우 표에 그렇게 표기했다.
선행 실험과의 관계
선행 실험(0001)은 15:34 시점의 1분봉까지만 관측하고 그 이후 1분의 변화를 회귀로 추정해 보정하려다 실패했다 — 모델 오차(2.99틱)가 보정 대상(약 1틱)의 세 배였다.
이 실험은 접근을 바꾼다. 격차를 추정으로 메우는 대신 관측으로 없앤다 — 체결틱을 사용하면 15:34:58 까지 볼 수 있기 때문이다. 대가는 표본 길이다: 1분봉 9년 대신 체결틱 2년을 쓰고, 그 대신 시간 해상도를 분에서 초로 높인다.
데이터 요약
| 표 | 무엇 | 기간 · 크기 | 해상도 | 쓰임 |
|---|---|---|---|---|
선물3년_체결틱 |
3년 국채선물 체결 기록 (mficc 덤프, CSV 29조각) | 2023-01-02 ~ 2026-08-13 873일 · 5,654,218건 |
체결 1건 = 1행 시각은 초 단위 |
피처 |
price_data_f3y_1m_raw |
3년 국채선물 1분봉 (인포맥스 단말) | 같은 기간의 899 거래일 | 1분 | 라벨(정답) — 선행 실험과 동일한 코드로 생성 |
futures_issuance_info |
선물 종목별 거래개시일·최종거래일 | 상장 전 종목 | 종목 단위 | 당일 근월물 선택 |
체결틱 표의 성질 — 실측한 네 항목
| 성질 | 실측 내용 | 대응 |
|---|---|---|
| 열 구성 | 일자·시간·가격·수량·금액·미결제약정 —
호가가 없고 종목코드도 없다 |
호가 불균형 계열 피처가 원리적으로 불가능하다. 매수·매도 주도는 틱규칙으로만 추정한다 |
| 정렬 | 하루 안이 대체로 시간 역순인데 873일 중 112일(12.8%)이 그마저 깬다 | 적재 시 항상 재정렬한다 — 원본 순서를 신뢰하면 방향 판정이 통째로 뒤집힌다 |
| 같은 초의 순서 | 초 단위라 한 초에 여러 체결이 들어간다 | 원본 순서를 복원하는 2차 정렬 키를 추가했다(없으면 해당 초의 가장 이른 체결을 마지막으로 오인한다) |
| 장 마감 뒤 행 | 873일 전부에 컷오프 이후 행이 있고
871일에 15:45:00 대량 체결이 있다 |
그 체결가가 곧 정답이다 — 아래 “정답 누설 차단” 절 참조 |
표본 선정 절차
| 단계 | 잔여 일수 | 제외 사유 |
|---|---|---|
| 1분봉이 존재하는 날 (라벨 생성 가능일) | 899 | — |
| − 0틱 무효 | 728 | 정답이 0틱이라 방향이 정의되지 않는 날 171일 (19.02%) |
| − 체결틱이 없는 날 | 705 | 덤프에 해당 일자가 없거나 비어 있어 피처를 생성할 수 없다 |
| = 평가 표본 (2024–2025) | 388 | 2023 은 학습에만 사용 |
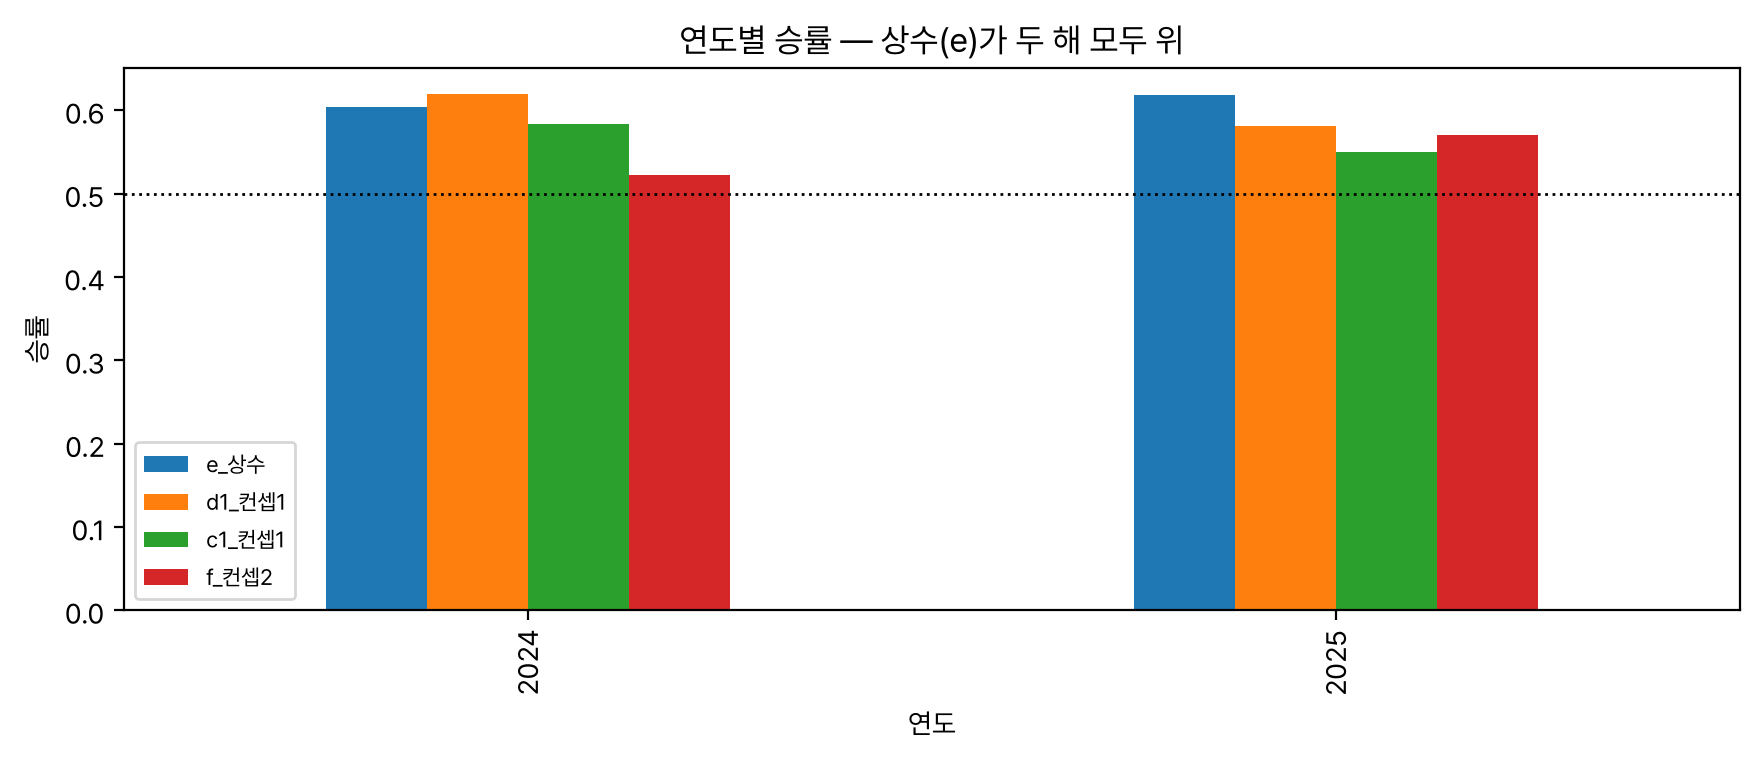
연도별 표본: 2023년 197 · 2024년 197 · 2025년 191 · 2026년 120(미사용).
기준가 관측 수준의 검증
설계의 전제를 먼저 검증한다. “거의 안다”가 정량적으로 얼마인가? 관측 경계를 어디에 두느냐에 따라 답이 달라지며, 세 경계는 서로 다른 질문에 답한다.
| 경계 | 기준가와 정확히 같은 날 | 1틱 이내 | 최대 차이 | 이 수치가 답하는 질문 |
|---|---|---|---|---|
| 아무 필터 없이 그날 마지막 행 | 19.36% | 53.2% | 18틱 | (동시호가 체결에 오염된 값 — 사용하지 않는다) |
15:34:58까지 = 모델이 보는 값 | 75.03% | 99.8% | 2틱 | 제출 시점에 기준가를 얼마나 아는가 |
15:35:00 직전 = 진짜 기준가 경계 | 100.00% | 100% | 0틱 | 이 틱 표가 1분봉과 같은 계약인가 |
873일 전수 대조.
맨 아래 100.00%(873일 전부, 최대 차이 0틱) 는 체결틱 표와 1분봉이 동일 계약임을 확정한다(다른 만기로 대조하면 3.94%로 떨어진다). 다만 모델이 실제로 관측하는 값은 가운데 75.03% 다 — 이 실험은 기준가를 아는 것이 아니라 거의 아는 것이며, 격차를 제거한 것이 아니라 축소했다.
정답 누설 차단
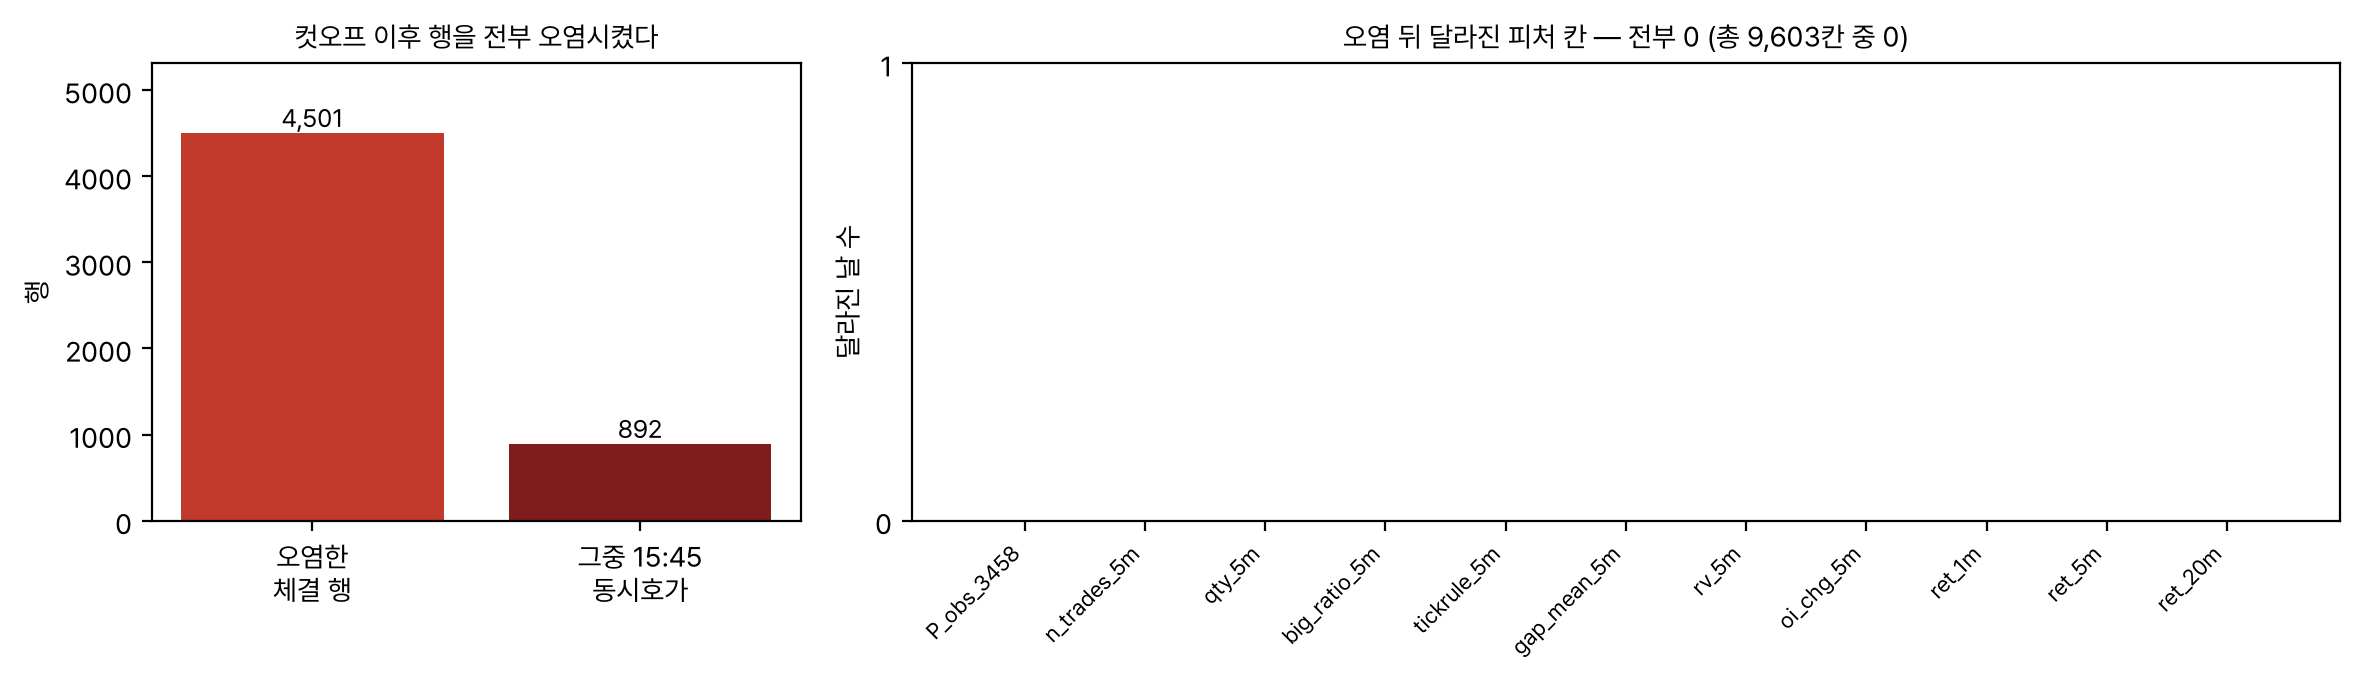
체결틱 873일 전부에 컷오프 이후 행이 있고,
871일에 거래량이 큰 15:45:00 체결이 있다. 그 가격은 1분봉의
15:45 종가, 즉 정답과 0틱 일치 99.89%(870/871)다 — 실제 동시호가
체결이다. 원래 계획서는 하루치만 확인하고 “체결틱 표에 동시호가 체결이
없다”고 기술했다. 피처가 이 행을 한 번이라도 흡수하면 정답을 직접
관측하는 것이므로 실험 전체가 무효가 된다.
따라서 컷오프 함수를 하나로 통합하고, 피처 생성 경로가 반드시 그 함수를 거치도록 했다. 그리고 그 가드를 실제로 되돌려 터뜨려 봤다.
피처 구성
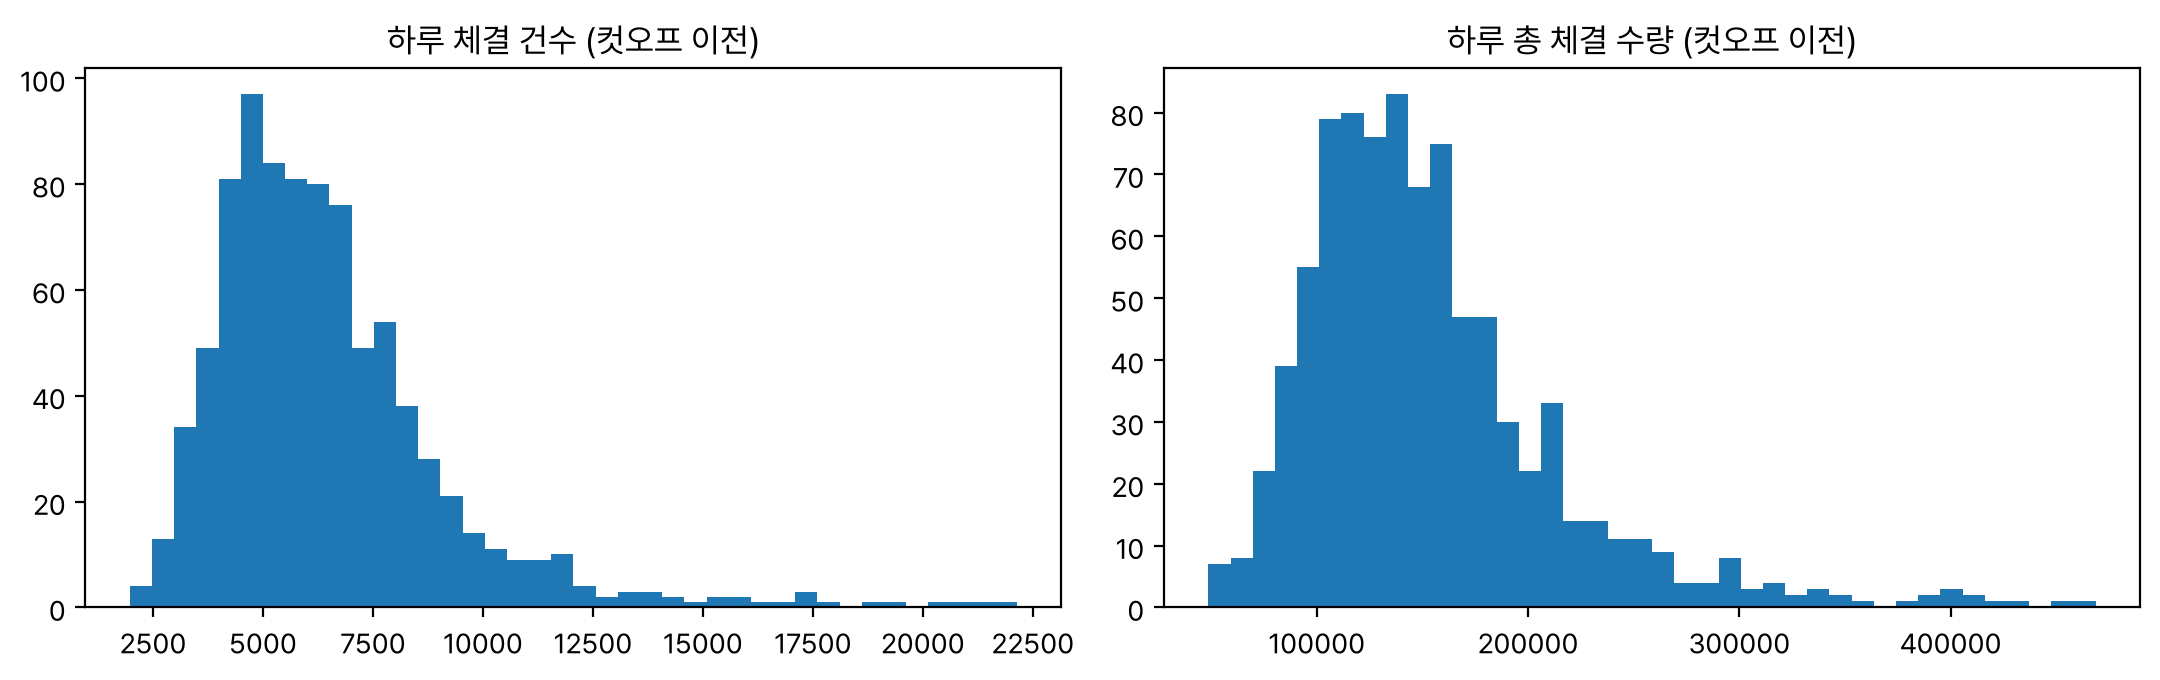
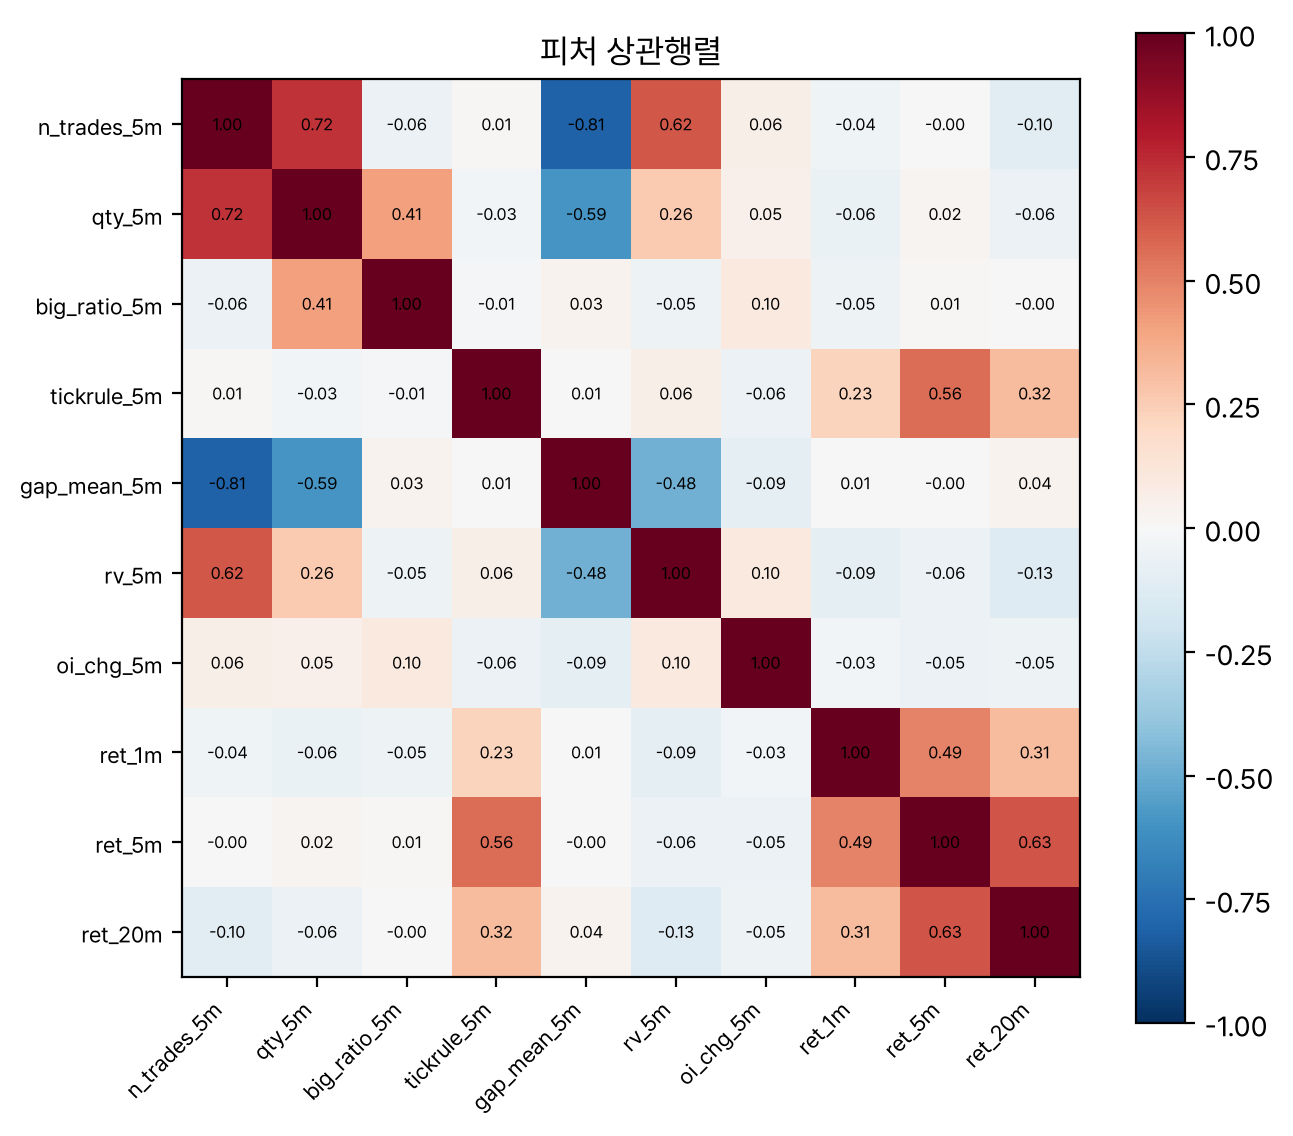
컷오프 이전 체결만 집계해 하루당 값을 생성한다. 생성되는 열은 11개지만
모델에 넣는 것은 아래 10개다 — P_obs_3458 은 제외한다.
| 이름 | 정의 |
|---|---|
n_trades_5m · qty_5m | 마지막 5분의 체결 건수와 총 수량 |
big_ratio_5m | 5분 수량 중 대량 체결(100계약 이상)이 차지하는 비율 |
tickrule_5m | 5분 동안 틱규칙 부호의 평균 — +1 에 가까울수록 매수 주도 |
gap_mean_5m | 체결 간 평균 간격(초) — 거래 밀도의 지표 |
rv_5m | 5분 실현변동성 — 가격 변화 제곱의 합 |
oi_chg_5m | 5분 동안 미결제약정 변화 |
ret_1m · ret_5m · ret_20m | 최근 1·5·20분의 가격 변화(틱) |
| 아래는 같은 계산에서 나오지만 모델 입력이 아니다 | |
P_obs_3458 |
컷오프 시점의 마지막 체결가. 기준가를 얼마나 아는지 재는 데
쓴다(앞 절의 75.03% 표). 가격 수준이라 그대로 넣으면 학습
구간의 금리대에 모델이 맞춰지므로 입력에서 뺐다 — 가격 정보는
수준이 아니라 변화(ret_*)로 들어간다. |
피처 목록의 정본은
contest_features_tick.TICK_FEATURE_COLUMNS 이고, 노트북이 학습
직전에 P_obs_3458 이 빠졌는지 단언한다.
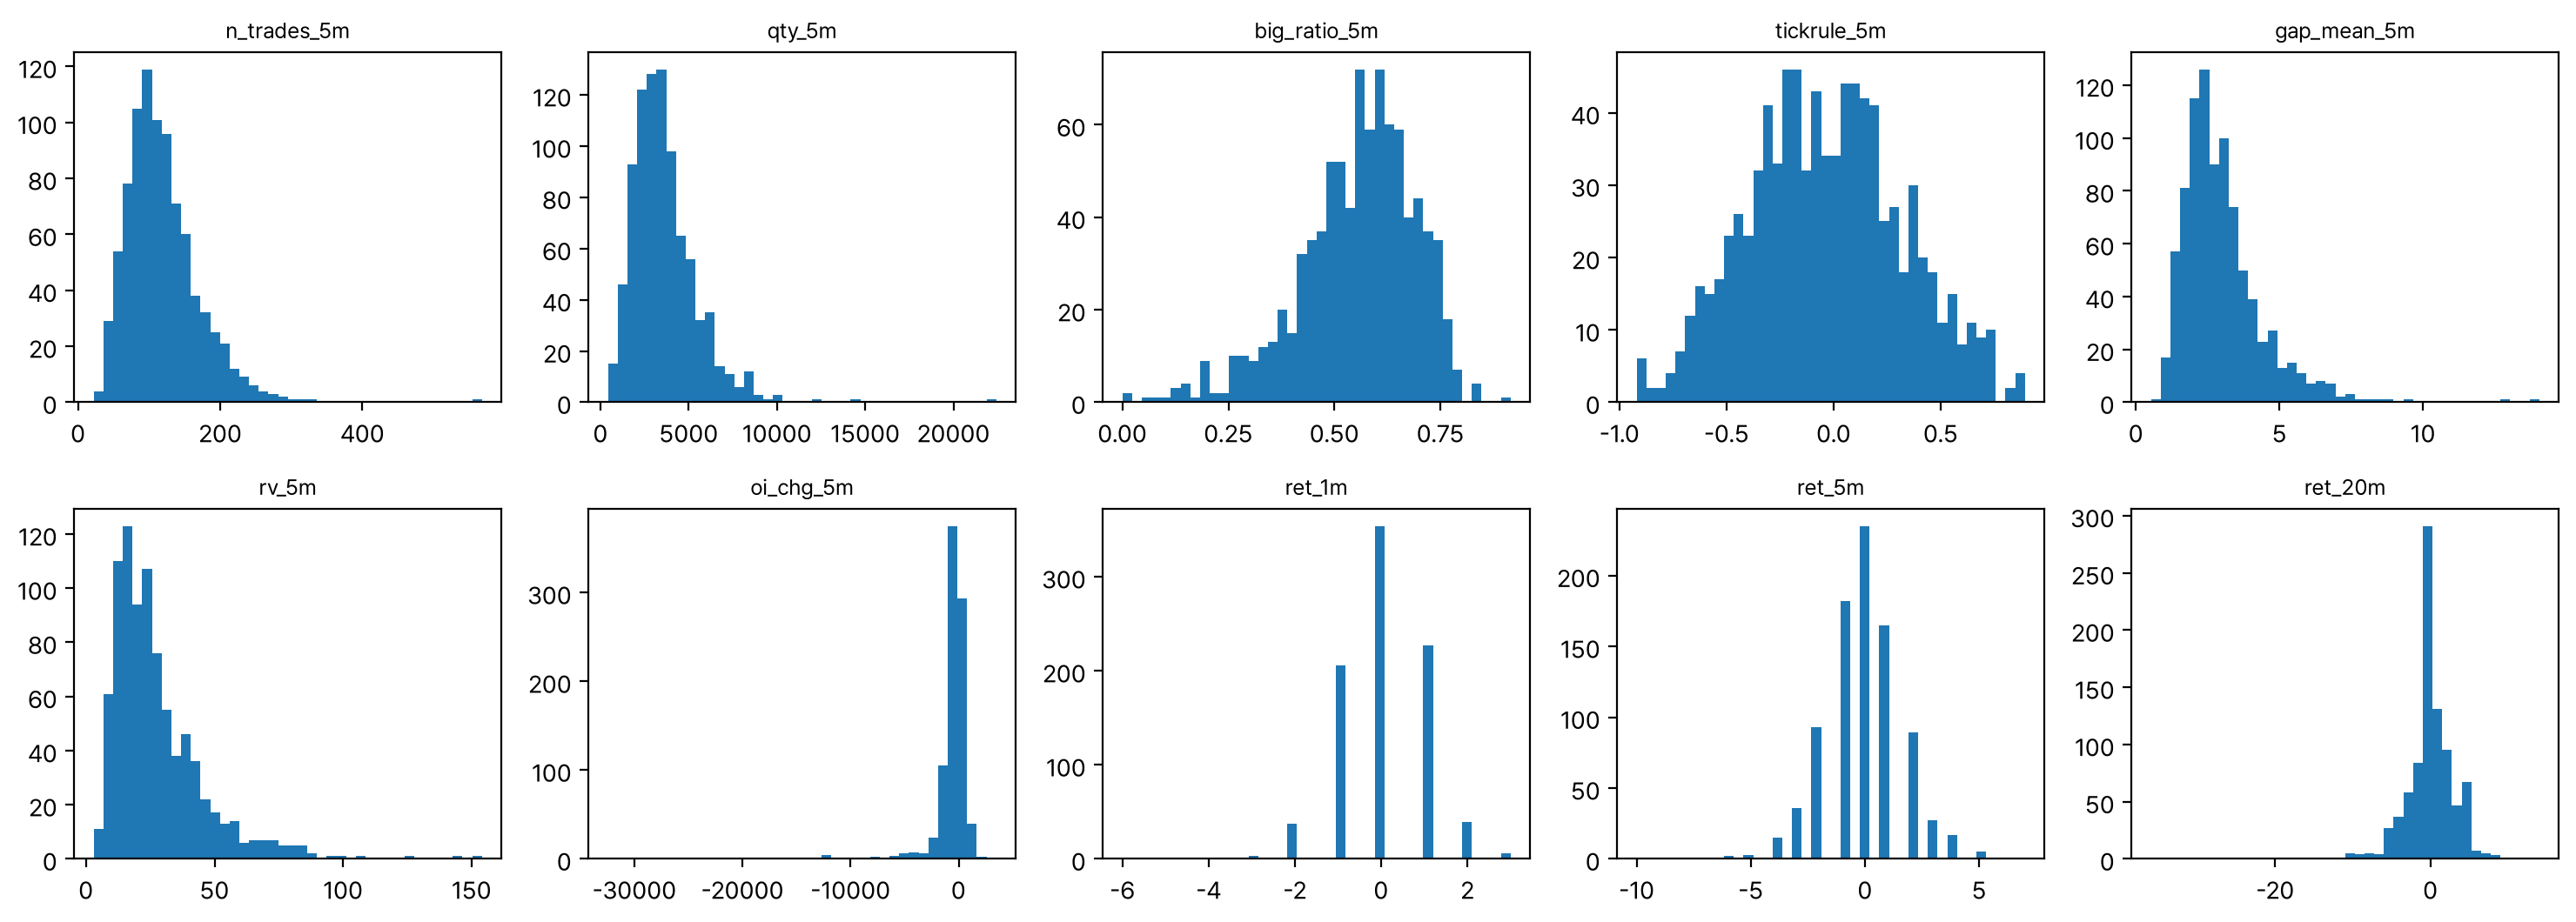
n_trades_5m·qty_5m·
rv_5m·gap_mean_5m 은 오른쪽 꼬리가 길고,
tickrule_5m 과 수익률 셋은 0 을 중심으로 대칭이다.
oi_chg_5m 의 왼쪽 꼬리(최대 −3만 계약대)는 만기 전환 구간의
대량 청산이다. 죽은 열(상수·전부 결측)이 하나도 없다는 것이 여기서
확인하려던 것이다.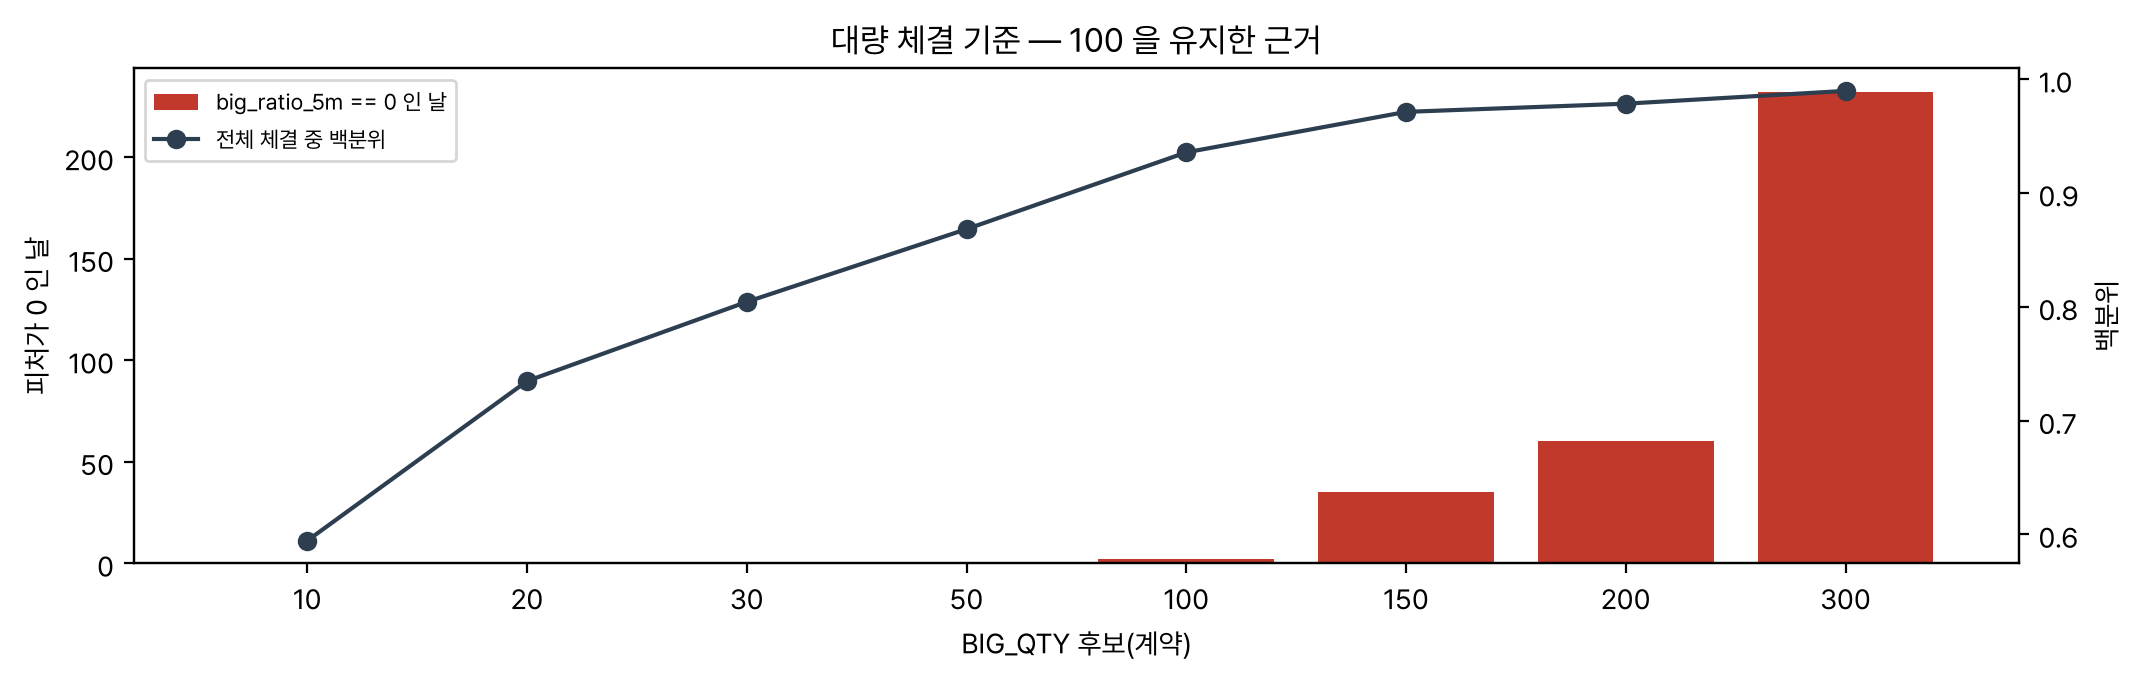
모델과 학습 설정
선행 실험과 같은 계열(그래디언트 부스팅, LightGBM 구현)이지만 이번에는 분류다 — 몇 틱인지가 아니라 상승·하락을 직접 예측한다.
ret_1m ≤ 0 로 갈리고(왼쪽이 참), 각 상자의 n 은 학습 표본 394행 중 그 노드에 떨어진 수다. 잎값은 이 트리가 로그오즈에 더하는 값으로 학습률 0.03 이 곱해진 뒤의 것 — 양이면 상승 쪽, 음이면 하락 쪽으로 민다. 오른쪽 눈금이 max_depth = 3 가 가리키는 구간이다.n 이 수십 개 수준인 곳이 많다 — 표본이 적어 잎당 표본 하한이 곧 트리의 모양이다.| 분기 위치 \ 피처 | oi_chg_5m | tickrule_5m | qty_5m | ret_20m | big_ratio_5m | gap_mean_5m | ret_1m | rv_5m | n_trades_5m | ret_5m | 합 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 깊이 0 (뿌리) | 34 | 39 | 24 | 40 | 34 | 22 | 67 | 1 | 0 | 39 | 300 |
| 깊이 1 | 105 | 89 | 68 | 55 | 61 | 43 | 11 | 27 | 9 | 5 | 473 |
| 깊이 2 | 106 | 58 | 72 | 69 | 47 | 39 | 17 | 39 | 42 | 1 | 490 |
| 분기 합 | 245 | 186 | 164 | 164 | 142 | 104 | 95 | 67 | 51 | 45 | 1,263 |
| 손실 감소(gain) 몫 | 20.1% | 14.3% | 14.7% | 16.2% | 10.3% | 6.0% | 8.4% | 4.3% | 3.6% | 2.0% | 100% |
위 표는 시드 0 · 시험 2025 모델 300그루의 분기 전부를 깊이별·피처별로 센 것이다. 뿌리(깊이 0) 행이 각 트리가 가장 먼저 보는 피처고, 마지막 행은 분기가 손실을 줄인 몫(gain)의 피처별 비율이다. 아래 표는 모델 열 개(시드 5 × 폴드 2) 각각의 첫 트리 뿌리 분기 — 시드는 LightGBM 의 표본·피처 추출 순서만 바꾸는데, 이 세팅(추출 없음)에서는 같은 폴드의 뿌리가 시드와 무관하게 같은지가 여기서 보인다.
| 시드 | 시험연도 | 학습 행 | 시험 행 | 재현 | f₁ 뿌리 분기 | 깊이 | 잎 수 |
|---|---|---|---|---|---|---|---|
| 0 | 2024 | 197 | 197 | 197 | ret_20m ≤ -1.5 | 2~3 | 4~6 |
| 0 | 2025 | 394 | 191 | 191 | ret_1m ≤ 0 | 3 | 4~7 |
| 1 | 2024 | 197 | 197 | 197 | ret_20m ≤ -1.5 | 2~3 | 4~6 |
| 1 | 2025 | 394 | 191 | 191 | ret_1m ≤ 0 | 3 | 4~7 |
| 2 | 2024 | 197 | 197 | 197 | ret_20m ≤ -1.5 | 2~3 | 4~6 |
| 2 | 2025 | 394 | 191 | 191 | ret_1m ≤ 0 | 3 | 4~7 |
| 3 | 2024 | 197 | 197 | 197 | ret_20m ≤ -1.5 | 2~3 | 4~6 |
| 3 | 2025 | 394 | 191 | 191 | ret_1m ≤ 0 | 3 | 4~7 |
| 4 | 2024 | 197 | 197 | 197 | ret_20m ≤ -1.5 | 2~3 | 4~6 |
| 4 | 2025 | 394 | 191 | 191 | ret_1m ≤ 0 | 3 | 4~7 |
| 항목 | 값 | 뜻 |
|---|---|---|
| 구현 · 버전 | LightGBM 4.7.0 분류 | CPU 전용 |
| 예측 대상 | 정답 부호 (상승/하락) | — |
| 피처 컷오프 | 15:34:58 | 제출 마감 직전 마지막 초 |
max_depth | 3 | 트리 한 그루의 최대 깊이 |
num_leaves | 7 | 트리 한 그루의 최대 잎 수 |
min_data_in_leaf | 30 | 잎 하나에 필요한 최소 표본 수 |
learning_rate | 0.03 | 트리 하나가 예측을 보정하는 보폭 |
n_estimators | 300 | 이어 붙이는 트리 개수 |
| 난수 시드 | 0 · 1 · 2 · 3 · 4 | 다섯 회 반복해 변동 폭을 확인 |
| 학습·평가 분할 | 연도 확장창 | 2023 → 2024 시험, 2023+2024 → 2025 시험 |
| 사전 등록한 기준선 방향 | 하락 | 학습 구간(2023)의 다수 클래스로 실행 전에 고정 |
위 값은 실행 전에 config.yaml 에 고정했다.
노트북이 학습 구간에서 다수 클래스를 재계산해 등록값과 일치하는지 확인하고,
다르면 그 지점에서 중단한다.
시드 다섯 개는 결과적으로 무의미했다. 위 설정에는
무작위 요소(표본·피처의 부분 추출 옵션)가 없어 LightGBM 이 완전히 결정적이다 —
다섯 시드의 예측이 모든 날짜에서 동일했고 적중률의 표준편차가 정확히 0 이다.
사후에 bagging 을 활성화해 의미를 부여할 수도 있었으나, 결과를
확인한 뒤 설정을 변경하는 것이므로 수행하지 않았다.
결과
| 갈래 | 평가일 | 적중률 | p vs 50% | p vs 다수 클래스 | 누적틱 |
|---|---|---|---|---|---|
| 무작위 | 388 | 50.26% | 0.480 | 1.000 | 54 |
| 상수 “매일 하락” — 사전 등록 | 388 | 61.08% | 7.4e-06 | 0.522 | 172 |
| 규칙 20분 | 299 | 56.52% | 0.014 | 0.953 | 49 |
| 틱 직접 분류 — 이 실험 | 388 | 54.64% | 0.038 | 0.996 | 78 |
평가 2024–2025, 다수 클래스 비율 61.08%. 두 p값은 모두
단측이다. 출처 results/20260910_191958_nb/.
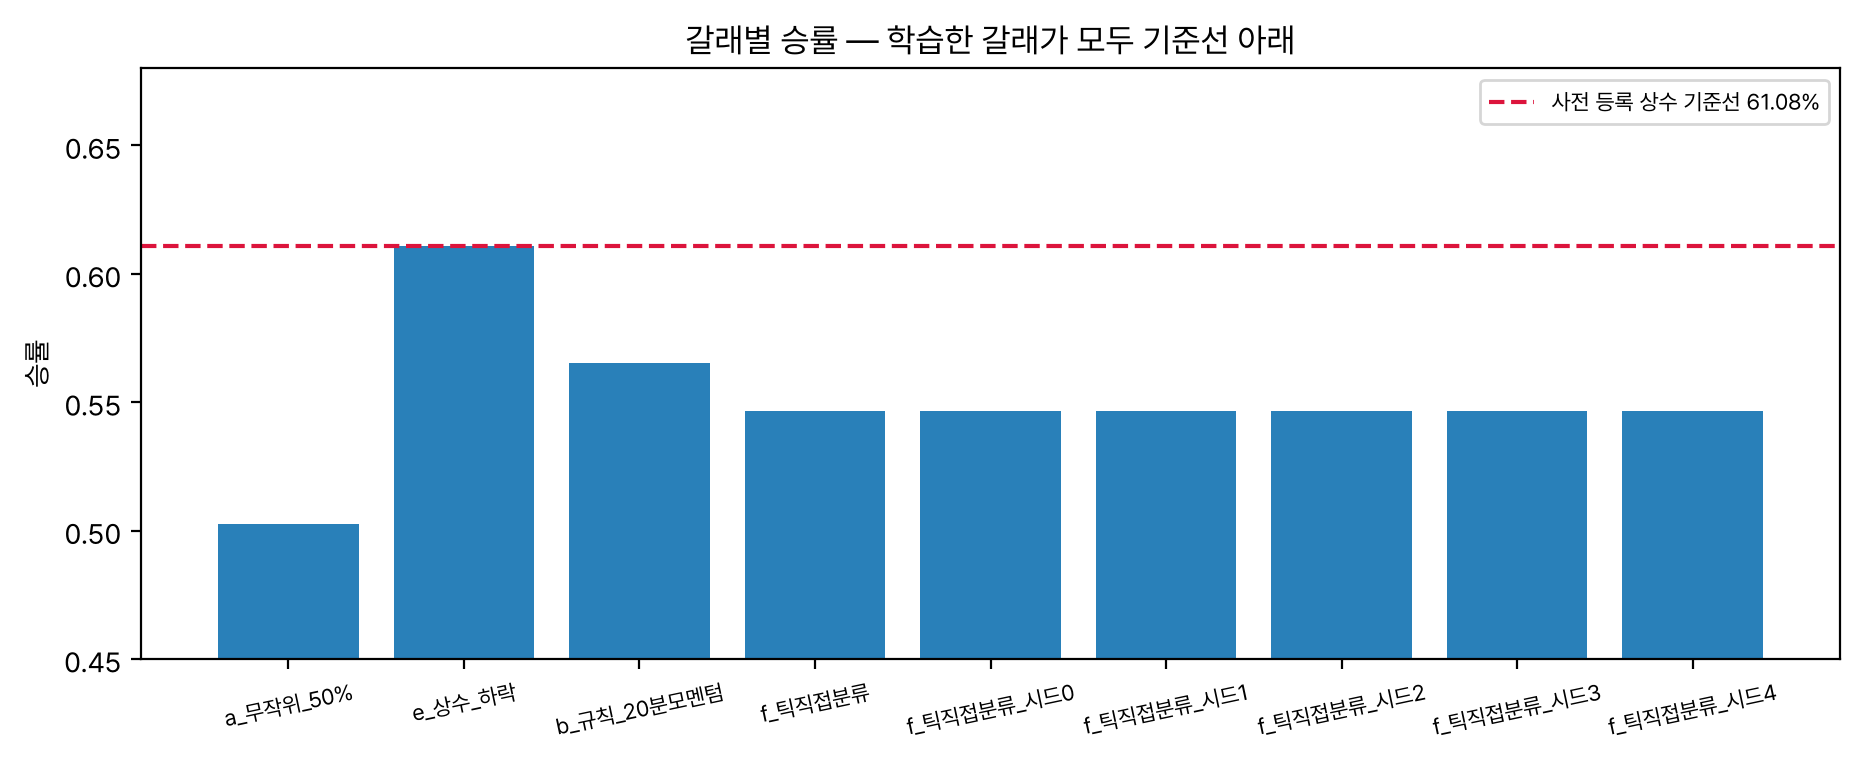
“p vs 다수 클래스” 열은 액면대로 해석해서는 안 된다. 다수 클래스 비율을 평가 기간에서 추정했으므로, 상수 기준선 행의 p값은 자기 자신을 상대로 검정한 값이어서 의미가 없다. 따라서 추정이 필요 없는 짝지은 검정을 별도로 수행했다 — 아래가 실제 판정 근거다.
동일 날짜 짝지은 비교 (McNemar 검정)
| 갈래 | 적중률 | 상수 대비 | b (갈래만 정답) | c (상수만 정답) | p (양측) |
|---|---|---|---|---|---|
| 선행 실험 — 드리프트 보정 | 60.05% | −1.03%p | 80 | 84 | 0.815 |
| 선행 실험 — 보정 없음 | 56.70% | −4.38%p | 56 | 73 | 0.159 |
| 이 실험 — 틱 직접 분류 | 54.64% | −6.44%p | 58 | 83 | 0.043 |
모두 동일한 388일. scipy.stats.binomtest(b, b+c, 0.5)
양측 정확검정을 사용했다(statsmodels 가 이 환경에 없다).
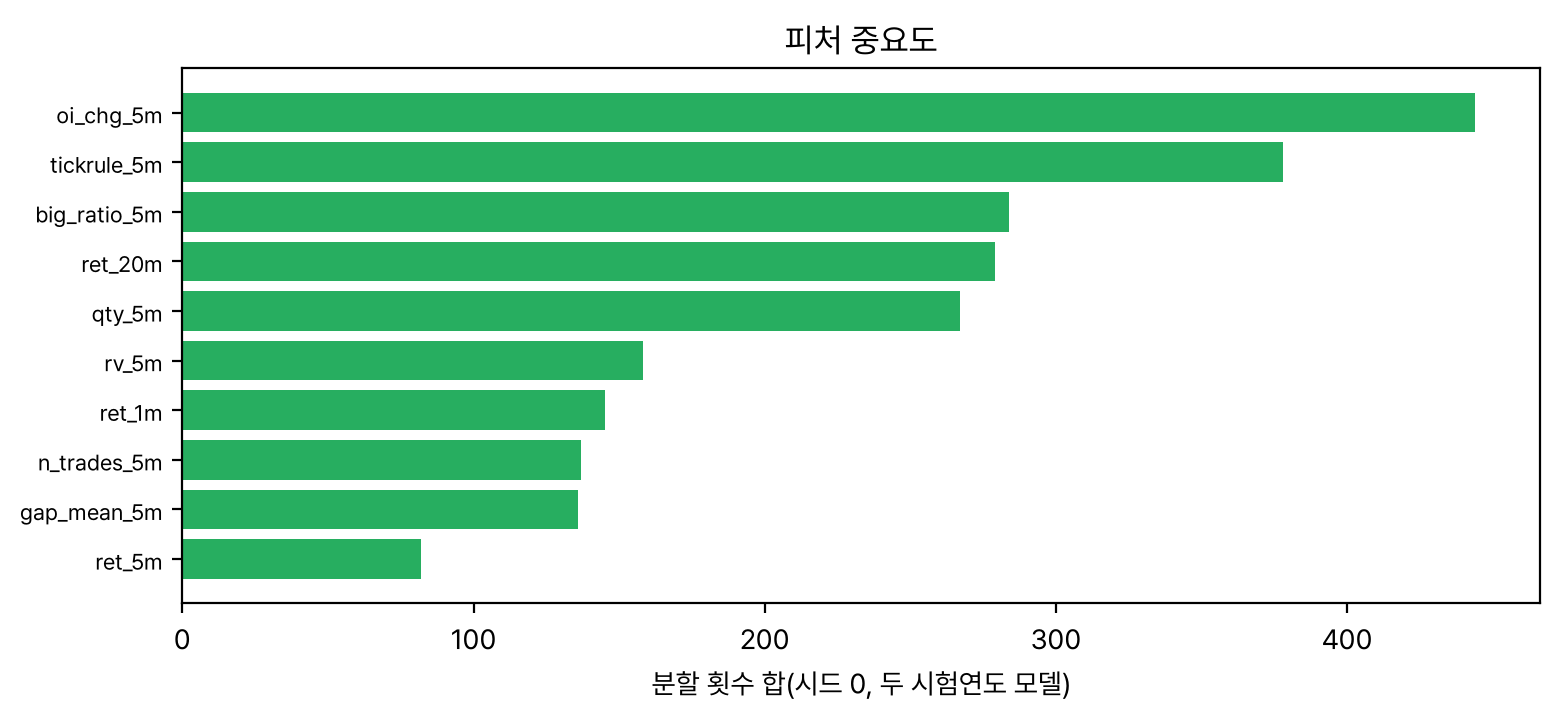
ret_20m)에 처음 나온다. 이 설계가 새로 얻은 정보를
모델이 실제로 많이 봤다는 뜻이고, 그럼에도 적중률이 상수 기준선에
미치지 못했다는 점이 결론을 더 분명하게 만든다. 이 그림은 기록된
예측을 날짜 단위로 100% 재현하는 것을 확인한 뒤 다시 학습한
모델에서 뽑았다.두 실험의 동일 표본 비교
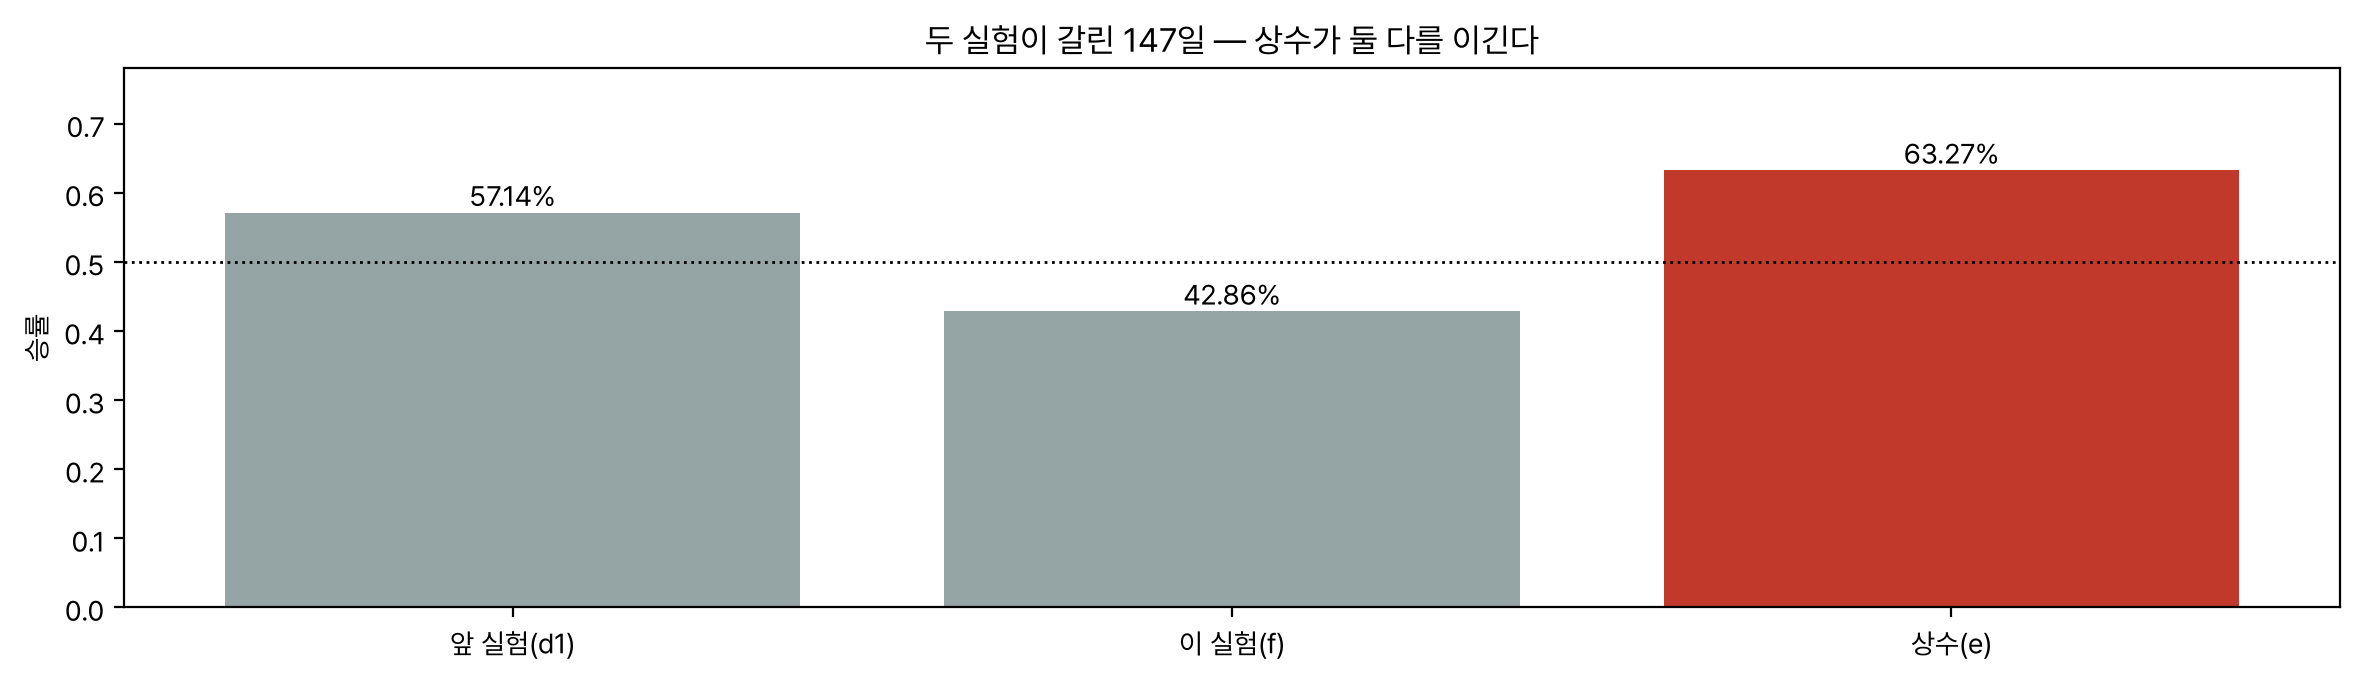
사전에 세운 판정 기준이 성립 불가능한 형태였다. 계획서는 “두 방식이 갈리는 날에 각각 50%를 넘으면 결합할 근거가 있다”고 기술했으나, 두 방식이 상승·하락 중 하나만 제출하고 갈리는 날에는 정의상 서로 반대이므로 두 적중률의 합이 항상 정확히 1 이다(실측 57.14+42.86=100.0). 어떤 데이터에서도 통과할 수 없다. 판정을 가능하게 한 것은 그 기준이 아니라 상수 기준선 대비라는 대체 기준이었다.