세 줄 요약
- 12개 조합이 단일 최고를 승률로 넘고 McNemar p<0.05 까지 통과했다(최소 p=0.0029).
- 그런데 사전등록 문턱 셋째(차이가 시드 흔들림의 2배를 넘을 것)를 하나도 넘지 못해 H14 미지지다.
- 그래도 이 실험은 값을 했다: 0005 의 0.6065 는 여덟 해를 다 보고 고른 값이고, 정직하게 고르면 2.0%p 떨어진다. 앙상블이 되돌리는 것이 정확히 그 간극이다.
무엇을 물었나
H14. 0005 의 확률을 섞은 앙상블이 같은 티어의 단일 최고 모델을 넘는가. 0002와 0004 에서 "앙상블 재료 없음" 이 두 번 확인됐는데(갈리는 날이 정확히 50:50), 그때는 갈래가 둘뿐이었다. 18종으로 넓혀 다시 본다.
모델을 다시 적합하지 않는다. 0005 의 워크포워드 확률을 그대로 섞는다. 그래서 이 실험의 결과는 그 확률에 종속이다.
누설 규율이 이 실험의 전부다
앙상블에서 가장 쉬운 자기기만은 전체 성적 상위 k 개를
골라 전체에서 평균하는 것이다. 그것은 시험연도를 보고 멤버를 고르는
사후 선택이다. 그래서 시험연도 Y 의 멤버와 가중치는
Y 보다 앞선 연도 성적에서만 골랐고, 첫 시험연도(고를 과거가
없는 해)는 동일가중 전체 평균으로 규칙을 미리 정했다. 스태킹
메타학습기도 Y 이전 자료로만 적합한다.
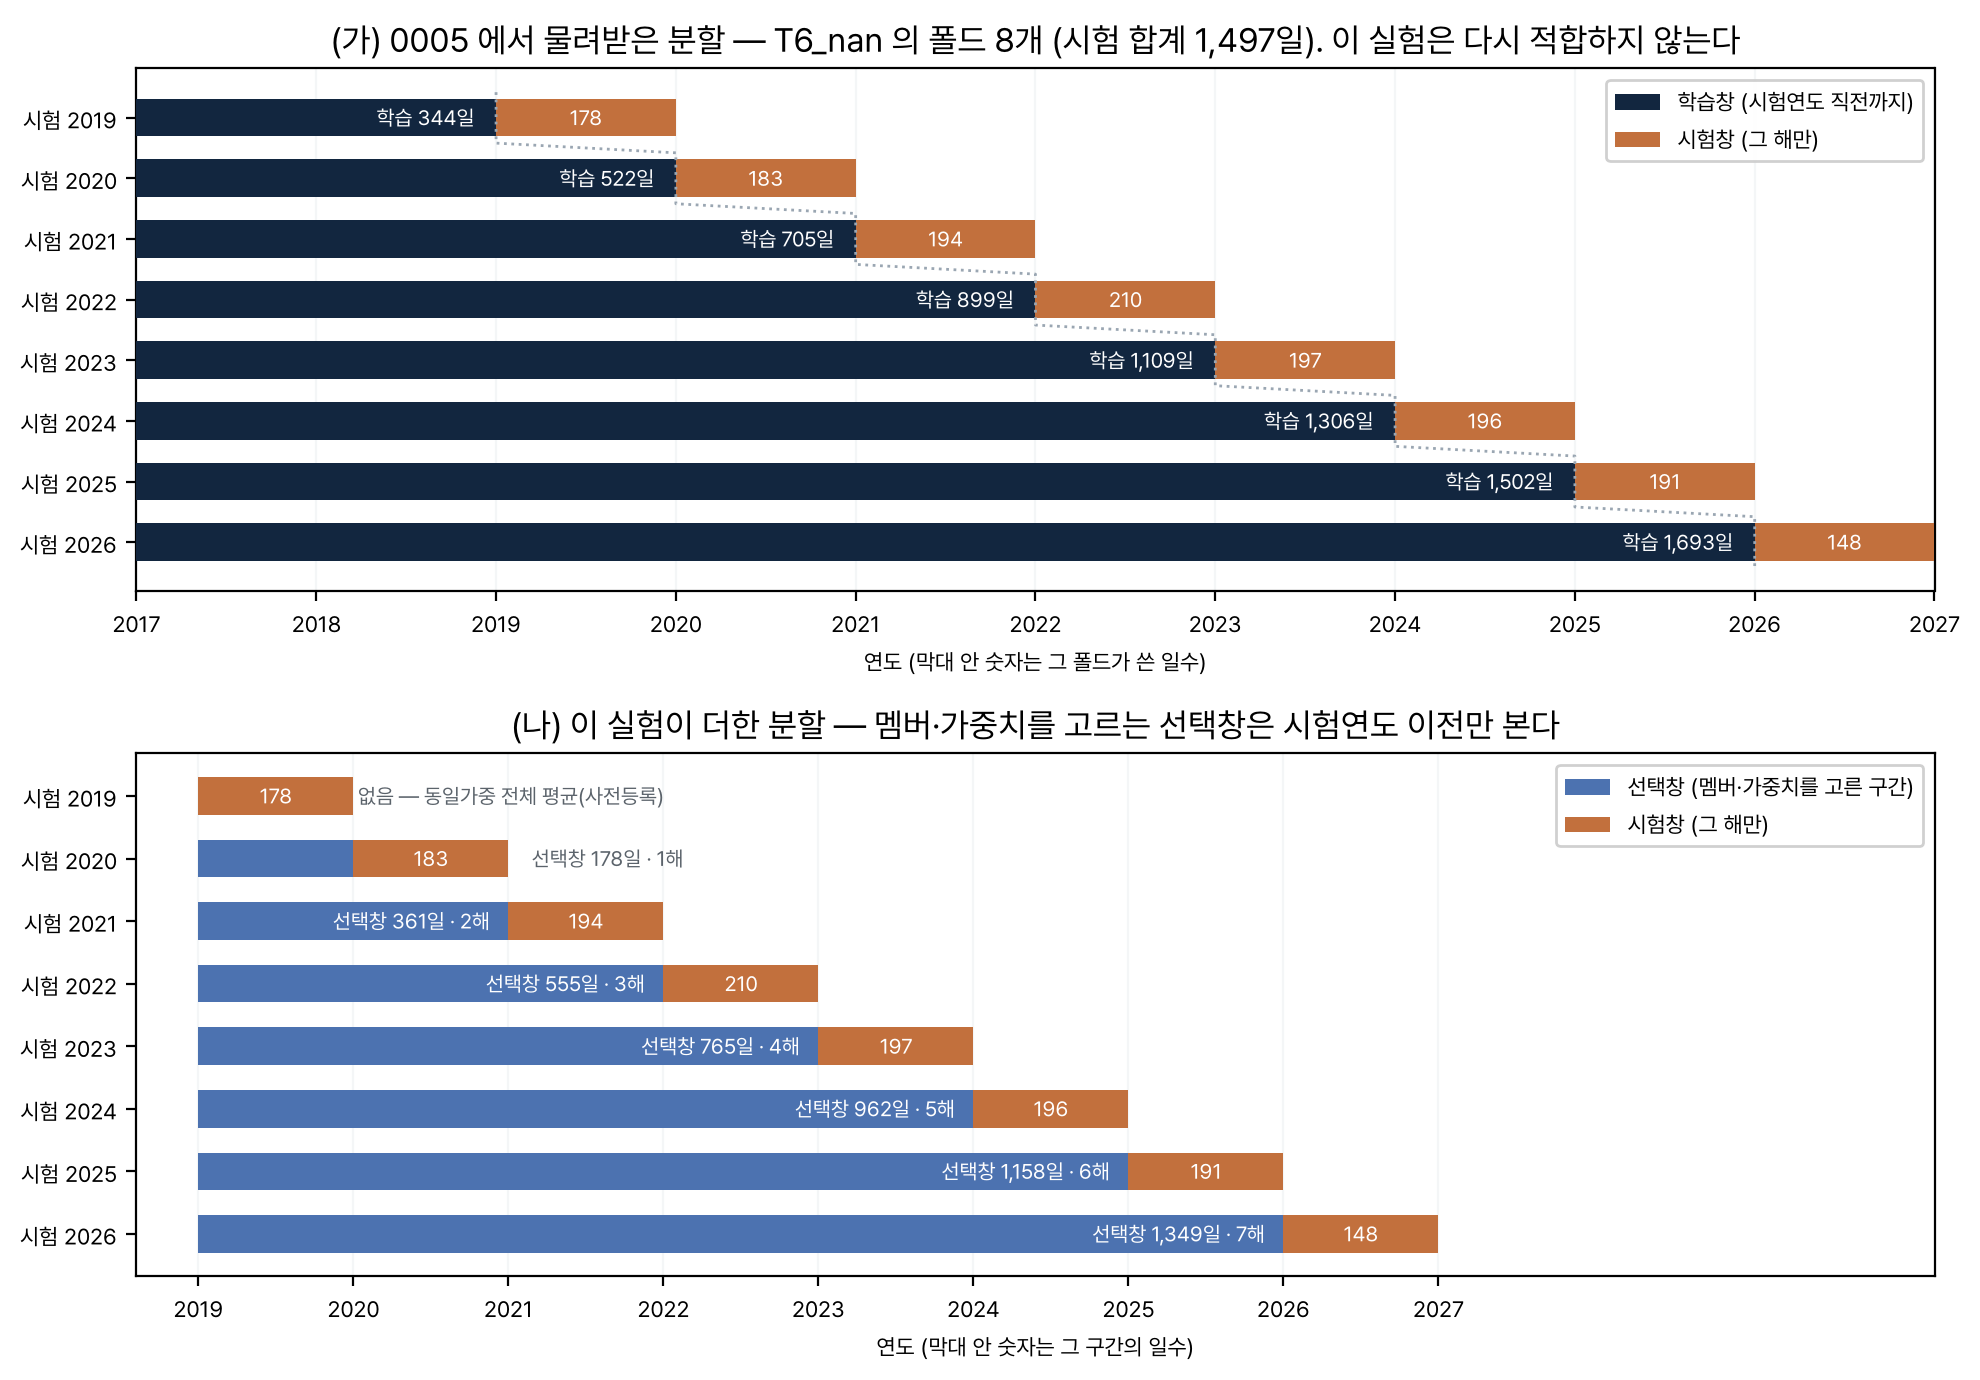
학습, 시험, 선택 데이터의 분할은 두 층이다
이 실험은 모델을 새로 적합하지 않으므로 학습과 시험 분할은 0005 에서 그대로 물려받는다. 이 실험이 더하는 것은 세 번째 창으로, 멤버와 가중치를 고르는 선택창이다. 선택창은 시험연도 이전만 보고, 시험창과 겹치지 않는다.
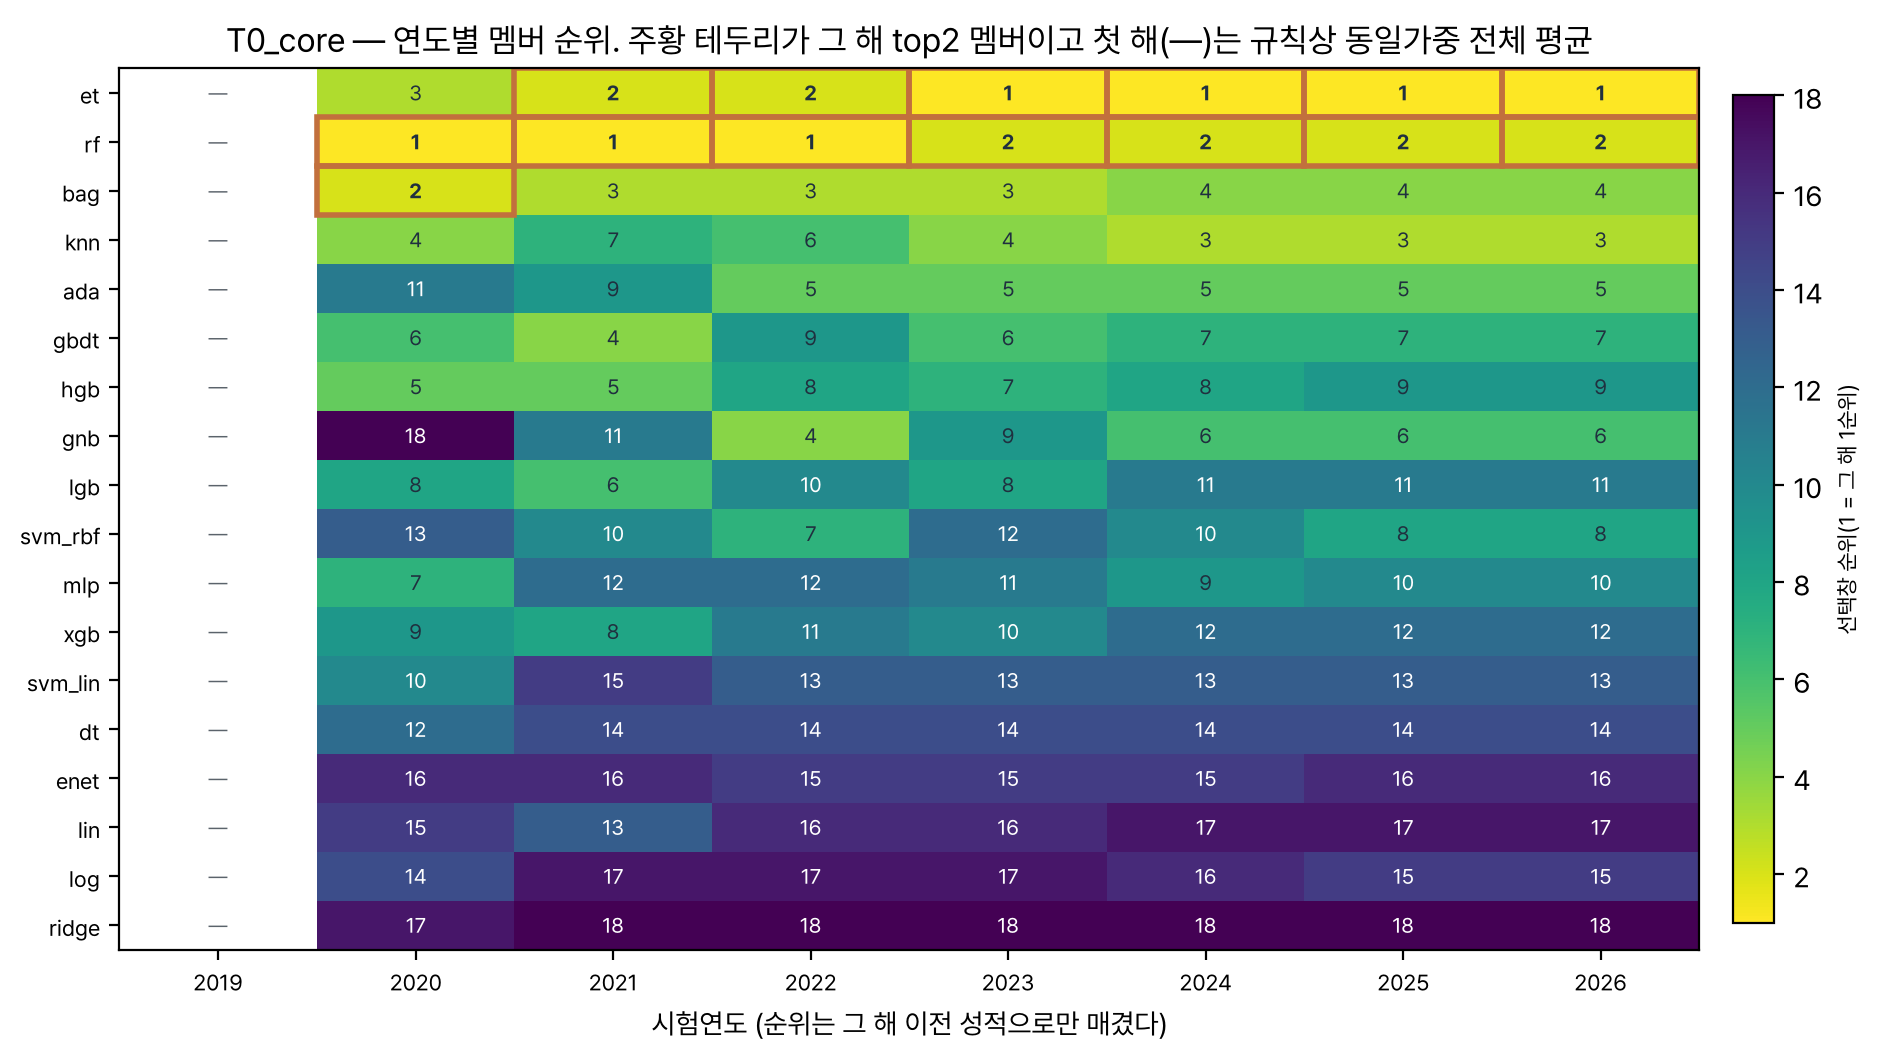
T0_core 에서 선택창이 매긴 연도별 순위. 주황
테두리가 그 해의 top2 멤버다. 순위가 해마다 바뀐다.
2020~2022 는 rf와 bag, 2023 부터는
et와 rf 다. 여덟 해를 다 보고 하나를 고를 수 없다는
사실이 이 그림이고, 앙상블이 메우는 간극이 정확히 여기다. 이 표는 런이
남기지 않았으므로 같은 규칙을 같은 확률에 다시 적용해 복원했고, 복원한
「직전 연도 최고 단일」 승률이 커밋된 표와 티어 다섯 모두 일치하는 것을
그림을 그리기 전에 확인한다.무엇을 묶나: 멤버 모델과 결합 방법
이 실험은 모델을 새로 학습하지 않는다. 앞선 실험(모델 열여덟 종을 티어 다섯에서 돌린 실험)이 남긴 날짜별 확률을 읽어, 여러 모델의 답을 하나로 묶는 방법만 바꿔 가며 잰다. 그래서 두 가지를 먼저 밝힌다: 묶는 대상(멤버)이 무엇이고, 묶는 방법이 무엇인가.
멤버로 묶이는 모델 열여덟 종
멤버는 계열 여섯으로 나뉜다. 배깅트리(et,
rf, bag)는 결정트리 수백 그루를 서로 다른 표본으로
따로 키워 평균낸다. 부스팅(lgb, xgb,
hgb, gbdt, ada)은 트리를 순서대로
키우되 다음 트리가 앞선 트리들의 잘못을 고치게 한다. 단일트리
(dt)는 트리 한 그루로, 앙상블이 얼마나 버는지 재는 바닥이다.
커널과 거리(svm_rbf, svm_lin,
knn)는 피처 공간에서 가까움을 재서 답한다. 선형과 확률
(log, lin, ridge, enet,
gnb)은 피처의 가중합 하나로 답한다. 신경망
(mlp)은 32칸과 16칸 은닉층 두 개를 쌓은 다층 퍼셉트론이다. 각
모델의 구조도(학습된 모델 객체에서 그린 실제 분기, 층, 계수)는 모델 열여덟 종
실험의 상세 페이지에 있다.
앙상블이 이득을 보려면 멤버끼리 서로 다르게 틀려야 한다. 그래서 아래 결과에 쌍 예측 일치율을 함께 싣는다. 두 모델이 같은 날 같은 방향을 고른 비율이다. 일치율이 1 에 가까우면 묶어도 새로 얻을 것이 없다.
결합 방법 다섯
| 이름 | 무엇을 하나 | 왜 다른가 |
|---|---|---|
avg_topk |
상위 k 모델의 확률을 평균내고 0.5 를 넘으면
상승으로 낸다. |
확신이 센 모델의 극단값이 평균을 끌 수 있다. |
wavg_topk |
같은 평균인데 직전 연도 승률에서 0.5 를 뺀 값을 가중치로 쓴다. 과거에 잘 맞힌 모델의 표가 더 무겁다. | 가중치도 이전 연도만 보고 만든다 — 시험연도를 쓰지 않는다. |
vote_topk |
확률을 버리고 방향에만 투표한다. 상승·하락 표를 세어 많은 쪽으로 낸다. 동수면 그날의 적응 상수 기준선을 따른다. | 극단 확률의 영향을 받지 않는다. |
family_one |
계열마다 그 계열에서 가장 높은 모델을 하나씩 뽑아 확률을 평균낸다. | 성적 대신 다양성을 먼저 본다 — 같은 계열 여럿이 몰려 한쪽으로 쏠리는 것을 막는다. |
stack_logit |
모델 열여덟 개의 확률을 그대로 입력으로 받아 로지스틱 회귀를 한 번 더 적합한다(메타학습기). | 가중치를 사람이 정하지 않고 데이터에서 배운다. 대신 배울 것이 많아 표본을 더 요구한다 — 이전 연도 표본이 200일 미만이면 건너뛴다. |
어느 모델이 「상위 k」인지는 시험연도 이전 연도의 성적으로만
정한다. 시험연도 성적을 보고 고르면 그 순간 답을 미리 본 것이 되고, 앙상블이
좋아 보이는 것은 실력이 아니라 누설이다. 같은 이유로 스태킹의 메타학습기도
이전 연도 확률로만 적합한다.
결과
| 티어 | 정직한 단일 | 최고 앙상블 | 승률 | 누적틱 | McNemar p (b:c) |
|---|---|---|---|---|---|
T0_core | 0.5805 | avg_top2 | 0.6005 | +637 | 0.0029 (63:33) |
T1_flow34 | 0.5678 | vote_top2 | 0.5915 | +485 | 0.0108 (66:39) |
T4_daily | 0.5925 | vote_top2 | 0.5979 | +641 | 0.4797 (53:45) |
T5_all | 0.5766 | vote_top3 | 0.5968 | +531 | 0.0117 (50:27) |
T6_nan | 0.5972 | vote_top2 | 0.6012 | +693 | 0.6063 (50:44) |
| 문턱 | 결과 |
|---|---|
| (a) 단일 최고를 승률로 넘는다 | 통과 — 21개 조합 |
| (b) 짝지은 McNemar p < 0.05 | 통과 — 그 중 12개 |
| (c) 차이 > 시드 흔들림 2배 | 전부 실패 — 최대 차이 2.0%p 대 문턱 13.8%p |
(c) 가 이렇게 센 이유는 시드 흔들림을 그 티어의 최대값으로 잡았기
때문이다(T0_core 0.0692, 부스팅 계열 하나가 크게 흔들린 값).
실제로 앙상블에 들어가는 상위 2~3 모델의 흔들림은 0.012~0.024 다.
문턱 정의가 보수적이었다. 그 사실을 적고 기준을 사후에 고치지 않는다.
앙상블이 메우는 것
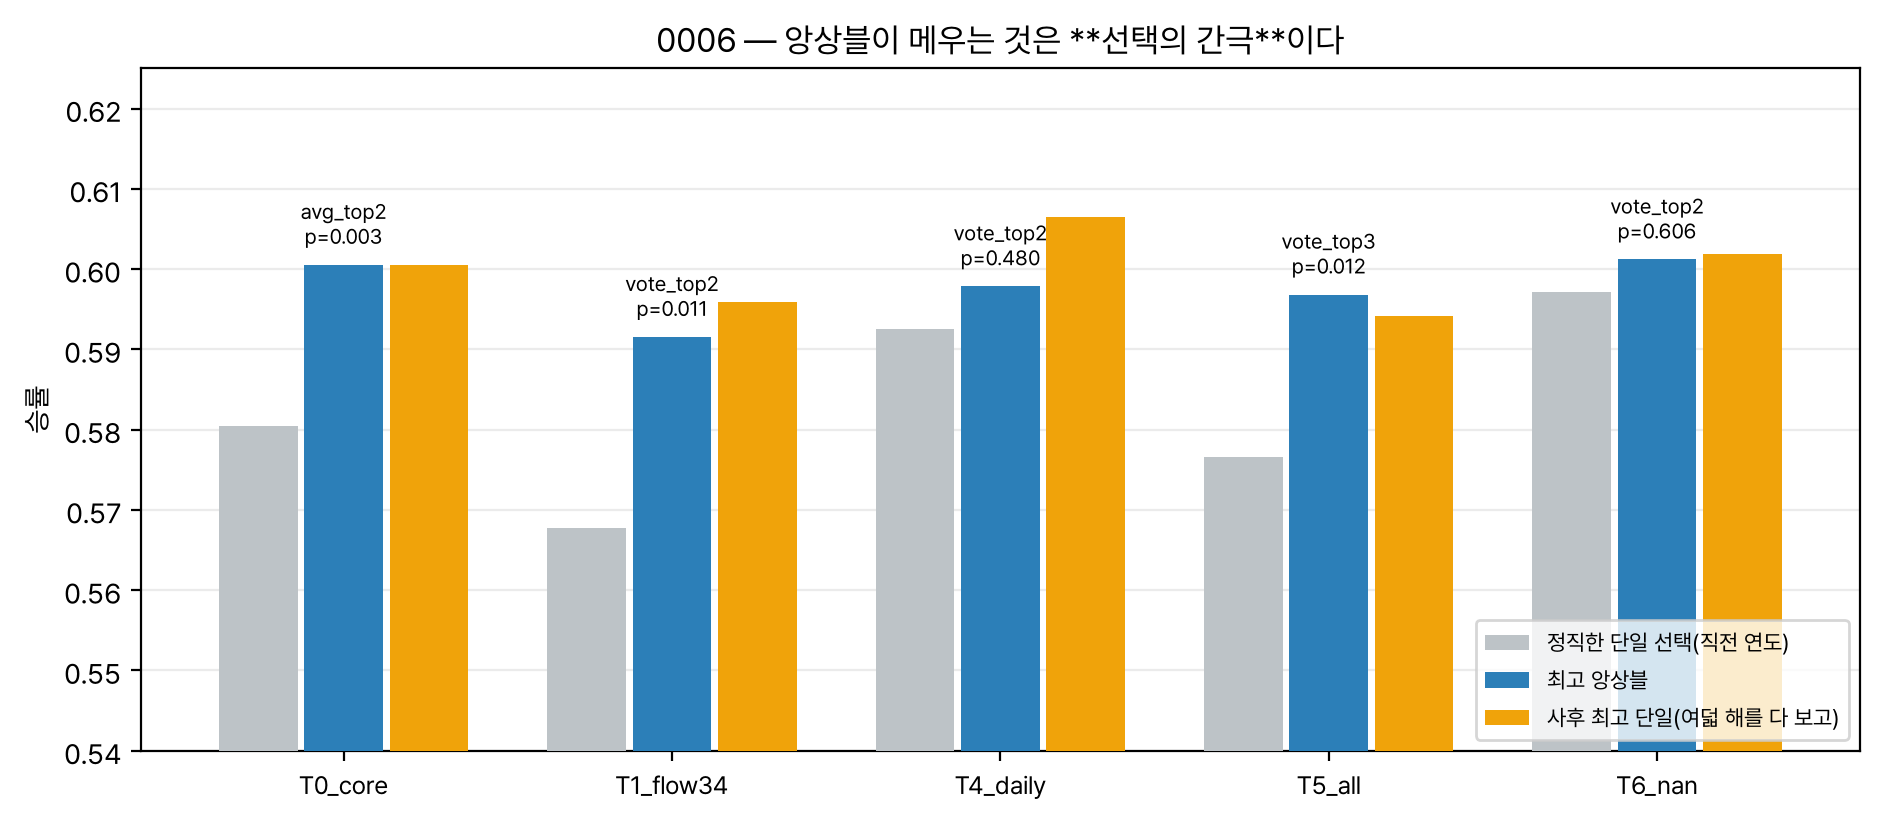
T0_core와 T6_nan)가 이 실험의 관측이다.T0_core 에서 사후 최고 0.6005, 정직한 단일 선택 0.5805,
avg_top2 0.6005 로, 앙상블이 사후 최고와 같은 자리에
정직하게 도달한다. 즉 앙상블은 성능을 만드는 것이 아니라
"어느 모델이 좋을지 미리 모른다" 를 없앤다.
| 티어 | 모델 | 중위 | 최소 | 최대 |
|---|---|---|---|---|
T0_core | 18 | 0.686 | 0.513 | 0.945 |
T1_flow34 | 18 | 0.695 | 0.497 | 0.935 |
T4_daily | 18 | 0.679 | 0.435 | 0.932 |
T5_all | 17 | 0.693 | 0.554 | 0.937 |
T6_nan | 6 | 0.799 | 0.675 | 0.941 |
중위 0.68~0.80 이라 재료는 있었다. 0002와 0004 에서 없던 이유는 갈래가 둘뿐이었기 때문이고, 18종이면 서로 다른 날 틀린다.
방법 사이의 차이
| 방법 | 중위 | 방법 | 중위 |
|---|---|---|---|
vote_top2 | 0.5960 | wavg_top3 | 0.5825 |
vote_top3 | 0.5919 | stack_logit | 0.5820 |
vote_top7 | 0.5912 | avg_top5 | 0.5819 |
vote_top5 | 0.5905 | wavg_top5 | 0.5819 |
avg_top2 | 0.5905 | avg_top7 | 0.5775 |
wavg_top2 | 0.5872 | family_one | 0.5752 |
wavg_top7 | 0.5845 | avg_top3 | 0.5832 |
다수결이 대체로 최고다. 확률 평균은 한 모델의 극단 확률에 끌리는데
다수결은 그것을 한 표로 누른다. 가중 평균은 단순 평균보다 낫지 않다
(연 190일에서 승률 차 대부분이 잡음이다). stack_logit 은 멤버 간
상관 때문에 계수가 흔들리고, family_one 은 다양성을 강제하느라
약한 계열(선형 0.52~0.54)을 반드시 들여 평균을 끌어내린다.
한계
① 0005 확률에 종속이다. 그쪽이 시드 3개를 이미 평균했으므로 앙상블 안에서 시드 다양성을 쓰지 못했다.
② 멤버 재선택이 연도 경계에서만 일어난다. 더 잦은 재선택은 표본이 하루 1행인 문제에서 잡음을 좇는다.
③ 문턱 (c) 의 정의가 보수적이었다. 판정은 미지지로 남긴다. 기준을 결과 뒤에 고치는 것이 더 나쁘다. 다시 설계하려면 새 사전등록 (0007)이 먼저다.
④ 스태킹의 확률 보정은 하지 않았다. 로그손실은 내지 않았다.
산출물
- 사전등록
protocol.md - 분석과 판정
analysis.md - 정본 런
results/20260922_142912_ensemble/ - 입력(0005)
experiments/0005_flow_api_model_zoo/