세 줄 요약
- H17 지지. 제대로 탐색한 신경망은 0005 가 쓴 단일 MLP 설정을 넘는다(
T4_daily0.5438 → 0.5785,T1_flow340.5704 → 0.5960). H18 은 티어별로 갈렸고 장중 수급 티어 한 자리에서 트리를 넘었다(0.5960 대 0.5678, McNemar p=0.0416). - 그런데 그 자리의 20분 모멘텀 규칙이 0.5933 이고 규칙 대비 McNemar p=0.9037 이다. 이긴 것은 트리이고 규칙이 아니다. 그 한 승은 튠한 트리 앞에서 사라진다(p=0.0591).
- 대회 제출 관점에서 이 실험은 배포할 물건을 만들지 못했다.
가설과 결론
- 가설
- 선행 실험(0005)의 모델 18종 가운데 신경망은
mlp하나였고 설정도hidden_layer_sizes=(32,16)하나였다. 그 축을 제대로 탐색하면, 즉 설정 격자를 넓히고 현대 학습 레시피(LayerNorm, dropout, AdamW, 코사인 스케줄, label smoothing, SWA)를 넣고 수치 피처 임베딩을 더하면 0005 의 단일 MLP 설정을 넘고(H17) 0005 의 정직 선택 트리에 닿는다(H18). - 결론
- H17 지지. 두 티어에서 승률, 유의성, 흔들림 문턱 셋을 다 넘었다.
H18 은 갈렸다.
T1_flow34지지,T5_all동급,T0_core와T4_daily미지지. 그러나 네 티어 중 어느 것도 20분 모멘텀 규칙을 유의하게 넘지 못했다, 그리고 지지된 한 자리는 트리가 가장 약한 티어였다. 수치 임베딩이 맨 MLP 를 올린다는 가설(H19)은 미지지(짝 여덟 개 전부 p ≥ 0.3155), 계열 순서 가설(H20′)도 미지지이고 뒤집힌 자리가 셋이다. - 이 실험이 바꾼 것
- 모델 축 하나다. 피처를 새로 만들지 않고 0005 의 캐시를 그대로 읽었다. 데이터가 같아야 0005 와의 비교가 성립한다.
기호와 데이터
이 문서는 혼자 열린다. 쓰는 낱말을 여기서 정의한다.
- P_ref
- 채점 기준가. 15:45 동시호가 직전의 참조 가격이고 제출 시점에는 관측할 수 없다.
- P45
- 15:45 동시호가로 결정된 종가.
- ref_tick
P45와P_ref의 차이를 틱으로 센 값. 이 부호가 맞히려는 것이다. 0이면 그 날을 표본에서 뺀다.- 0틱
ref_tick = 0인 날. 방향이 없어 채점이 성립하지 않으므로 표본에서 제외한다(원시 2,394일 → 유효 1,847일).- 승률
- 예측 부호가
ref_tick부호와 같은 날의 비율. 이 리포트의 모든 승률은 시험 구간에서만 센 값이다. - 워크포워드
- 연도 확장창. 시험연도 직전까지를 학습으로 쓰고 그 해만 시험한다. 학습이 해마다 자란다. 344행에서 1,693행까지다.
- 티어
- 피처 그룹의 묶음. 티어가 다르면 학습 시작연도와 시험 표본이 달라지므로 티어를 섞어 승률을 비교하지 않는다.
- 정직 선택
- 설정을 직전 연도까지의 성적만 보고 고르는 절차. 동률이면 이름 순이다. 이 리포트의 머릿수는 전부 정직 선택값이고, 여덟 해를 다 보고 고른 사후 최고는 판정 문장에 쓰지 않는다.
- spread_deploy
- 배포 형태의 시드 흔들림. 시드 열 개에서 크기 5짜리 부분집합 20개를 고정 난수로 뽑아 각 부분집합의 확률 평균으로 승률을 내고, 그 20개의 표준편차를 쓴다. 판정 문턱은 이 값의 2배다.
- spread_seed
- 단일 시드 승률의 표준편차(0005와 0006 이 쓴 정의). 참고로만 적고 판정에는 쓰지 않는다.
- e_규칙
- 기준선 하나. 20분 모멘텀의 부호다. 모델이 아니라 규칙이고, 이 실험의 진짜 상대다.
- e_적응상수
- 기준선 하나. 후행 120영업일의 다수 클래스다.
| 원천 | 기간 | 해상도 | 행수 | 열수 | 결측 | 쓰임 |
|---|---|---|---|---|---|---|
3년 국채선물 근월 (g1_) | 2016-12-20 ~ 2026-09-18 | 1분봉 | 1,847 | 24 | 0.06% | 모멘텀·변동폭·위치. 봉 컷오프 15:34:00 |
10년선물·커브 (g1p_) | 같음 | 1분봉 | 1,847 | 6 | 0.11% | 장기 구간과의 관계 |
장중 투자자 수급 (g2_) | 2019-01-02 ~ 2026-09-18 | 30초 증분 | 1,847 | 28 | 19.98% | 수급 컷오프 15:34:00. 2017~18 은 전부 결측이라 이 그룹을 쓰는 묶음은 학습이 2019 부터다 |
일별·캘린더 (g6_) | 2016 ~ 2026-09-18 | 일별 | 1,847 | 37 | 0.60% | 전일까지만 쓴다 |
선물 일봉 전필드 (g7_) | 2016 ~ 2026-09-18 | 일별 종가 기준 | 1,847 | 48 | 0.21% | 전일 값만. 호가·베이시스·투자자 평균단가 |
한국은행 국고채 단순매입 (g8_) | 2019 ~ 2026-09-18 | 사건 | 1,847 | 6 | 66.60% | 공개시장운영 축. 결측이 커서 141열 묶음에서 8열이 분산 0 으로 떨어진다 |
| 표본 | 2016-12-20 ~ 2026-09-18 | 일별(라벨) | 1,847 | 204 | 원시 2,394일에서 장 이상일과 ref_tick = 0 인 날을 뺀 것 |
| 피처 묶음 | 그룹 | 선언 열 | 실측 열 | 학습 시작 | 학습 행 | 시험연도 | 시험 행 |
|---|---|---|---|---|---|---|---|
T0_core 봉·커브·일별달력 | g1_ g1p_ g6_ | 67 | 65 | 2017 | 344 → 1,693 | 2019~2026 | 1,497 |
T4_daily +일봉 전필드 | +g7_ | 115 | 113 | 2017 | 344 → 1,693 | 2019~2026 | 1,497 |
T1_flow34 +장중 수급 | +g2_ | 95 | 93 | 2019 | 361 → 1,349 | 2021~2026 | 1,136 |
T5_all 새 데이터 전부 | +g2_ g7_ g8_ | 149 | 141 | 2019 | 361 → 1,349 | 2021~2026 | 1,136 |
전 그룹 204열 묶음은 뺐다. 첫 학습 폴드의 결측이 42.9% 라 중앙값으로 채운 뒤 재는 승률은 모델이 아니라 대치 방식을 재는 것에 가깝다. 사전등록에 뺀 이유를 적었고 결과를 보고 다시 넣지 않았다.
어떻게 쟀나
사전등록(protocol.md)을 결과 보기 전에 썼고 실행 뒤에 고치지
않았다. 문턱을 두 번 올렸고 두 번 다 결과를 보기 전이다. 그 사실은
커밋 순서가 증언한다(사전등록 → 문턱 조임 → 라운드 0 → 결과).
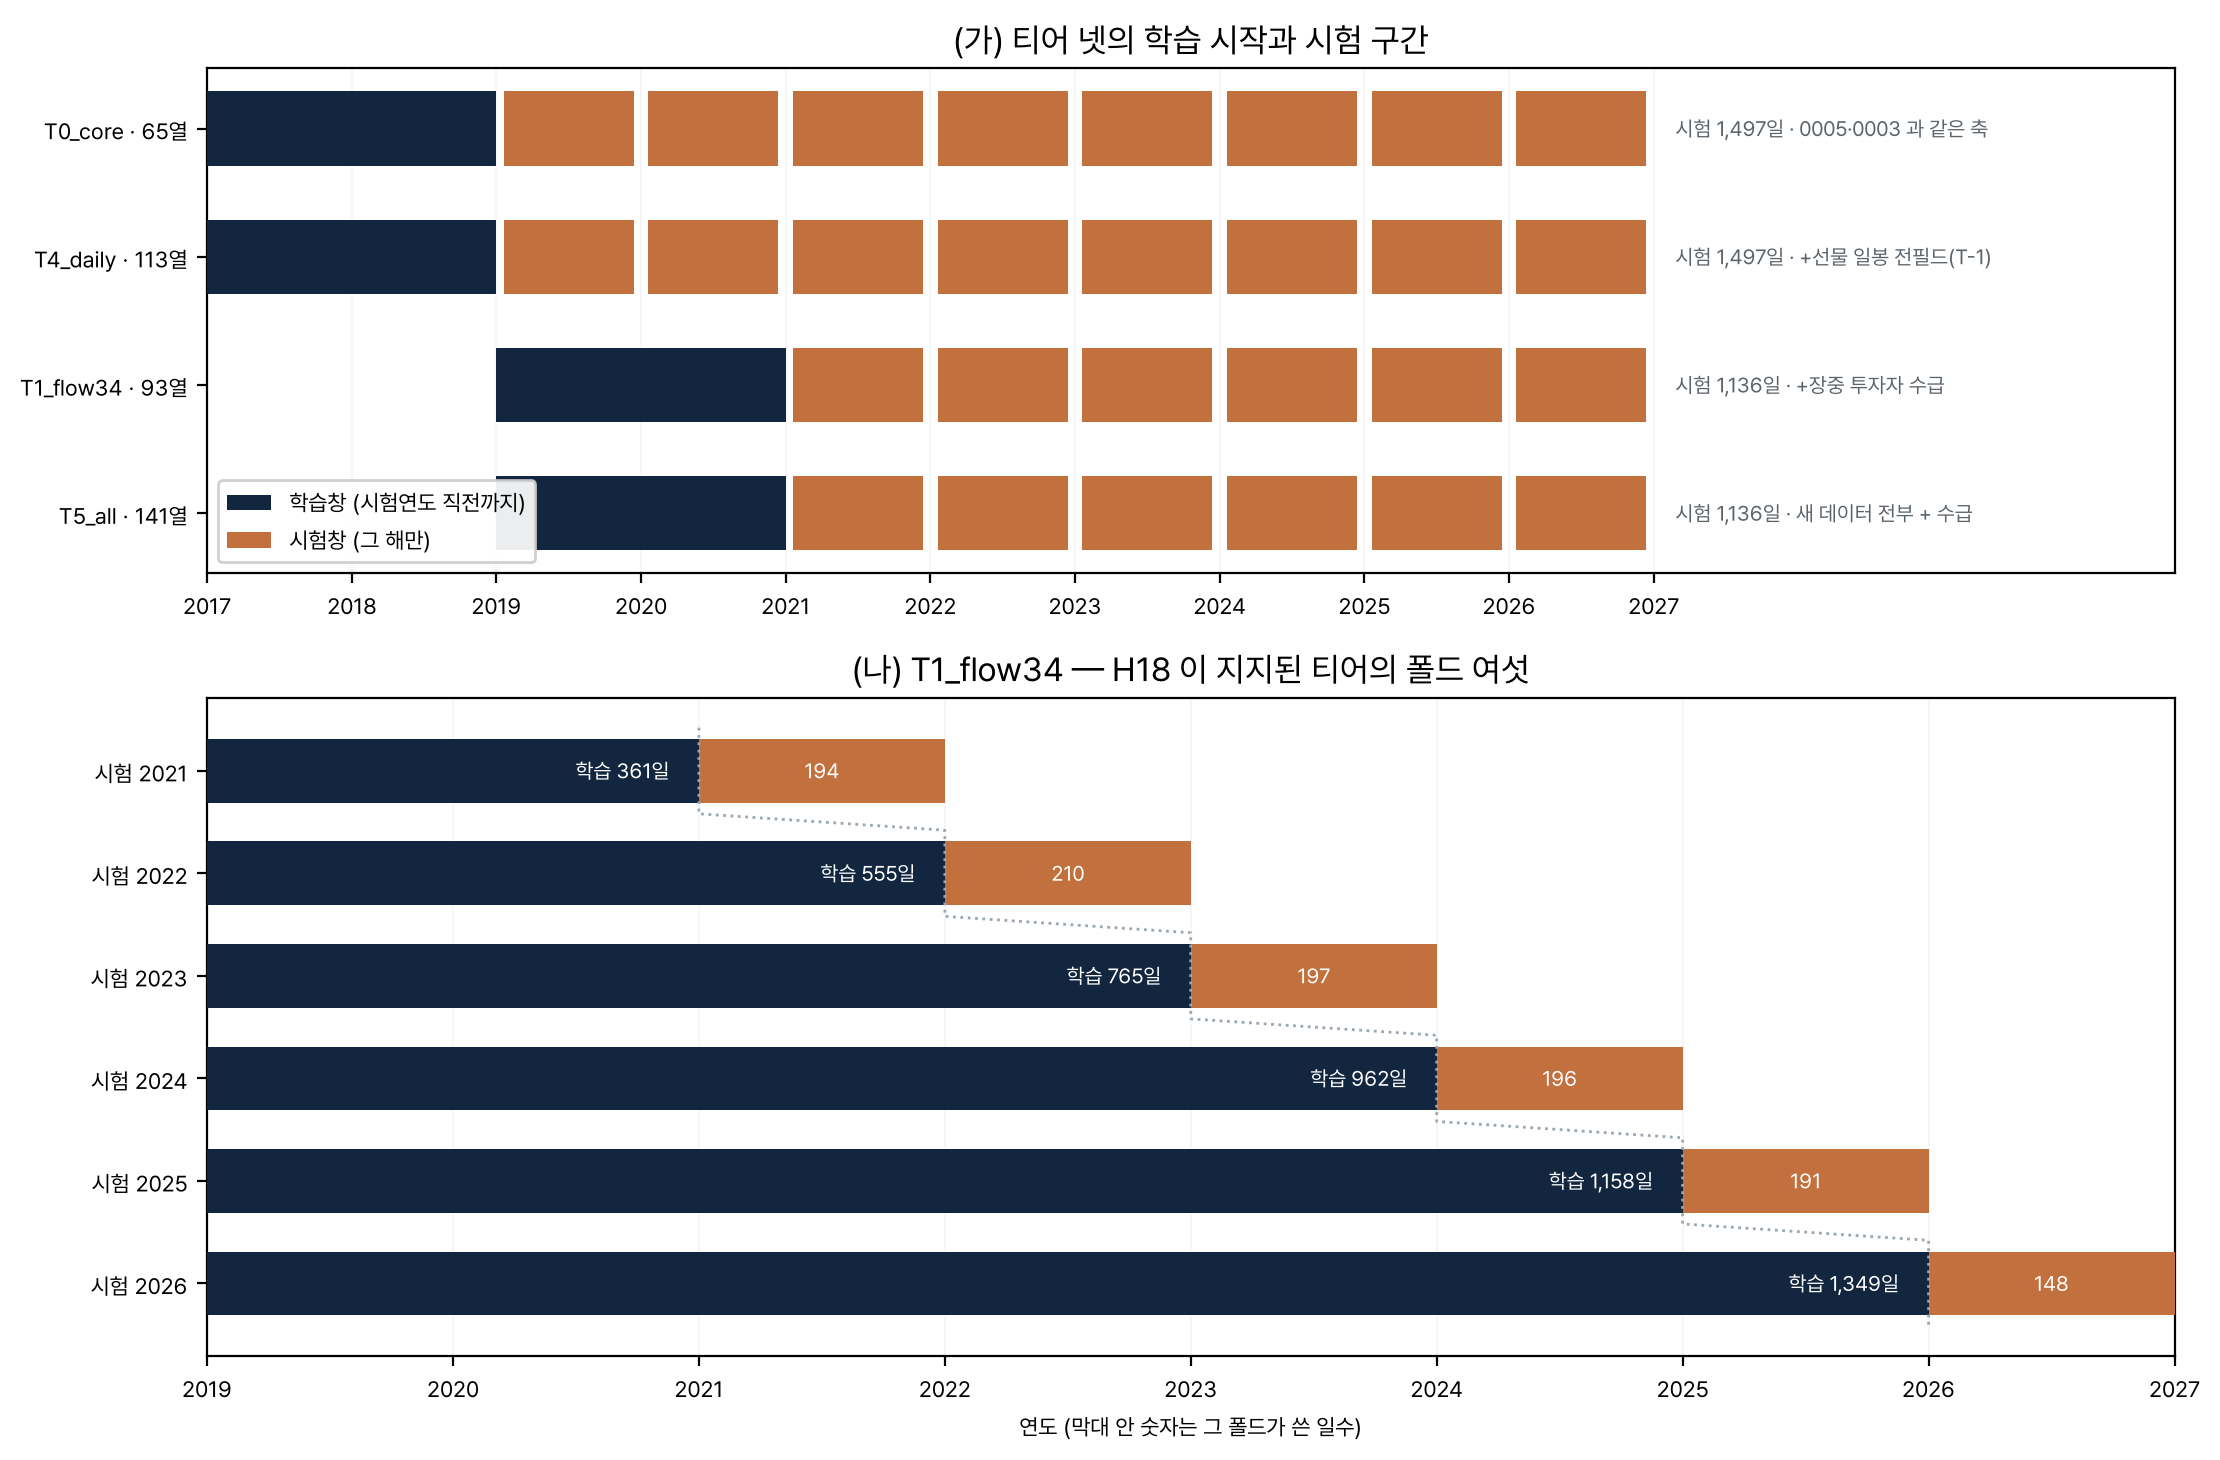
T0_core와
T4_daily 는 2017 부터 학습해 여덟 해를 시험하고(n=1,497),
수급을 쓰는 T1_flow34와 T5_all 은 2019 부터라 여섯
해다(n=1,136). 열 수는 실측값이다. 분산 0 열이 폴드 안에서 떨어져
선언값(67, 115, 95, 149)보다 적다. (나) T1_flow34 의 폴드 여섯.
학습이 361일에서 1,349일로 자란다. 막대 안 일수는 정본 런이 직접
기록한 n_train 이다.| 조건 | 무엇 | 왜 |
|---|---|---|
| 승률 | 비교 대상을 넘는다 | 당연한 최소 조건 |
| 유의성 | 같은 시험일에 짝지은 McNemar 양측 p < 0.05 | 불일치 쌍 정확 이항검정. 승률이 높아도 유의하지 않으면 "차이가 있다" 고 쓰지 않는다 |
| 흔들림 | 차이 > spread_deploy × 2 | 신경망은 시드가 결론을 흔든다. 0005 의 mlp 폴드 흔들림 중위가 배깅트리의 약 4배였다 |
0005, 0006 과 세 곳을 다르게 했고 이유를 결과 보기 전에 박았다. 시드 3개 → 10개(신경망의 시드 취약성을 재는 것 자체가 이 실험의 일부다). 흔들림 통계를 배포 형태에 맞췄다(0006 은 배포하지 않는 물건의 흔들림으로 12개 조합을 떨어뜨리고 그 보수성을 사후에 적었다). 머릿수를 정직 선택값으로만 판정한다(0006 이 사후↔정직 간극을 1.4%p 로 실측했다).
학습된 모델 셋
모델 일곱 종 — 같은 폴드에서 무엇을 학습하나
아래 그림은 모식도가 아니다. code/render_model7.py 가 T1_flow34 시험 2026 폴드를 다시 적합해 커밋된 확률이 그대로 나오는지 확인한 뒤, 적합된 객체에서 읽은 값만으로 그린다(docs/AUTORESEARCH.md §1). 일곱을 같은 폴드에 세운 것은 구조를 나란히 읽게 하려는 것이다 — 승률은 이 폴드 하나가 아니라 워크포워드 전체에서 잰 값이고 아래 결과 절에 있다.
| 모델 | 계열 | 설정 수 | 설정 |
|---|---|---|---|
perc | 퍼셉트론·선형 | 3 | perc#00 · penalty=None · alpha=0.0 |
perc#01 · penalty=l2 · alpha=0.0001 | |||
perc#02 · penalty=l2 · alpha=0.01 | |||
sgd_log | 퍼셉트론·선형 | 6 | sgd_log#00 · alpha=0.0001 · penalty=l2 |
sgd_log#01 · alpha=0.001 · penalty=l2 | |||
sgd_log#02 · alpha=0.01 · penalty=l2 | |||
sgd_log#03 · alpha=0.0001 · penalty=elasticnet | |||
sgd_log#04 · alpha=0.001 · penalty=elasticnet | |||
sgd_log#05 · alpha=0.01 · penalty=elasticnet | |||
sgd_hinge | 퍼셉트론·선형 | 4 | sgd_hinge#00 · alpha=0.0001 |
sgd_hinge#01 · alpha=0.001 | |||
sgd_hinge#02 · alpha=0.01 | |||
sgd_hinge#03 · alpha=0.1 | |||
mlp_sk | 얕은신경망 | 16 | mlp_sk#00 · hidden_layer_sizes=(32, 16) · alpha=0.01 · early_stopping=True |
mlp_sk#01 · hidden_layer_sizes=(32, 16) · alpha=0.01 · early_stopping=False | |||
mlp_sk#02 · hidden_layer_sizes=(16,) · alpha=0.01 · early_stopping=True | |||
mlp_sk#03 · hidden_layer_sizes=(64,) · alpha=0.01 · early_stopping=True | |||
mlp_sk#04 · hidden_layer_sizes=(256,) · alpha=0.01 · early_stopping=True | |||
mlp_sk#05 · hidden_layer_sizes=(64, 32) · alpha=0.01 · early_stopping=True | |||
mlp_sk#06 · hidden_layer_sizes=(128, 64) · alpha=0.01 · early_stopping=True | |||
mlp_sk#07 · hidden_layer_sizes=(128, 64, 32) · alpha=0.01 · early_stopping=True | |||
mlp_sk#08 · hidden_layer_sizes=(64, 32) · alpha=0.1 · early_stopping=True | |||
mlp_sk#09 · hidden_layer_sizes=(64, 32) · alpha=0.001 · early_stopping=True | |||
mlp_sk#10 · hidden_layer_sizes=(64, 32) · alpha=1.0 · early_stopping=True | |||
mlp_sk#11 · hidden_layer_sizes=(64, 32) · alpha=0.01 · early_stopping=False | |||
mlp_sk#12 · hidden_layer_sizes=(64, 32) · alpha=0.01 · early_stopping=True · activation=tanh | |||
mlp_sk#13 · hidden_layer_sizes=(64, 32) · alpha=0.01 · early_stopping=True · learning_rate_init=0.01 | |||
mlp_sk#14 · hidden_layer_sizes=(64, 32) · alpha=0.01 · early_stopping=True · learning_rate_init=0.0001 | |||
mlp_sk#15 · hidden_layer_sizes=(256, 128) · alpha=1.0 · early_stopping=True | |||
mlp_t | 얕은신경망 | 12 | mlp_t#00 · d_layers=(64, 32) · dropout=0.1 · swa=False |
mlp_t#01 · d_layers=(64, 32) · dropout=0.3 · swa=False | |||
mlp_t#02 · d_layers=(64, 32) · dropout=0.1 · swa=True | |||
mlp_t#03 · d_layers=(128, 64) · dropout=0.1 · swa=False | |||
mlp_t#04 · d_layers=(128, 64) · dropout=0.3 · swa=False | |||
mlp_t#05 · d_layers=(128, 64) · dropout=0.3 · swa=True | |||
mlp_t#06 · d_layers=(256, 128) · dropout=0.3 · swa=False | |||
mlp_t#07 · d_layers=(32,) · dropout=0.1 · swa=False | |||
mlp_t#08 · d_layers=(32,) · dropout=0.1 · swa=True | |||
mlp_t#09 · d_layers=(128, 64, 32) · dropout=0.3 · swa=False | |||
mlp_t#10 · d_layers=(128, 64) · dropout=0.1 · weight_decay=0.1 · swa=False | |||
mlp_t#11 · d_layers=(128, 64) · dropout=0.1 · lr=0.0003 · swa=False | |||
resnet_t | 깊은신경망 | 6 | resnet_t#00 · n_blocks=2 · d_main=64 · dropout=0.1 |
resnet_t#01 · n_blocks=2 · d_main=128 · dropout=0.3 | |||
resnet_t#02 · n_blocks=3 · d_main=64 · dropout=0.3 | |||
resnet_t#03 · n_blocks=3 · d_main=128 · dropout=0.3 | |||
resnet_t#04 · n_blocks=4 · d_main=64 · dropout=0.3 | |||
resnet_t#05 · n_blocks=2 · d_main=256 · dropout=0.5 | |||
emb_mlp | 임베딩신경망 | 8 | emb_mlp#00 · emb=ple · n_bins=16 · d_embedding=16 · d_layers=(64, 32) · dropout=0.1 |
emb_mlp#01 · emb=ple · n_bins=8 · d_embedding=16 · d_layers=(64, 32) · dropout=0.1 | |||
emb_mlp#02 · emb=ple · n_bins=24 · d_embedding=16 · d_layers=(64, 32) · dropout=0.1 | |||
emb_mlp#03 · emb=ple · n_bins=16 · d_embedding=24 · d_layers=(128, 64) · dropout=0.1 | |||
emb_mlp#04 · emb=ple · n_bins=16 · d_embedding=16 · d_layers=(64, 32) · dropout=0.3 | |||
emb_mlp#05 · emb=periodic · d_embedding=16 · d_layers=(64, 32) · dropout=0.1 | |||
emb_mlp#06 · emb=periodic · d_embedding=24 · d_layers=(128, 64) · dropout=0.1 | |||
emb_mlp#07 · emb=periodic · d_embedding=16 · d_layers=(64, 32) · dropout=0.3 | |||
| 합계 | 계열 4 | 55 | 티어 4종 × 시드 10개 = 15,400 적합 |
격자에서 뺀 모델 — ft_tr: 라운드 0 실측: 가장 싼 설정(d_token=64·n_blocks=2)이 큰 폴드에서 1,362.6초 — 사전등록 상한 90초의 15배. 한 단계 더 줄여도(d_token=32·n_blocks=1) 약 170초로 1.9배. 본 스윕 예산의 94%(280.9/298.3시간).
퍼셉트론 원형 perc
틀린 날에만 가중치를 그 날 피처만큼 밀어 주는, 1958년의 그 규칙이다. 은닉층이 없어 결정 경계가 초평면 하나다. 확률이 없어 결정함수를 학습 마진의 표준편차로 눌러 0.5 주변 기울기를 맞췄다 — 부호만 쓰는 채점이라 그 변환은 순위를 바꾸지 않는다.
coef_ 에서 읽은 값이다.확률적 경사하강 · 로그 손실 sgd_log
같은 초평면을 로지스틱 손실로 찾는다. 퍼셉트론과 다른 것은 손실 하나뿐이라, 둘의 차이가 «틀린 날만 보나 vs 확신까지 보나» 를 가른다.
coef_ 에서 읽은 값이다.확률적 경사하강 · 힌지 손실 sgd_hinge
여유(margin)를 두고 가르는 손실이다. 선형 SVM 과 같은 목적을 온라인으로 푼다. T5_all 의 정직 선택이 2022년에 이것을 골랐다.
coef_ 에서 읽은 값이다.sklearn 다층 퍼셉트론 — 0005 가 쓴 그 설정 mlp_sk#00
은닉 두 층(32·16)에 L2 벌점 0.01, 조기 종료를 켠 구성이다. 앞선 실험의 신경망은 이것 하나였고 0007 은 이 자리에서 시작한다 — H17 의 비교가 같은 코드 경로 위에서 성립하게 #00 에 박았다.
mlp 설정 그대로다 — H17 의 비교가 같은 코드 경로 위에서 성립하게 #00 에 박았다. 전처리 세 단계는 학습창만 보고 적합한다.coefs_에서 읽은 값이다. 입력이 93열인 것은 분산 0 열 둘이 이 폴드에서 떨어진 결과다(선언 95열).max_iter=600 이고 조기 종료가 먼저 물었다.torch 다층 퍼셉트론 mlp_t#00
같은 은닉 구조를 직접 학습한다. sklearn 으로는 못 쓰는 것들이 여기 들어간다 — 층마다 층 정규화와 드롭아웃, AdamW 와 코사인 스케줄, 라벨 평활 0.05. H19 의 짝 비교에서 임베딩 쪽의 상대다.
named_parameters() 에서 읽었다 — 손으로 적은 숫자가 없다. 상자 안의 텐서는 앞의 둘만 적었고 전수는 아래 표에 있다.| # | 모듈 | 종류 | 텐서 | 모양 | 원소 수 |
|---|---|---|---|---|---|
| 1 | 0 | Linear | weight | [64, 93] | 5,952 |
| bias | [64] | 64 | ||
| 2 | 1 | LayerNorm | weight | [64] | 64 |
| bias | [64] | 64 | ||
| 3 | 4 | Linear | weight | [32, 64] | 2,048 |
| bias | [32] | 32 | ||
| 4 | 5 | LayerNorm | weight | [32] | 32 |
| bias | [32] | 32 | ||
| 5 | 8 | Linear | weight | [2, 32] | 64 |
| bias | [2] | 2 | ||
| 합계 | 10개 텐서 | 8,354 |
min_epochs=60 바닥이 멈춤 지점을 정했다. 검증 집합이 135행뿐이라 조기 종료 신호가 잡음이기 때문이다(protocol.md §8-2).잔차 연결 다층 퍼셉트론 resnet_t#00
층을 더 쌓되 각 블록이 입력을 그대로 더해 통과시킨다. 깊이를 늘려도 학습이 무너지지 않게 하는 구조이고, T5_all(141열)의 정직 선택이 이것을 골랐다.
named_parameters() 에서 읽었다 — 손으로 적은 숫자가 없다. 상자 안의 텐서는 앞의 둘만 적었고 전수는 아래 표에 있다.| # | 모듈 | 종류 | 텐서 | 모양 | 원소 수 |
|---|---|---|---|---|---|
| 1 | first | Linear | weight | [64, 93] | 5,952 |
| bias | [64] | 64 | ||
| 2 | blocks.0.norm | LayerNorm | weight | [64] | 64 |
| bias | [64] | 64 | ||
| 3 | blocks.0.lin1 | Linear | weight | [128, 64] | 8,192 |
| bias | [128] | 128 | ||
| 4 | blocks.0.lin2 | Linear | weight | [64, 128] | 8,192 |
| bias | [64] | 64 | ||
| 5 | blocks.1.norm | LayerNorm | weight | [64] | 64 |
| bias | [64] | 64 | ||
| 6 | blocks.1.lin1 | Linear | weight | [128, 64] | 8,192 |
| bias | [128] | 128 | ||
| 7 | blocks.1.lin2 | Linear | weight | [64, 128] | 8,192 |
| bias | [64] | 64 | ||
| 8 | head.0 | LayerNorm | weight | [64] | 64 |
| bias | [64] | 64 | ||
| 9 | head.2 | Linear | weight | [2, 64] | 128 |
| bias | [2] | 2 | ||
| 합계 | 18개 텐서 | 39,682 |
min_epochs=60 바닥이 멈춤 지점을 정했다. 검증 집합이 135행뿐이라 조기 종료 신호가 잡음이기 때문이다(protocol.md §8-2).임베딩 다층 퍼셉트론 emb_mlp#06 — H18 이 지지된 자리
수치 피처 하나를 주기 함수 묶음으로 펼쳐 24차원 벡터로 만든 뒤 다층 퍼셉트론에 넣는다. 표 데이터에서 다층 퍼셉트론의 이득이 가장 큰 기법으로 보고된 축이고, 이 실험에서 계열 1위가 됐다 — 다만 그 순서를 «차이» 라고 부를 근거는 없다(H19 미지지).
named_parameters() 에서 읽었다 — 손으로 적은 숫자가 없다. 상자 안의 텐서는 앞의 둘만 적었고 전수는 아래 표에 있다.| # | 모듈 | 종류 | 텐서 | 모양 | 원소 수 |
|---|---|---|---|---|---|
| 1 | emb | PeriodicEmbeddings | periodic.weight | [93, 48] | 4,464 |
| linear.weight | [93, 96, 24] | 214,272 | ||
| linear.bias | [93, 24] | 2,232 | ||
| 2 | body.0 | Linear | weight | [128, 2232] | 285,696 |
| bias | [128] | 128 | ||
| 3 | body.1 | LayerNorm | weight | [128] | 128 |
| bias | [128] | 128 | ||
| 4 | body.4 | Linear | weight | [64, 128] | 8,192 |
| bias | [64] | 64 | ||
| 5 | body.5 | LayerNorm | weight | [64] | 64 |
| bias | [64] | 64 | ||
| 6 | body.8 | Linear | weight | [2, 64] | 128 |
| bias | [2] | 2 | ||
| 합계 | 13개 텐서 | 515,562 |
min_epochs=60 바닥이 멈춤 지점을 정했다. 검증 집합이 135행뿐이라 조기 종료 신호가 잡음이기 때문이다(protocol.md §8-2).티어 넷의 결과
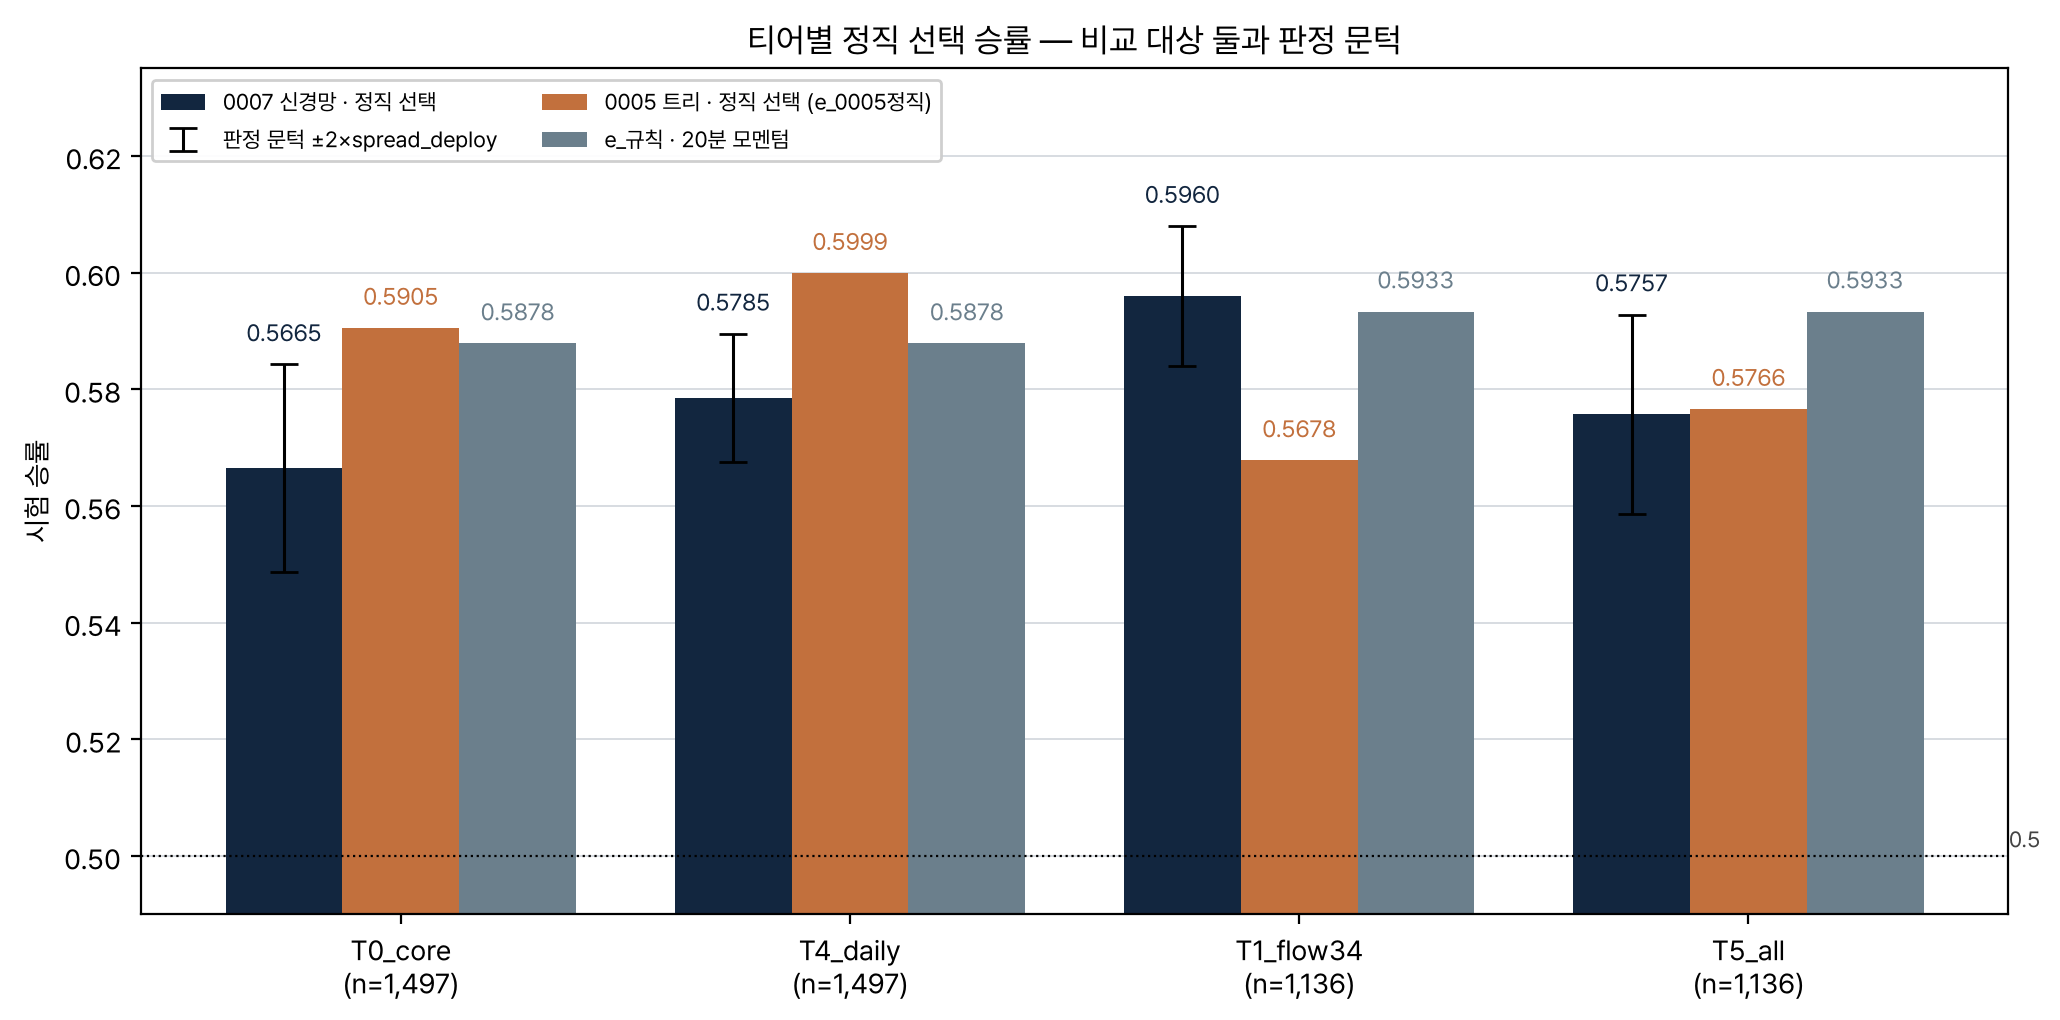
spread_deploy)
이다. T1_flow34 에서만 남색이 주황을 넘는다. 그리고 그
자리에서 남색과 회색이 거의 같다. T4_daily 는 반대로 주황이
가장 높다.| 티어 | n | 신경망 정직 | 누적틱 | e_0005정직 | 차 | 문턱 ±2σ | McNemar p | 판정 |
|---|---|---|---|---|---|---|---|---|
T0_core | 1,497 | 0.5665 | +441 | 0.5905 | −0.0240 | 0.0178 | 0.0642 | 미지지 |
T4_daily | 1,497 | 0.5785 | +515 | 0.5999 | −0.0214 | 0.0110 | 0.0676 | 미지지 |
T1_flow34 | 1,136 | 0.5960 | +551 | 0.5678 | +0.0282 | 0.0120 | 0.0416 | 지지 |
T5_all | 1,136 | 0.5757 | +409 | 0.5766 | −0.0009 | 0.0171 | 1.0000 | 동급 |
T5_all 의 동급은 사전등록 정의를 그대로 만족한다. 차이 0.0009
가 문턱 0.0171 안이고 p=1.0000 이다. "신경망이 트리와 같다" 가 아니라 "이
표본에서 둘을 가르지 못했다" 고 읽는다.
e_0005정직 은 저장소에 두 절차로 두 숫자가 있었다.
0005 의 run2.honest_pick(동률을 이름 순으로, 첫 해 대체가
et)와 0006 의 prior_ranking(동률을 열 순서로, 첫 해
대체가 순위 첫 열)이다. 둘 다 정당하므로 티어별로 큰 쪽을 박았다. 어느
동률 규칙을 쓰든 신경망이 넘어야 한다. 문턱을 높이는 선택이고, 결과를
보기 전에 했다.
| 티어 | 신경망 정직 | 튠한 트리 정직 | 차 | 문턱 ±2σ | McNemar p | 짝 일수 | 판정 |
|---|---|---|---|---|---|---|---|
T0_core | 0.5665 | 0.5752 | −0.0087 | 0.0178 | 0.5440 | 1,497 | 동급 |
T4_daily | 0.5785 | 0.5965 | −0.0180 | 0.0110 | 0.1390 | 1,497 | 미지지 |
T1_flow34 | 0.5960 | 0.5687 | +0.0273 | 0.0120 | 0.0591 | 1,136 | 미지지 |
T5_all | 0.5757 | 0.5731 | +0.0026 | 0.0171 | 0.9011 | 1,136 | 동급 |
T1_flow34 의 승이 여기서 사라진다. 승률 차이(+2.73%p)와
흔들림 문턱은 그대로 통과하는데 McNemar 가 0.0416 에서 0.0591 로 올라
문턱 0.05 를 넘는다. 사전등록 문장은 셋을 다 요구한다.
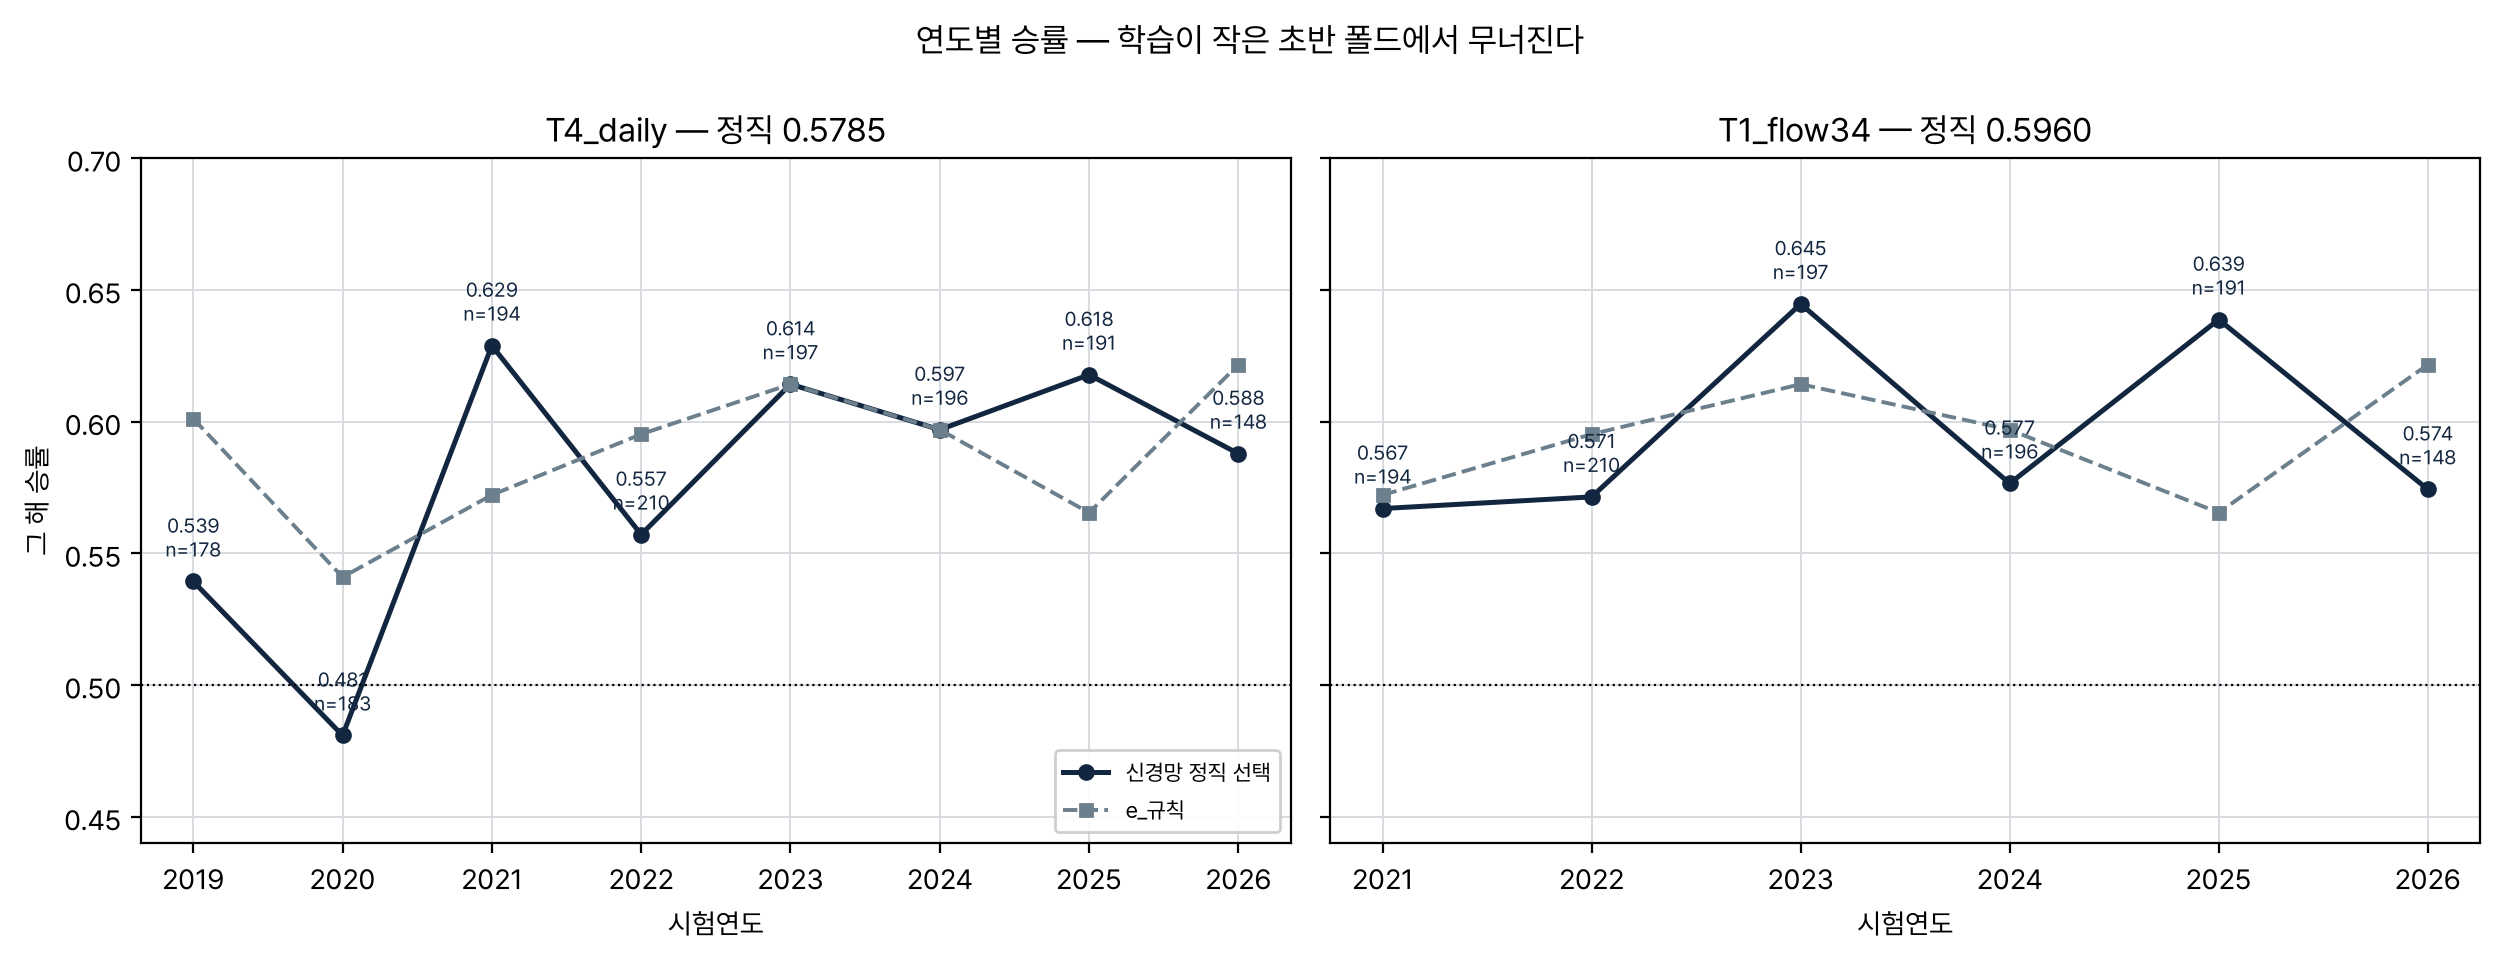
T4_daily 의 초반 두 폴드(학습 344일과 522일)가
0.5393, 0.4809 로 무너지고, 학습이 705일을 넘는 2021 부터 0.6289 로
올라온다. 합산 승률만 보면 안 보인다. T1_flow34 는 여섯 해 전부
56% 이상이지만 규칙(점선)을 넘은 해는 2023과 2025 둘뿐이고 2026 은 규칙에
4.7%p 뒤진다.규칙을 못 넘었다
| 티어 | 신경망 정직 | e_규칙 | 차 | 문턱 ±2σ | 규칙 대비 McNemar p | e_적응상수 | 사후 최고 |
|---|---|---|---|---|---|---|---|
T0_core | 0.5665 | 0.5878 | −0.0214 | 0.0178 | 0.1587 | 0.5504 | 0.6019 |
T4_daily | 0.5785 | 0.5878 | −0.0094 | 0.0110 | 0.5157 | 0.5504 | 0.6005 |
T1_flow34 | 0.5960 | 0.5933 | +0.0026 | 0.0120 | 0.9037 | 0.5537 | 0.5968 |
T5_all | 0.5757 | 0.5933 | −0.0176 | 0.0171 | 0.3246 | 0.5537 | 0.6004 |
네 티어 중 규칙을 넘은 것은 하나뿐이고, 그 하나도 +0.26%p, p=0.9037 이다. 문턱 0.0120 의 5분의 1에 못 미친다. 적응상수는 네 티어 다 넘는다.
대조가 이 실험의 결론을 정한다. 0005 라운드 1 의 트리는
T4_daily 에서 규칙을 +1.21%p 넘었다(정직 0.5999 대 0.5878).
신경망은 그 티어에서 0.5785 로 규칙 아래다. 즉 H18 이 지지된 자리는 트리가
가장 약한 티어이고, 그 티어에서는 신경망도 규칙 수준이다. 신경망이 이긴 것은
상대가 약한 자리였다.
흔들림을 다시 정의한 자리
사전등록 §4-1 에서 흔들림 통계를 배포하는 물건(시드 평균)에 맞춰 다시 정의했다. 0006 은 배포하지 않는 물건(단일 시드 모델)의 흔들림으로 12개 조합을 전부 떨어뜨리고 그 보수성을 결과를 본 뒤에 적었다. 0007 은 먼저 적었다.
바꾼 정의가 판정을 사 왔는지 옛 정의로도 다시 재서 확인한다.
| 티어 | 차이 | 새 문턱 (배포 ×2) | 옛 문턱 (단일시드 ×2) | 새 정의 | 옛 정의 |
|---|---|---|---|---|---|
T0_core | −0.0240 | 0.0178 | 0.0387 | 못 통과 | 못 통과 |
T4_daily | −0.0214 | 0.0110 | 0.0191 | 못 통과 | 못 통과 |
T1_flow34 | +0.0282 | 0.0120 | 0.0260 | 통과 | 통과 |
T5_all | −0.0009 | 0.0171 | 0.0266 | 동급 | 동급 |
T1_flow34 는 옛 문턱(0.0260)으로도 차이 0.0282 가 넘는다.
간발이지만 넘는다. 재정의는 판정을 사 온 것이 아니고, 0006 이 사후에
"보수적이었다" 고 적은 자리를 사전에 정리한 것이다.
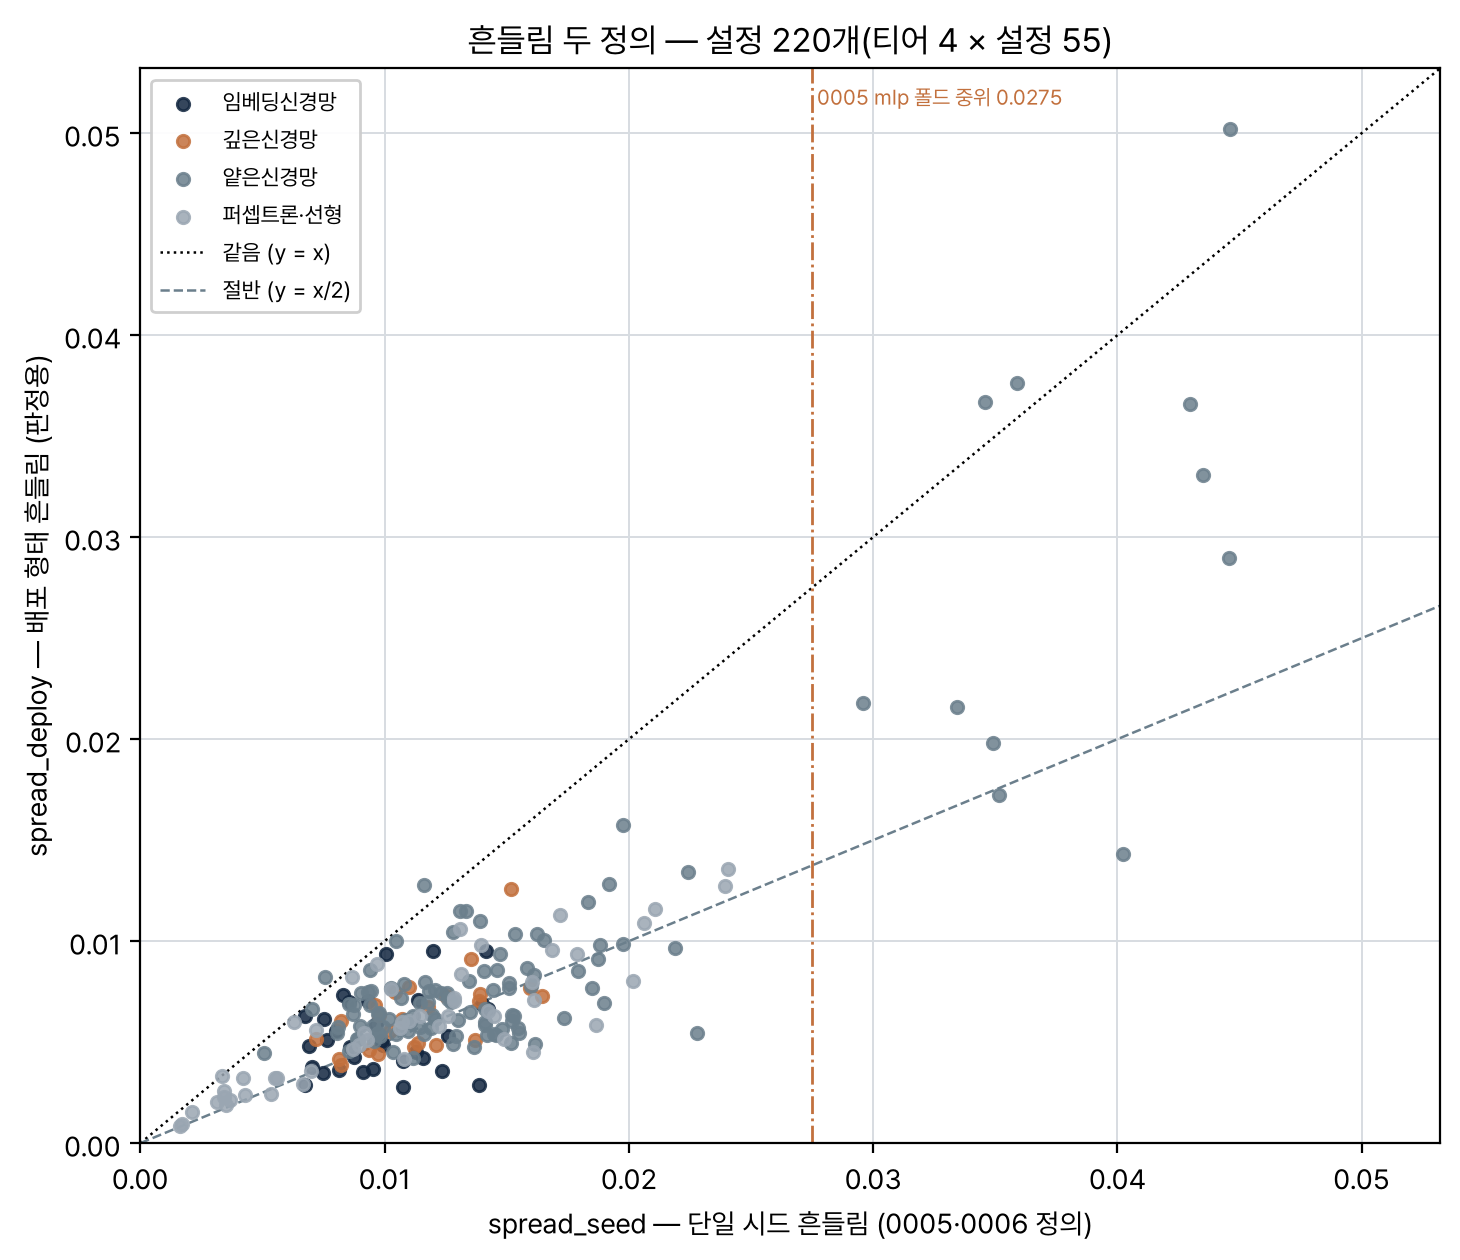
mlp 폴드 흔들림 중위 0.0275 다. 시드 열 개를 평균하는 것만으로
신경망의 시드 취약성이 배깅트리 수준(0.0071)까지 내려온다. 배포 중위가
0.0049~0.0070 이다.계열 순서 예측이 틀렸다
사전등록 §6 에 이렇게 적었다: "학습 폴드가 344~1,693행이라 용량이 구속 조건이므로 용량이 작은 쪽이 이긴다." 표 데이터 딥러닝 문헌의 순서(임베딩 > FT-T ≈ ResNet > MLP)와 다르게 적은 것이 이 실험의 예측이었다.
관측은 반대다. 임베딩(파라미터 515,562개)이 맨 MLP(23,362개)를 이겼다.
| 계열 | 중위 승률 | 사전등록 자리 | 관측 자리 |
|---|---|---|---|
임베딩신경망 (emb_mlp) | 0.5855 | 2위 | 1위 |
깊은신경망 (resnet_t) | 0.5759 | 3위 | 2위 |
얕은신경망 (mlp_sk·mlp_t) | 0.5755 | 1위 | 3위 |
퍼셉트론·선형 (perc·sgd_*) | 0.5327 | 4위 | 4위 |
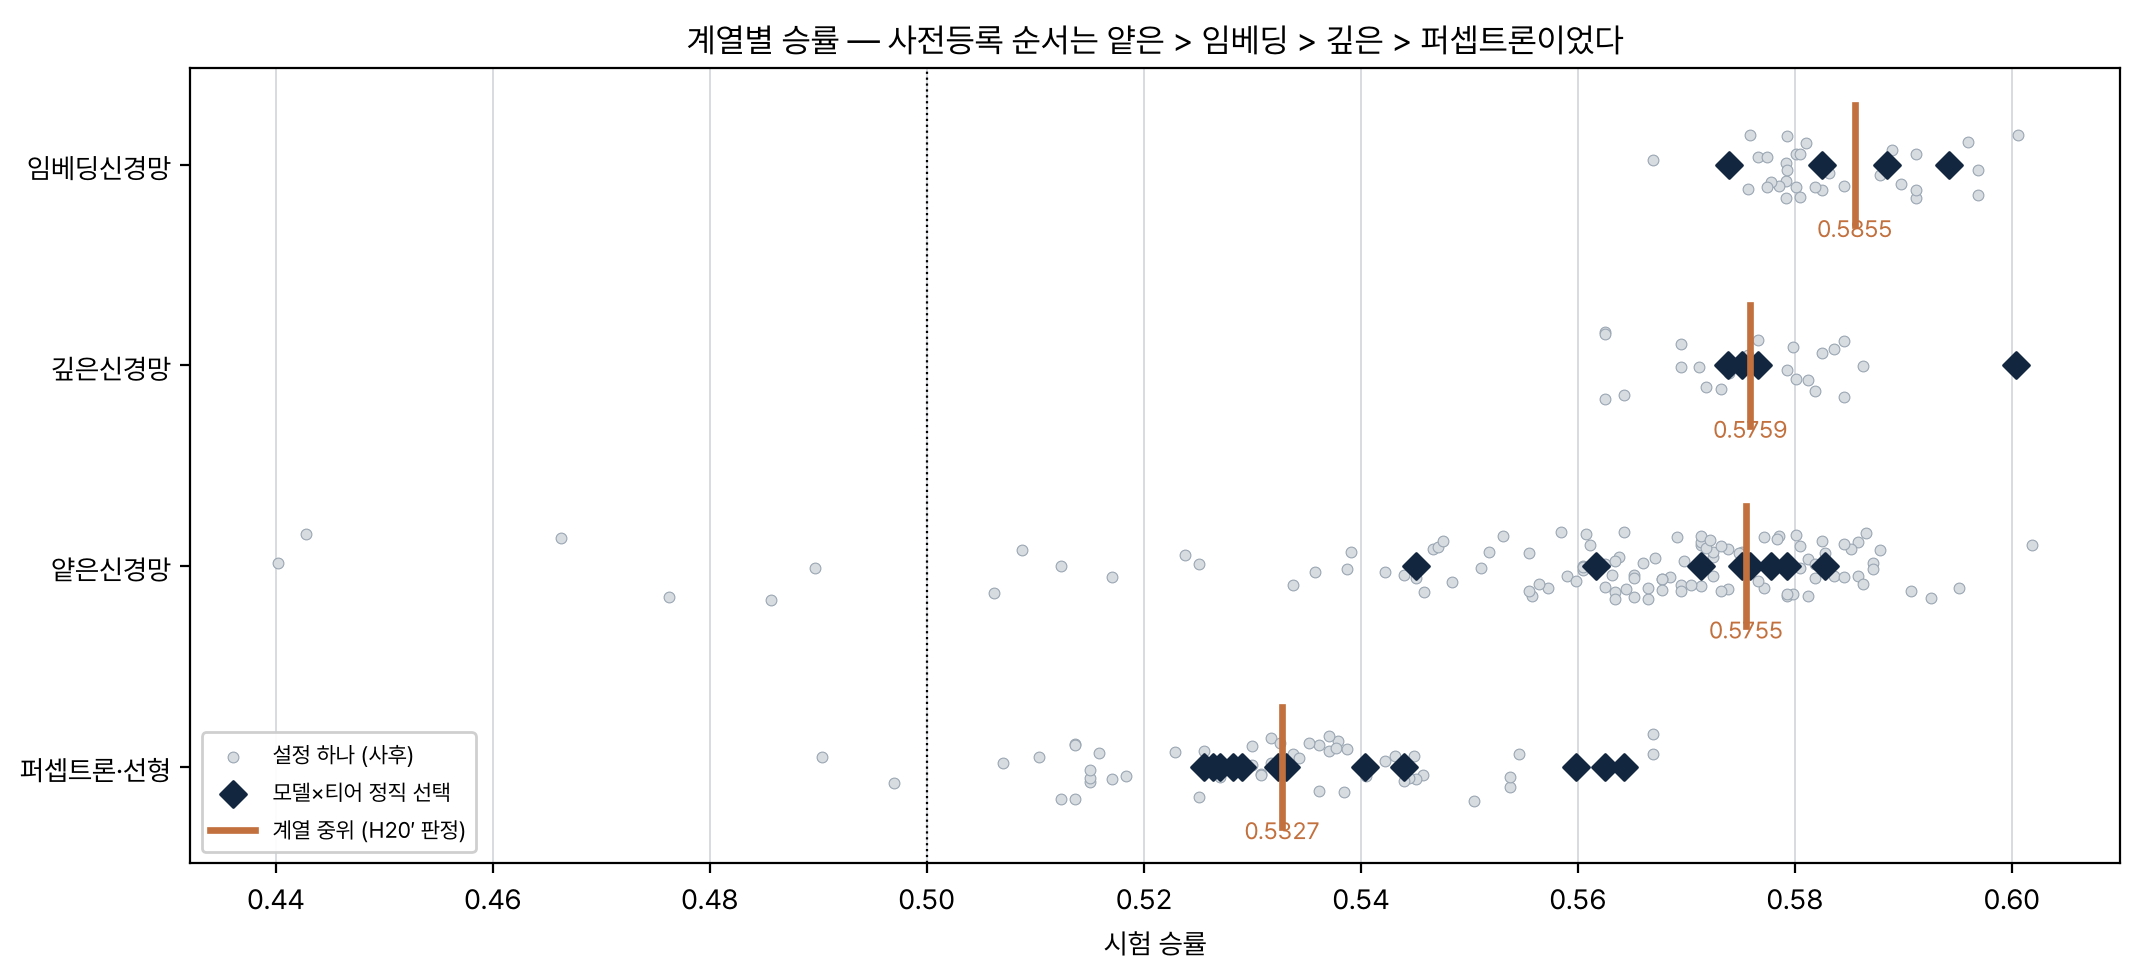
맞은 것이 하나 있다. 퍼셉트론과 선형이 꼴찌다(0.5327, 위 세 계열과 4.3%p 차).
퍼셉트론 원형(perc)은 네 티어에서 0.5255~0.5331 로
e_적응상수(0.5504)조차 못 넘는다. 적응상수 대비 McNemar
p < 0.05 를 통과한 모델은 emb_mlp와 resnet_t
둘뿐이고, mlp_sk, mlp_t, perc,
sgd_* 는 한 자리도 없다.
놀란 자리: periodic 임베딩이 사후 최고 넷 중 둘이고
ple(분위수 조각선형)는 상위에 한 번도 없다. 학습 344행에서 구간당
7행이라 지나치게 잘게 쪼갠 것으로 보인다. 구간 수를 학습행/8 로
이미 물려 놓았음에도 그렇다.
FT-Transformer 는 이 실험에 없다. 라운드 0 의
비용 측정에서 가장 싼 설정(d_token=64 · n_blocks=2)이 큰 폴드에서
1,362.6초가 걸렸다. 사전등록 상한 90초의 15배이고 본 스윕 예산의 94%
(직렬 298.3시간 중 280.9시간)였다. 폭과 깊이를 한 단계 더 줄여도 약 170초로
1.9배다. 사전등록 규약대로 격자에서 뺐고 이름을 적었다. 그래서 계열
다섯을 묶던 원래 H20 은 미판정으로 남긴다. 조용히 지우지 않는다.
한계
초반 폴드가 결론을 끌어내린다. 최소 학습 폴드 344행, 실측 113열 이면 행/피처가 3.04 다. 두 티어가 그 자리에서 50% 아래로 내려간다. 이것은 데이터의 성질이고, 고치려면 모델이 아니라 표본이 필요하다.
T1_flow34와 T5_all 은 n=1,136 이고 시험이 여섯
해뿐이다. n=1,497, 여덟 해인 두 티어와 승률을 섞어 비교하지 않았다.
ple 임베딩이 이 표본 크기에서 제대로 시험되지 않았다.
구간을 학습행/8 로 물려도 344행에서 구간당 7행이다.
조기 종료의 실제 구속은 검증이 아니라 min_epochs 다.
torch 네 모델이 전부 60에폭(바닥)에서 멈췄다. 작은 폴드의 검증 집합이 34행
뿐이라 그 신호가 잡음이기 때문이다. "학습을 언제 멈추나" 는 이 실험이 탐색하지
않은 축이다.
GPU 가 없다. CPU 12스레드, torch 2.14.0+cpu. 벽시계는
기록했지만 모델 선택의 근거로 쓰지 않았다. 레짐별 분해도 하지 않았다.
캐파시티와 비용 축은 비해당(방향 채점 게임이라 체결이 없다).
산출물
- 사전등록
protocol.md - 분석과 판정
analysis.md - 정본 런
results/20260922_144439_nn/ - 모델 격자와 학습기
code/nnmodels.py - 그림
code/render_figures.py - 구조도
code/render_model7.py - 입력(0005)
experiments/0005_flow_api_model_zoo/