국채선물 · 국고채 현물

안 쓰던 표 다섯에 물어본 다섯 가지

덤프에 있으면서 지금까지 어떤 실험도 값으로 읽지 않은 표를 다섯 개 골라, 표마다 예측 문제를 하나씩 붙였다. 모델 격자는 고정하고 데이터 축만 움직였다. 다섯 중 셋이 사전등록 문턱을 넘었고, 그중 하나는 이 저장소에서 처음으로 단순 규칙을 유의하게 넘었다.

채택 3 · 미지지 2 시험 2021~2026 적합 135건 · 벽시계 3분 런 1회 (정본)

야간 미국채가 국채선물 개장 갭의 82.85%를 방향으로 맞히고(규칙 78.78% · 짝지은 McNemar p=0.0011), 종목 대차·외국인 잔고가 익일 상대가치에서 일별 랭크 IC +0.0251(Newey-West t=2.37)을 내며, 장마감 현선 괴리는 되돌지 않고 이어진다(66.87% · 적응 상수 대비 +1.28%p · p=0.0071). 반대로 국고채 입찰 결과와 단기자금 금리는 각각 오후 방향·익일 커브 기울기를 말하지 않았다.

무엇을 물었나

앞선 실험들은 같은 피처 스토어를 돌려 쓰며 모델만 바꿨다. 이 실험은 축을 데이터로 돌린다. 표마다 그 표가 자연스럽게 답할 수 있는 문제를 하나씩 세우고, 모델은 계열 넷(선형·배깅트리·부스팅·거리)으로 고정한다. 이기고 지는 것이 데이터 때문인지만 보려는 것이다.

H24 · P1
야간(전일 15:45 → 당일 08:45) 해외 금리가 3년 국채선물 개장 갭을 규정한다. 모델이 «미국채 10년 금리의 반대 부호» 규칙을 넘는다.
H25 · P2
국고채 입찰 결과(응찰율·부분낙찰율·테일)가 그날 오후 선물 방향을 담고 있다.
H26 · P3
종목별 대차잔량·외국인 잔고가 익일 상대 리치/치프를 예측한다(대차가 늘면 상대적으로 싸진다).
H27 · P4
단기자금 긴장(CD·콜·KOFR 스프레드)이 익일 3선↔10선 기울기를 예측한다.
H28 · P5
장마감 현선 괴리(잔차)가 익일 되돌림을 예측한다.

기호: = 국채선물 호가 한 칸(0.01) · bp = 0.01%p · 잔차 = 종목 금리에서 그날 커브 회귀선을 뺀 값 · 랭크 IC = 하루 횡단면에서 예측 순위와 실현 순위의 스피어만 상관 · 정직 선택 = 설정을 시험연도 이전 성적만 보고 고르는 것.

데이터셋

다섯 탐침이 쓰는 원천은 아래와 같다. 앞선 실험이 값으로 읽은 표는 하나 뿐이고(미국채 분봉 ust_intra), 그것도 한국 장중 창에서 다른 타깃에 쓴 것이다 — 여기서는 야간 창이다. 나머지는 이 실험이 처음 연다.

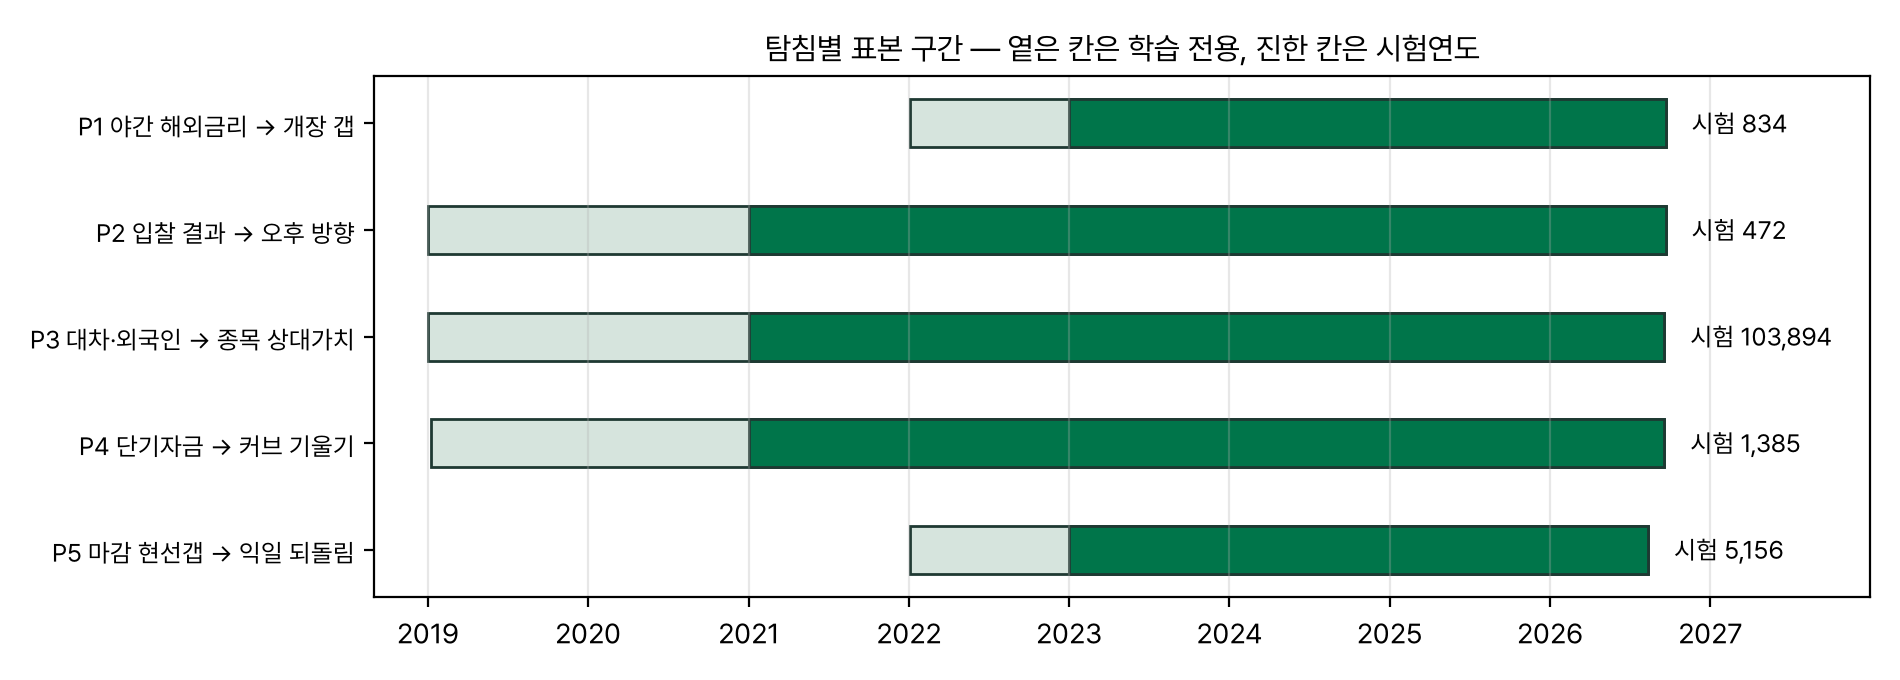
탐침별 표본. 행 수·기간·피처 수는 정본 런의 피처 캐시 (results/_scratch/<탐침>.parquet)에서 읽었다.
탐침새로 쓰는 표해상도기간 피처타깃
P1ust_intra(야간) · ustfut_intra · nasdaq_intra1분 → 일별2022-01-04 ~ 2026-09-21 1,13426개장 갭(틱), 표준편차 11.7
P2국채_입찰(응찰·낙찰 전 필드) 입찰일2019-01-02 ~ 2026-09-21644 2011:00→15:30 변화(틱)
P3국고통_당일대차잔량 · 국고통_외국인_잔고수량 · 국고통_민평 · 국고통_듀레이션 · 국고통_상장잔액 종목 × 일 (144종목 · 하루 평균 69.9종목)2019-01-02 ~ 2026-09-18 132,58312익일 잔차 변화(bp), 표준편차 1.61
P4단기금리(CD·콜·KOFR·통안1년) · daily_data_pool_v3 · 지준일_자체일별 2019-01-08 ~ 2026-09-182,00119 익일 기울기 변화(bp), 표준편차 2.46
P5마감_현선갭(잔차bp) 종목 × 일 (105종목)2022-01-03 ~ 2026-08-12 6,40211익일 같은 종목 잔차(bp)
탐침별 표본 구간
탐침마다 표본 구간이 다르다. 옅은 칸은 학습 전용 구간, 진한 칸은 시험연도다. 미국채 분봉이 2021년부터라 P1 의 표본이 가장 짧고, 현선갭 원장이 2026-08-13 에서 끊겨 P5 의 오른쪽 끝이 앞선다.

look-ahead 를 어디서 끊었나. P1 은 08:45(개장 15분 전, 미국 시장은 05:00 에 닫는다) · P2 는 11:00(경쟁입찰 결과 공표 약 10:40 뒤) · P3·P4·P5 는 T일 종가 원장이다. 피처가 그 시각 뒤 정보를 건드리면 창을 자르는 코드(code/probes9.py_win)에서 잘린다. 롤 당일은 P1 표본에서 뺐다 — 근월 코드가 바뀌는 날의 «갭» 은 야간 뉴스가 아니라 계약 간 스프레드다(19일, 갭 표준편차 41.0틱 대 보통날 11.7틱).

채점과 분할

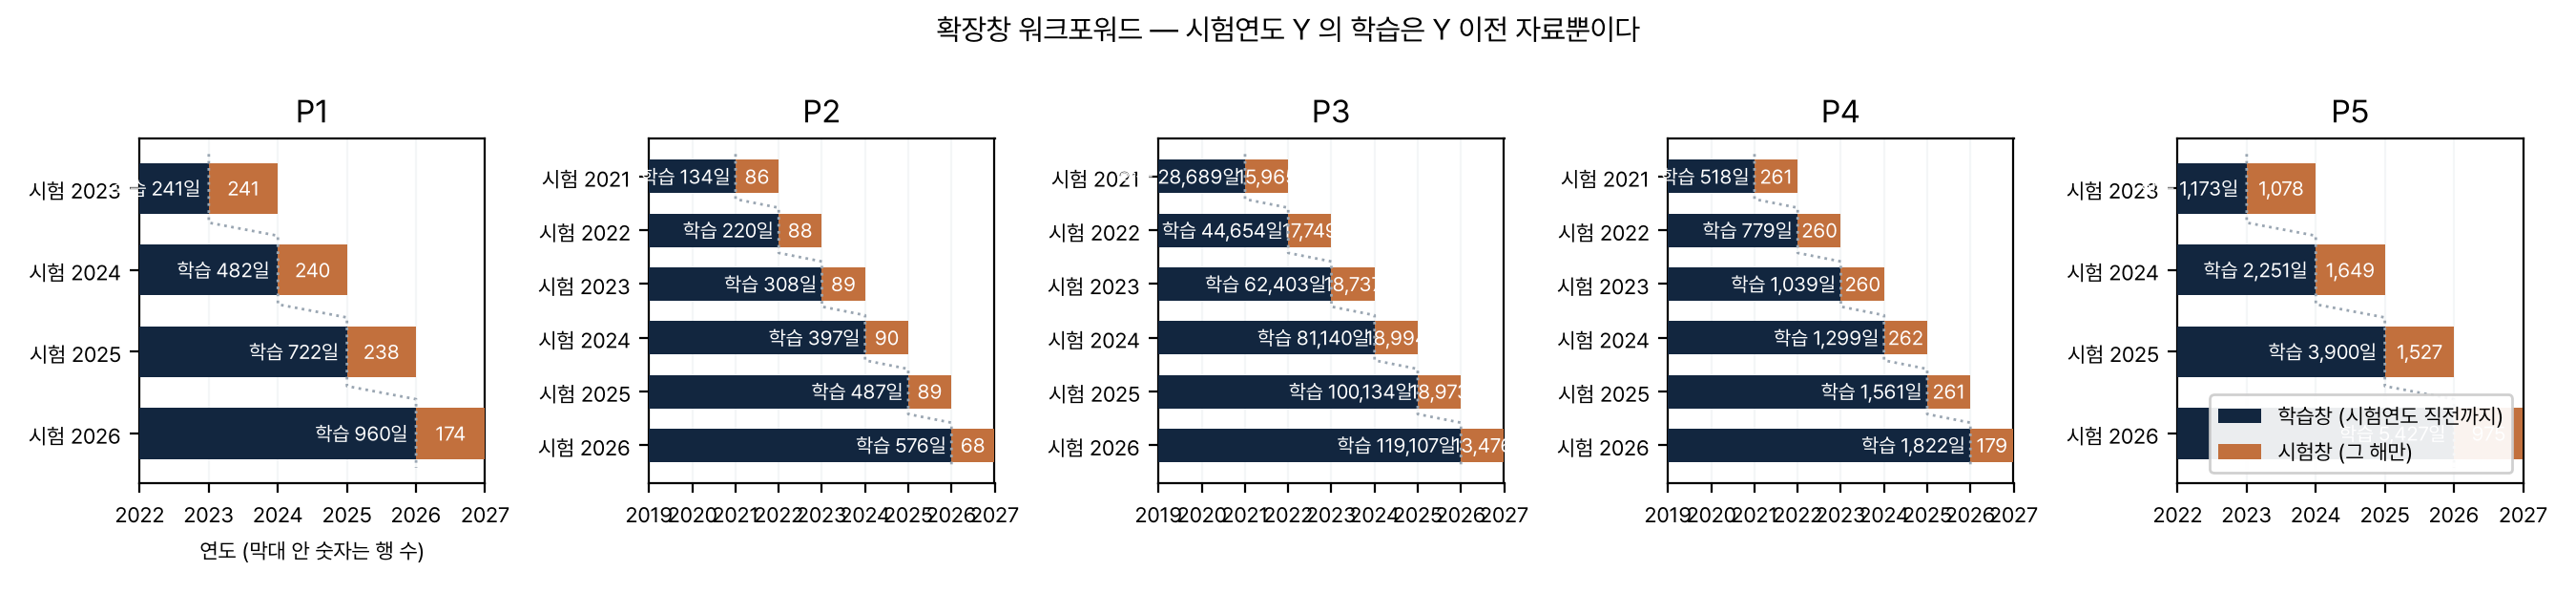
다섯 탐침이 같은 규율로 채점된다. 확장창 워크포워드 — 시험연도 Y 의 학습 표본은 Y 이전 자료뿐이고, 설정 선택도 Y 이전 성적만 본다. 첫 시험연도는 앞이 없어 사전등록한 대체 설정(분류 logit_l2 · 회귀 ridge)을 쓴다. 시드는 5개(0~4)이고 시드가 도는 모델만 흔들림을 잰다.

확장창 워크포워드 폴드
폴드마다 학습창이 넓어지고 시험은 그 해 한 칸이다. 막대 안 숫자는 그 폴드가 쓴 행 수다(P3·P5 는 종목-일이라 수가 크다).

방향 채점은 y ∈ {−1, +1} 만 센다. 변화가 정확히 0 인 표본 (P1 59일 · P2 38일 · P4 98일 · P5 73건)은 무효로 빼고 그 수를 보고한다 — 0 을 한쪽에 붙이면 승률이 그 규칙에서 나온다. 판정 문턱은 실행 전에 박았다.

사전등록 판정 문턱(protocol.md §6). 분류는 셋을 모두, 패널은 둘을 모두 넘어야 채택이다.
갈래문턱 1문턱 2문턱 3
분류(P1·P2·P4·P5)모든 기준선 초과 짝지은 McNemar p<0.05차이 > 시드 흔들림 × 2
패널(P3)일별 IC 평균 > 0 이고 Newey-West(lag 5) t > 2.0 되돌림 기준선과 짝지은 Wilcoxon p<0.05차이 > 시드 흔들림 × 2

모델

격자는 다섯 탐침이 똑같다. 계열 넷을 고르게 두는 것이 목적이다. 분류 여섯, 회귀 셋(P3)이며 하이퍼파라미터는 아래가 전부다.

모델 격자. 전처리는 결측을 학습창 중앙값으로 채우고, 선형·거리 계열만 표준화한다(트리는 단조 변환에 불변이라 필요 없다).
이름계열무엇을 학습하나설정
logit_l2선형피처의 가중합으로 로그오즈 L2 · C=0.1 · 최대 2,000회
logit_l1선형(희소)계수를 0 으로 눌러 피처를 고른다 L1 · C=0.05 · liblinear
knn거리적합하지 않는다 — 표를 기억하고 이웃에게 묻는다 k=25 · 1/거리 가중
et배깅트리분기 지점을 무작위로 뽑은 트리 400그루의 평균 깊이 6 · 잎 최소 20 · √p
rf배깅트리부트스트랩 표본마다 최적 분기를 찾은 트리 400그루 깊이 6 · 잎 최소 20 · √p
hgb부스팅앞 트리가 남긴 잔차를 다음 트리가 메운다 깊이 3 · 학습률 0.05 · 300회 · L2 1.0
ridge (P3)선형 회귀잔차 변화(bp)를 가중합으로 α=10
et·hgb (P3)회귀판위와 같되 출력이 bp 트리 300 · 잎 최소 50

기준선은 탐침마다 다르다. 공통은 적응 상수(후행 120표본의 다수 방향)이고, 여기에 그 표의 단순 규칙이 붙는다 — P1 은 «미국채 10년 금리 변화의 반대 부호», P2 는 오전 모멘텀과 응찰율 규칙, P4 는 기울기 모멘텀과 그 반대, P5 는 잔차 되돌림, P3 은 전일 잔차 변화의 반대다.

아래 구조도는 학습된 객체에서 그렸다(모식도가 아니다). 정직 선택이 마지막 시험연도에 고른 다섯 설정은 커밋된 예측을 그대로 다시 내는지 확인한 뒤에만 그렸다(P1 174행 · P2 68행 · P3 13,476행 · P4 179행 · P5 975행 전부 부호 일치). 격자에 있었지만 마지막 해에 뽑히지 않은 설정도 같은 폴드에서 그려 돌린 모델 일곱을 모두 싣는다.

선형 · 로지스틱 회귀(L2) — 탐침 P1 · 마지막 폴드(학습 960행) · 재현 확인

P1 · 선형 · 로지스틱 회귀(L2) 개요 입력 탐침 P1 학습창 960행 확장창 — 시험연도 이전만 피처 26개 (f_ 접두) 결측은 학습창 중앙값 선형 · 로지스틱 회귀(L2) 1. 결측 대치 학습창 중앙값으로 채운다(시험연도를 보지 않는다) 2. 표준화 학습창 평균·표준편차로 z 화 — 계수가 서로 비교 가능해진다 3. 선형 결합 z = b + Σ wᵢ·xᵢ (계수 26개) 4. 링크 σ(z) → 확률 출력 개장 갭 방향 (+1/−1) 계수 — 세팅과 학습 결과 피처 26개 표준화된 공간의 계수 — 서로 크기 비교가 된다 0 이 아닌 계수 26개 절편 b = -0.0261 모든 피처가 학습창 평균일 때의 출발점 기저율 쏠림이 여기에 담긴다 |w| 최대 = 0.6214 가장 센 피처: f_ustfut_10y_bp |w| 중앙값 0.2491 C = 0.1 역정규화 강도 작을수록 더 강한 규제
전처리 단계와 계수 요약. 절편과 0 이 아닌 계수 수를 함께 적는다.
P1 · 표준화 공간의 계수 ← 하락 쪽 상승 쪽 → f_ustfut_10y_bp -0.6214 f_ust_5y_all_bp -0.5917 f_ust_2y_all_bp -0.5808 f_ust_10y_all_bp -0.4676 f_ustfut_30y_bp -0.4284 f_ustfut_2y_bp -0.4045 f_ust_5y_ny_bp -0.4021 f_prev_sess_tick -0.3882 f_gap_days -0.3345 f_ust_5y_eve_bp -0.2903 f_ust_slope_all_bp +0.2742 f_ust_10y_dawn_bp -0.2598 f_ust_2y_eve_bp -0.2491 f_nasdaq_pct +0.2391 f_gap_ma5 -0.2286 f_ust_10y_eve_bp -0.2071 표준화된 공간의 계수 상위 16개 · 절편 b = -0.0261 · 전체 26개 중
표준화된 공간이라 계수 크기를 서로 견줄 수 있다.

부스팅 · 히스토그램 그래디언트 부스팅 — 탐침 P2 · 마지막 폴드(학습 576행) · 재현 확인

P2 · 부스팅 · 히스토그램 그래디언트 부스팅 개요 입력 탐침 P2 학습창 576행 확장창 — 시험연도 이전만 피처 20개 (f_ 접두) 결측은 학습창 중앙값 부스팅 · 히스토그램 그래디언트 부스팅 f₁ f₂ f₃ f₄ f₅ ··· f₃₀₀ 위는 이 모델 트리 5그루와 마지막 그루의 실제 위상(점 = 잎) — 실물은 그림 B·C ŷ(x) 출력 오후 방향 (+1/−1) 하이퍼파라미터 — 세팅한 상한과 학습이 실제로 닿은 값 n_estimators = 300 이어 붙이는 트리 개수 — 위 f₁ … 가 이만큼 실제 300그루 max_depth = 3 뿌리(깊이 0)에서 잎까지 분기 최대 3번 — 그림 B·C 의 오른쪽 눈금 실제 깊이 전부 3 · 상한에 닿은 트리 300/300 min_samples_leaf = 20 잎 하나에 표본 20개 미만이면 그 분할을 하지 않는다 실제 가장 작은 잎 n=20 max_features = 1.0 분할마다 후보 피처를 일부만 뽑는다 트리끼리 서로 다른 곳을 보게 만든다 learning_rate = 0.05 트리 하나가 더하는 값 = 적합값 × 0.05 (아래 잎값에 이미 곱해져 있다) 작을수록 트리 한 그루의 발언권이 작다 그루별 잎 수 분포 4 6 8 10 12 14 16 18 20 22 24 26 28 30 31 잎 4~8개 · 상한 31
세팅(상한)과 실현값(실제로 닿은 깊이·잎 수)을 나란히 둔다.
P2 · 첫 트리 깊이 0 · 뿌리 분기 조건 · n 깊이 1 분기 조건 · n 깊이 2 분기 조건 · n 깊이 3 · 잎 분기 없음 max_depth = 3 뿌리→잎 분기 3번까지 이 트리 실제 깊이 3 아니오 아니오 아니오 아니오 아니오 f_cover_max ≤ 331.9 n=530 f_cover_min ≤ 317.5 n=443 f_size_jo ≤ 107.5 n=411 잎값 +0.0115 n=165 잎값 -0.0126 n=246 잎값 -0.0477 n=32 f_tail_bp_max ≤ 4.5 n=87 f_cover_min ≤ 334.4 n=50 잎값 +0.0430 n=23 잎값 -0.0203 n=27 잎값 +0.0585 n=37 잎값 ≥ 0 (예측을 위로) 잎값 < 0 (예측을 아래로) n = 그 노드에 떨어진 학습 표본 수 · 조건(≤)이 참이면 왼쪽 가지 '예', 거짓(>)이면 오른쪽 '아니오'
분기 조건·표본 수·잎값 그대로. 그림이 넓으면 잎을 가지치기해 그린다.
P2 · 마지막 트리 깊이 0 · 뿌리 분기 조건 · n 깊이 1 분기 조건 · n 깊이 2 분기 조건 · n 깊이 3 · 잎 분기 없음 max_depth = 3 뿌리→잎 분기 3번까지 이 트리 실제 깊이 3 아니오 아니오 아니오 아니오 아니오 아니오 f_partial_w ≤ 60.16 n=530 f_tail_bp_max ≤ 2 n=256 잎값 -0.0234 n=22 f_partial_w ≤ 54.2 n=234 잎값 +0.0022 n=206 잎값 +0.0291 n=28 f_partial_w ≤ 79.3 n=274 f_tail_bp_w ≤ 4.383 n=73 잎값 +0.0025 n=42 잎값 -0.0417 n=31 f_partial_w ≤ 86.3 n=201 잎값 +0.0282 n=28 잎값 -0.0020 n=173 잎값 ≥ 0 (예측을 위로) 잎값 < 0 (예측을 아래로) n = 그 노드에 떨어진 학습 표본 수 · 조건(≤)이 참이면 왼쪽 가지 '예', 거짓(>)이면 오른쪽 '아니오'
마지막 트리 — 앞 트리와 같은 규칙으로 그렸다.
P2 · 깊이 × 피처 분기표
분기 위치 \ 피처f_band_bp_wf_size_vs_outf_surprise_bp_wf_morning_tickf_cover_wf_partial_wf_size_jof_cover_minf_alloc_ratiof_cover_maxf_tail_bp_wf_tail_bp_maxf_has_10yf_dowf_has_3yf_n_auctionf_has_5yf_has_20yf_has_30yf_has_50y
깊이 0 (뿌리)22523924186121225361914210000000300
깊이 1106535638393445413925202707010000531
깊이 291798079746748483738342232300000705
분기 합2191841751411311071051011019973632493100001,536
손실 감소(gain) 몫15.0%10.8%10.5%7.7%9.1%8.3%6.6%7.3%5.8%8.1%4.0%5.2%0.8%0.6%0.3%0.0%0.0%0.0%0.0%0.0%100%

어느 깊이에서 어느 피처가 얼마나 쓰였는지.

부스팅 · 히스토그램 그래디언트 부스팅 — 탐침 P3 · 마지막 폴드(학습 119,107행) · 재현 확인

P3 · 부스팅 · 히스토그램 그래디언트 부스팅 개요 입력 탐침 P3 학습창 119,107행 확장창 — 시험연도 이전만 피처 12개 (f_ 접두) 결측은 학습창 중앙값 부스팅 · 히스토그램 그래디언트 부스팅 f₁ f₂ f₃ f₄ f₅ ··· f₂₈₀ 위는 이 모델 트리 5그루와 마지막 그루의 실제 위상(점 = 잎) — 실물은 그림 B·C ŷ(x) 출력 익일 잔차 변화 (bp) 하이퍼파라미터 — 세팅한 상한과 학습이 실제로 닿은 값 n_estimators = 280 이어 붙이는 트리 개수 — 위 f₁ … 가 이만큼 실제 280그루 max_depth = 3 뿌리(깊이 0)에서 잎까지 분기 최대 3번 — 그림 B·C 의 오른쪽 눈금 실제 깊이 전부 3 · 상한에 닿은 트리 280/280 min_samples_leaf = 50 잎 하나에 표본 50개 미만이면 그 분할을 하지 않는다 실제 가장 작은 잎 n=50 max_features = 1.0 분할마다 후보 피처를 일부만 뽑는다 트리끼리 서로 다른 곳을 보게 만든다 learning_rate = 0.05 트리 하나가 더하는 값 = 적합값 × 0.05 (아래 잎값에 이미 곱해져 있다) 작을수록 트리 한 그루의 발언권이 작다 그루별 잎 수 분포 7 9 11 13 15 17 19 21 23 25 27 29 31 잎 7~8개 · 상한 31
세팅(상한)과 실현값(실제로 닿은 깊이·잎 수)을 나란히 둔다.
P3 · 첫 트리 깊이 0 · 뿌리 분기 조건 · n 깊이 1 분기 조건 · n 깊이 2 분기 조건 · n 깊이 3 · 잎 분기 없음 max_depth = 3 뿌리→잎 분기 3번까지 이 트리 실제 깊이 3 아니오 아니오 아니오 아니오 아니오 아니오 아니오 f_rich_chg5 ≤ -5.31 n=107,196 f_rich_bp ≤ -0.1222 n=5,853 f_rich_chg1 ≤ -0.6544 n=2,463 잎값 -0.0277 n=1,595 잎값 +0.0219 n=868 f_rich_bp ≤ 28.87 n=3,390 잎값 +0.0425 n=2,886 잎값 -0.0233 n=504 f_rich_bp ≤ 13.47 n=101,343 f_rich_chg5 ≤ -2.848 n=52,444 잎값 +0.0113 n=4,607 잎값 +0.0012 n=47,837 f_rich_chg1 ≤ 3.675 n=48,899 잎값 -0.0031 n=47,835 잎값 -0.0422 n=1,064 잎값 ≥ 0 (예측을 위로) 잎값 < 0 (예측을 아래로) n = 그 노드에 떨어진 학습 표본 수 · 조건(≤)이 참이면 왼쪽 가지 '예', 거짓(>)이면 오른쪽 '아니오'
분기 조건·표본 수·잎값 그대로. 그림이 넓으면 잎을 가지치기해 그린다.
P3 · 마지막 트리 깊이 0 · 뿌리 분기 조건 · n 깊이 1 분기 조건 · n 깊이 2 분기 조건 · n 깊이 3 · 잎 분기 없음 max_depth = 3 뿌리→잎 분기 3번까지 이 트리 실제 깊이 3 아니오 아니오 아니오 아니오 아니오 아니오 아니오 f_rich_bp ≤ 17.11 n=107,196 f_rich_chg1 ≤ 0.1017 n=67,681 f_rich_chg5 ≤ 7.881 n=38,439 잎값 -0.0007 n=38,105 잎값 +0.0253 n=334 f_rich_chg5 ≤ -5.772 n=29,242 잎값 +0.0189 n=876 잎값 +0.0007 n=28,366 f_rich_chg1 ≤ -4.979 n=39,515 f_lend ≤ 0.0003819 n=260 잎값 +0.0763 n=55 잎값 +0.0082 n=205 f_rich_chg5 ≤ -3.376 n=39,255 잎값 -0.0077 n=3,032 잎값 -0.000009 n=36,223 잎값 ≥ 0 (예측을 위로) 잎값 < 0 (예측을 아래로) n = 그 노드에 떨어진 학습 표본 수 · 조건(≤)이 참이면 왼쪽 가지 '예', 거짓(>)이면 오른쪽 '아니오'
마지막 트리 — 앞 트리와 같은 규칙으로 그렸다.
P3 · 깊이 × 피처 분기표
분기 위치 \ 피처f_rich_chg1f_rich_chg5f_rich_bpf_durf_out_logf_fo_chg5f_fo_chg20f_lend_chg5f_fof_lendf_out_chg5f_lend_chg1
깊이 0 (뿌리)5135754513617908174280
깊이 11351541255818346119901560
깊이 2265258242153521328282212171,081
분기 합45144744225683535148312918121,921
손실 감소(gain) 몫26.9%22.0%33.7%9.8%2.5%0.9%0.9%1.7%0.8%0.5%0.1%0.2%100%

어느 깊이에서 어느 피처가 얼마나 쓰였는지.

거리 · k-최근접이웃 — 탐침 P4 · 마지막 폴드(학습 1,822행) · 재현 확인

P4 · k-최근접이웃 개요 입력 탐침 P4 학습창 1,822행 확장창 — 시험연도 이전만 피처 19개 (f_ 접두) 결측은 학습창 중앙값 거리 · k-최근접이웃 1. 결측 대치 학습창 중앙값으로 채운다 2. 표준화 학습창 평균 0 · 표준편차 1 — 거리 계산에 필수다 3. 이웃 찾기 가장 가까운 25개 4. 가중 투표 1/거리 로 가중한 상승 비율 출력 기울기 변화 방향 (+1/−1) 세팅과 학습 결과 n_neighbors = 25 몇 명에게 물을지 — 세팅 실현: 학습표 1,696행에서 고른다 weights = distance 가까운 이웃에 더 큰 표를 준다 가중치 = 1 / 거리 metric = minkowski 표준화된 19차원에서의 거리 k번째 이웃 거리 중앙값 2.720 학습 파라미터 없음 이 계열은 적합하지 않는다 — 표를 기억한다 예측할 때마다 전체 표와 거리를 잰다 ŷ(x)
세팅과 전처리 단계. 이 계열은 적합하지 않고 표를 기억한다.
P4 · 시험 표본 하나의 이웃 25개 시험일 2026-01-01 하나의 이웃 25개 — 학습표 1,696행 중에서 고른다 왼쪽 막대 = 거리(가까울수록 짧다) · 오른쪽 막대 = 투표 가중치 1/거리 · 색이 옅으면 그 이웃의 정답은 하락 거리 → ← 가중치 2.270 0.440 상승 상승 상승 상승 하락 하락 하락 상승 하락 하락 상승 하락 상승 상승 상승 하락 하락 하락 상승 상승 상승 상승 상승 상승 2.855 0.350 하락 P(상승) = Σ(가중치 × 이웃의 상승) / Σ가중치 = 0.2008 k = 25 · 가중 distance · 거리 minkowski · 피처 19개 시험 구간 전체에서 k번째 이웃까지의 거리 — 하위10% 2.225 · 중앙 2.720 · 상위10% 4.520
가까운 순서 · 그 이웃의 정답 · 1/거리 가중치.

배깅트리 · RandomForest — 탐침 P5 · 마지막 폴드(학습 5,427행) · 재현 확인

P5 · 배깅트리 · RandomForest 개요 입력 탐침 P5 학습창 5,427행 확장창 — 시험연도 이전만 피처 11개 (f_ 접두) 결측은 학습창 중앙값 배깅트리 · RandomForest f₁ f₂ f₃ f₄ f₅ ··· f₄₀₀ 위는 이 모델 트리 5그루와 마지막 그루의 실제 위상(점 = 잎) — 실물은 그림 B·C ŷ(x) 출력 익일 잔차 방향 (+1/−1) 하이퍼파라미터 — 세팅한 상한과 학습이 실제로 닿은 값 n_estimators = 400 이어 붙이는 트리 개수 — 위 f₁ … 가 이만큼 실제 400그루 max_depth = 6 뿌리(깊이 0)에서 잎까지 분기 최대 6번 — 그림 B·C 의 오른쪽 눈금 실제 깊이 전부 6 · 상한에 닿은 트리 400/400 min_samples_leaf = 20 잎 하나에 표본 20개 미만이면 그 분할을 하지 않는다 실제 가장 작은 잎 n=20 max_features = sqrt 분할마다 피처 11개 중 3개만 후보로 뽑는다 트리끼리 서로 다른 곳을 보게 만든다 그루별 잎 수 분포 25 27 29 31 33 35 37 39 41 43 45 47 49 51 잎 25~51개
세팅(상한)과 실현값(실제로 닿은 깊이·잎 수)을 나란히 둔다.
P5 · 첫 트리 깊이 0 · 뿌리 분기 조건 · n 깊이 1 분기 조건 · n 깊이 2 분기 조건 · n 깊이 3 분기 조건 · n 깊이 4 · 접힘 아래를 접었다 max_depth = 6 뿌리→잎 분기 6번까지 이 트리 실제 깊이 6 아니오 아니오 아니오 아니오 아니오 아니오 아니오 아니오 아니오 아니오 아니오 아니오 아니오 아니오 f_tenor ≤ 6.5 n=3,377 f_resid_ma5 ≤ -0.4059 n=1,276 f_spread_mp_bp ≤ -0.95 n=655 f_fut_bp ≤ 1.678 n=46 잎값 +0.4762 n=26 잎값 +0.3824 n=20 f_stale_sec ≤ 679.5 n=609 하위 3잎 n=549 하위 2잎 n=60 f_fut_bp ≤ -1.947 n=621 잎값 +0.5424 n=39 f_cash_bp ≤ 0.55 n=582 하위 4잎 n=463 하위 3잎 n=119 f_tenor ≤ 20 n=2,101 f_resid_bp ≤ 1.515 n=1,481 f_resid_lag1 ≤ 1.885 n=1,382 하위 4잎 n=1,338 하위 2잎 n=44 f_spread_mp_bp ≤ -0.85 n=99 하위 3잎 n=78 잎값 +0.3333 n=21 f_resid_bp ≤ -0.07964 n=620 f_resid_lag1 ≤ 1.35 n=293 하위 3잎 n=266 잎값 +0.7381 n=27 f_resid_lag1 ≤ 0.3183 n=327 하위 3잎 n=195 하위 3잎 n=132 잎값 ≥ 0 (예측을 위로) 잎값 < 0 (예측을 아래로) n = 그 노드에 떨어진 학습 표본 수 · 조건(≤)이 참이면 왼쪽 가지 '예', 거짓(>)이면 오른쪽 '아니오' · 잎이 많아 깊이 4 아래를 접었다(이 트리 전체 깊이 6 · 잎 35개)
분기 조건·표본 수·잎값 그대로. 그림이 넓으면 잎을 가지치기해 그린다.
P5 · 마지막 트리 깊이 0 · 뿌리 분기 조건 · n 깊이 1 분기 조건 · n 깊이 2 분기 조건 · n 깊이 3 분기 조건 · n 깊이 4 · 접힘 아래를 접었다 max_depth = 6 뿌리→잎 분기 6번까지 이 트리 실제 깊이 6 아니오 아니오 아니오 아니오 아니오 아니오 아니오 아니오 아니오 아니오 아니오 아니오 아니오 아니오 f_resid_bp ≤ 0.399 n=3,340 f_tick_bp ≤ 0.1039 n=2,706 f_stale_sec ≤ 15.5 n=699 f_tick_bp ≤ 0.1036 n=411 하위 4잎 n=391 잎값 +0.6667 n=20 f_resid_bp ≤ -0.2773 n=288 하위 3잎 n=180 하위 3잎 n=108 f_tenor ≤ 6.5 n=2,007 f_tick_bp ≤ 0.3349 n=1,122 하위 3잎 n=842 하위 4잎 n=280 f_resid_lag1 ≤ 2.681 n=885 하위 4잎 n=865 잎값 +0.9118 n=20 f_tick_bp ≤ 0.04147 n=634 f_spread_mp_bp ≤ -0.25 n=174 f_tick_bp ≤ 0.03978 n=146 하위 4잎 n=125 잎값 +0.9677 n=21 잎값 +0.5000 n=28 f_resid_ma5 ≤ 0.0601 n=460 f_spread_mp_bp ≤ -0.95 n=361 하위 4잎 n=143 하위 3잎 n=218 f_tenor ≤ 20 n=99 하위 3잎 n=75 잎값 +0.3636 n=24 잎값 ≥ 0 (예측을 위로) 잎값 < 0 (예측을 아래로) n = 그 노드에 떨어진 학습 표본 수 · 조건(≤)이 참이면 왼쪽 가지 '예', 거짓(>)이면 오른쪽 '아니오' · 잎이 많아 깊이 4 아래를 접었다(이 트리 전체 깊이 6 · 잎 40개)
마지막 트리 — 앞 트리와 같은 규칙으로 그렸다.
P5 · 깊이 × 피처 분기표
분기 위치 \ 피처f_tick_bpf_resid_ma5f_resid_lag1f_resid_bpf_stale_secf_fut_bpf_resid_sd20f_spread_mp_bpf_cash_bpf_dowf_tenor
깊이 0 (뿌리)1045636665732012091400
깊이 11391109711727403158656110800
깊이 222119317519415115693107126521141,582
깊이 3362327339325286290266208241130792,853
깊이 4527548504456458423422351297195564,237
깊이 5715645649626517474527454390285555,337
분기 합2,0681,8791,8001,7841,4441,3901,3421,1981,13166850515,209

어느 깊이에서 어느 피처가 얼마나 쓰였는지.

선형 · 로지스틱 회귀(L1, 희소) — 탐침 P1 · 마지막 폴드(학습 960행) · 격자 예시

P1 · 선형 · 로지스틱 회귀(L1, 희소) 개요 입력 탐침 P1 학습창 960행 확장창 — 시험연도 이전만 피처 26개 (f_ 접두) 결측은 학습창 중앙값 선형 · 로지스틱 회귀(L1, 희소) 1. 결측 대치 학습창 중앙값으로 채운다(시험연도를 보지 않는다) 2. 표준화 학습창 평균·표준편차로 z 화 — 계수가 서로 비교 가능해진다 3. 선형 결합 z = b + Σ wᵢ·xᵢ (계수 26개) 4. 링크 σ(z) → 확률 출력 개장 갭 방향 (+1/−1) 계수 — 세팅과 학습 결과 피처 26개 표준화된 공간의 계수 — 서로 크기 비교가 된다 0 이 아닌 계수 5개 절편 b = +0.0000 모든 피처가 학습창 평균일 때의 출발점 기저율 쏠림이 여기에 담긴다 |w| 최대 = 1.0473 가장 센 피처: f_ustfut_10y_bp |w| 중앙값 0.0000 C = 0.05 역정규화 강도 작을수록 더 강한 규제
전처리 단계와 계수 요약. 절편과 0 이 아닌 계수 수를 함께 적는다.
P1 · 표준화 공간의 계수 ← 하락 쪽 상승 쪽 → f_ustfut_10y_bp -1.0473 f_ust_5y_all_bp -0.9781 f_ust_2y_all_bp -0.9708 f_gap_days -0.0830 f_prev_sess_tick -0.0815 f_prev_range_tick +0.0000 f_prev_gap_tick +0.0000 f_gap_ma5 +0.0000 f_gap_sd20 +0.0000 f_dow +0.0000 f_ust_2y_eve_bp +0.0000 f_ust_5y_eve_bp +0.0000 f_ust_10y_eve_bp +0.0000 f_ust_2y_ny_bp +0.0000 f_ust_5y_ny_bp +0.0000 f_ust_10y_ny_bp +0.0000 표준화된 공간의 계수 상위 16개 · 절편 b = +0.0000 · 전체 26개 중
표준화된 공간이라 계수 크기를 서로 견줄 수 있다.

배깅트리 · ExtraTrees(무작위 분기) — 탐침 P1 · 마지막 폴드(학습 960행) · 격자 예시

P1 · 배깅트리 · ExtraTrees(무작위 분기) 개요 입력 탐침 P1 학습창 960행 확장창 — 시험연도 이전만 피처 26개 (f_ 접두) 결측은 학습창 중앙값 배깅트리 · ExtraTrees(무작위 분기) f₁ f₂ f₃ f₄ f₅ ··· f₄₀₀ 위는 이 모델 트리 5그루와 마지막 그루의 실제 위상(점 = 잎) — 실물은 그림 B·C ŷ(x) 출력 개장 갭 방향 (+1/−1) 하이퍼파라미터 — 세팅한 상한과 학습이 실제로 닿은 값 n_estimators = 400 이어 붙이는 트리 개수 — 위 f₁ … 가 이만큼 실제 400그루 max_depth = 6 뿌리(깊이 0)에서 잎까지 분기 최대 6번 — 그림 B·C 의 오른쪽 눈금 실제 깊이 0~6 · 상한에 닿은 트리 329/400 min_samples_leaf = 20 잎 하나에 표본 20개 미만이면 그 분할을 하지 않는다 실제 가장 작은 잎 n=20 max_features = sqrt 분할마다 피처 26개 중 5개만 후보로 뽑는다 트리끼리 서로 다른 곳을 보게 만든다 그루별 잎 수 분포 1 3 5 7 9 11 13 15 17 19 21 23 잎 1~23개
세팅(상한)과 실현값(실제로 닿은 깊이·잎 수)을 나란히 둔다.
P1 · 첫 트리 깊이 0 · 뿌리 분기 조건 · n 깊이 1 분기 조건 · n 깊이 2 분기 조건 · n 깊이 3 분기 조건 · n 깊이 4 분기 조건 · n 깊이 5 분기 조건 · n 깊이 6 · 잎 분기 없음 max_depth = 6 뿌리→잎 분기 6번까지 이 트리 실제 깊이 6 아니오 아니오 아니오 아니오 아니오 아니오 아니오 아니오 아니오 f_ust_5y_eve_bp ≤ 7.55 n=896 f_ust_2y_ny_bp ≤ -0.3328 n=828 f_ust_5y_ny_bp ≤ -3.442 n=281 f_prev_gap_tick ≤ 0.8306 n=77 잎값 +0.8974 n=39 잎값 +1.0000 n=38 f_gap_ma5 ≤ 1.958 n=204 f_ust_2y_all_bp ≤ -1.003 n=157 f_ust_10y_all_bp ≤ -2.337 n=98 잎값 +0.9655 n=58 잎값 +0.8250 n=40 잎값 +0.3390 n=59 잎값 +0.7872 n=47 f_ust_10y_eve_bp ≤ -9.374 n=547 잎값 +1.0000 n=20 잎값 +0.3624 n=527 f_gap_days ≤ 2.021 n=68 잎값 +0.0213 n=47 잎값 +0.0952 n=21 잎값 ≥ 0 (예측을 위로) 잎값 < 0 (예측을 아래로) n = 그 노드에 떨어진 학습 표본 수 · 조건(≤)이 참이면 왼쪽 가지 '예', 거짓(>)이면 오른쪽 '아니오'
분기 조건·표본 수·잎값 그대로. 그림이 넓으면 잎을 가지치기해 그린다.
P1 · 마지막 트리 깊이 0 · 뿌리 분기 조건 · n 깊이 1 분기 조건 · n 깊이 2 분기 조건 · n 깊이 3 분기 조건 · n 깊이 4 분기 조건 · n 깊이 5 분기 조건 · n 깊이 6 · 잎 분기 없음 max_depth = 6 뿌리→잎 분기 6번까지 이 트리 실제 깊이 6 아니오 아니오 아니오 아니오 아니오 아니오 아니오 아니오 아니오 아니오 아니오 아니오 아니오 아니오 f_ustfut_2y_bp ≤ -6.735 n=896 잎값 +0.9649 n=114 f_ust_5y_ny_bp ≤ 0.636 n=782 f_ust_10y_rng_bp ≤ 13 n=514 f_ust_10y_ny_bp ≤ -1.401 n=475 f_ustfut_2y_bp ≤ 0.2162 n=138 f_dow ≤ 1.367 n=86 잎값 +0.9048 n=21 잎값 +0.9077 n=65 잎값 +0.3846 n=52 f_ust_5y_ny_bp ≤ -0.6859 n=337 잎값 +0.6250 n=56 f_ust_5y_all_bp ≤ 3.027 n=281 잎값 +0.5417 n=192 잎값 +0.0562 n=89 잎값 +0.3077 n=39 f_ust_2y_ny_bp ≤ 1.605 n=268 잎값 +0.3171 n=82 f_ust_10y_rng_bp ≤ 9.833 n=186 f_ust_2y_eve_bp ≤ 2.185 n=111 f_dow ≤ 2.912 n=84 잎값 +0.3824 n=34 잎값 +0.2800 n=50 잎값 +0.0370 n=27 f_prev_range_tick ≤ 27.67 n=75 f_ust_5y_eve_bp ≤ 1.504 n=50 잎값 +0.3704 n=27 잎값 +0.0000 n=23 잎값 +0.2000 n=25 잎값 ≥ 0 (예측을 위로) 잎값 < 0 (예측을 아래로) n = 그 노드에 떨어진 학습 표본 수 · 조건(≤)이 참이면 왼쪽 가지 '예', 거짓(>)이면 오른쪽 '아니오'
마지막 트리 — 앞 트리와 같은 규칙으로 그렸다.
P1 · 깊이 × 피처 분기표
분기 위치 \ 피처f_dowf_ustfut_10y_bpf_ust_5y_all_bpf_ust_10y_all_bpf_ust_2y_all_bpf_ustfut_30y_bpf_ust_10y_eve_bpf_ust_5y_eve_bpf_ustfut_2y_bpf_ust_2y_eve_bpf_ust_5y_ny_bpf_ust_10y_ny_bpf_gap_daysf_ust_2y_ny_bpf_ust_slope_all_bpf_ust_10y_rng_bpf_gap_sd20f_ust_10y_dawn_bpf_ust_10y_vol_bpf_prev_sess_tickf_prev_range_tickf_gap_ma5f_ust_2y_dawn_bpf_prev_gap_tickf_ust_5y_dawn_bpf_nasdaq_pct
깊이 0 (뿌리)203427262235241423141122719124810545810337377
깊이 14147314645292833233028342019122514119181289977595
깊이 255604854504139442945254029272117252035131591791514796
깊이 37674656548494940493731222727272521232321251621262012919
깊이 47256726057474347433939242623272222342028202921211513920
깊이 58552665642394233272229213222232425171915162315242013802
분기 합349323309307264240225211194187163163141137122117115115111999393939280664,409

어느 깊이에서 어느 피처가 얼마나 쓰였는지.

선형 · 릿지 회귀 — 탐침 P3 · 마지막 폴드(학습 119,107행) · 격자 예시

P3 · 선형 · 릿지 회귀 개요 입력 탐침 P3 학습창 119,107행 확장창 — 시험연도 이전만 피처 12개 (f_ 접두) 결측은 학습창 중앙값 선형 · 릿지 회귀 1. 결측 대치 학습창 중앙값으로 채운다(시험연도를 보지 않는다) 2. 표준화 학습창 평균·표준편차로 z 화 — 계수가 서로 비교 가능해진다 3. 선형 결합 z = b + Σ wᵢ·xᵢ (계수 12개) 4. 링크 z → 예상 틱, 부호가 방향 출력 익일 잔차 변화 (bp) 계수 — 세팅과 학습 결과 피처 12개 표준화된 공간의 계수 — 서로 크기 비교가 된다 0 이 아닌 계수 12개 절편 b = -0.0122 모든 피처가 학습창 평균일 때의 출발점 평균적인 ref_tick 변화 |w| 최대 = 0.0648 가장 센 피처: f_rich_chg5 |w| 중앙값 0.0052 alpha = 10.0 릿지 벌점 클수록 계수를 더 눌러 붙인다
전처리 단계와 계수 요약. 절편과 0 이 아닌 계수 수를 함께 적는다.
P3 · 표준화 공간의 계수 ← 하락 쪽 상승 쪽 → f_rich_chg5 -0.0648 f_out_log +0.0208 f_fo -0.0130 f_lend_chg5 +0.0116 f_fo_chg20 +0.0097 f_fo_chg5 -0.0052 f_lend_chg1 -0.0051 f_dur +0.0042 f_rich_bp -0.0039 f_rich_chg1 -0.0039 f_out_chg5 +0.0003 f_lend -0.0001 표준화된 공간의 계수 상위 12개 · 절편 b = -0.0122 · 전체 12개 중
표준화된 공간이라 계수 크기를 서로 견줄 수 있다.

결과

정본 런 results/20260922_164331_probes/. 성능은 모두 정직 선택 값이다(사후 최고가 아니다).
탐침시험 표본성능 기준선짝지은 검정판정
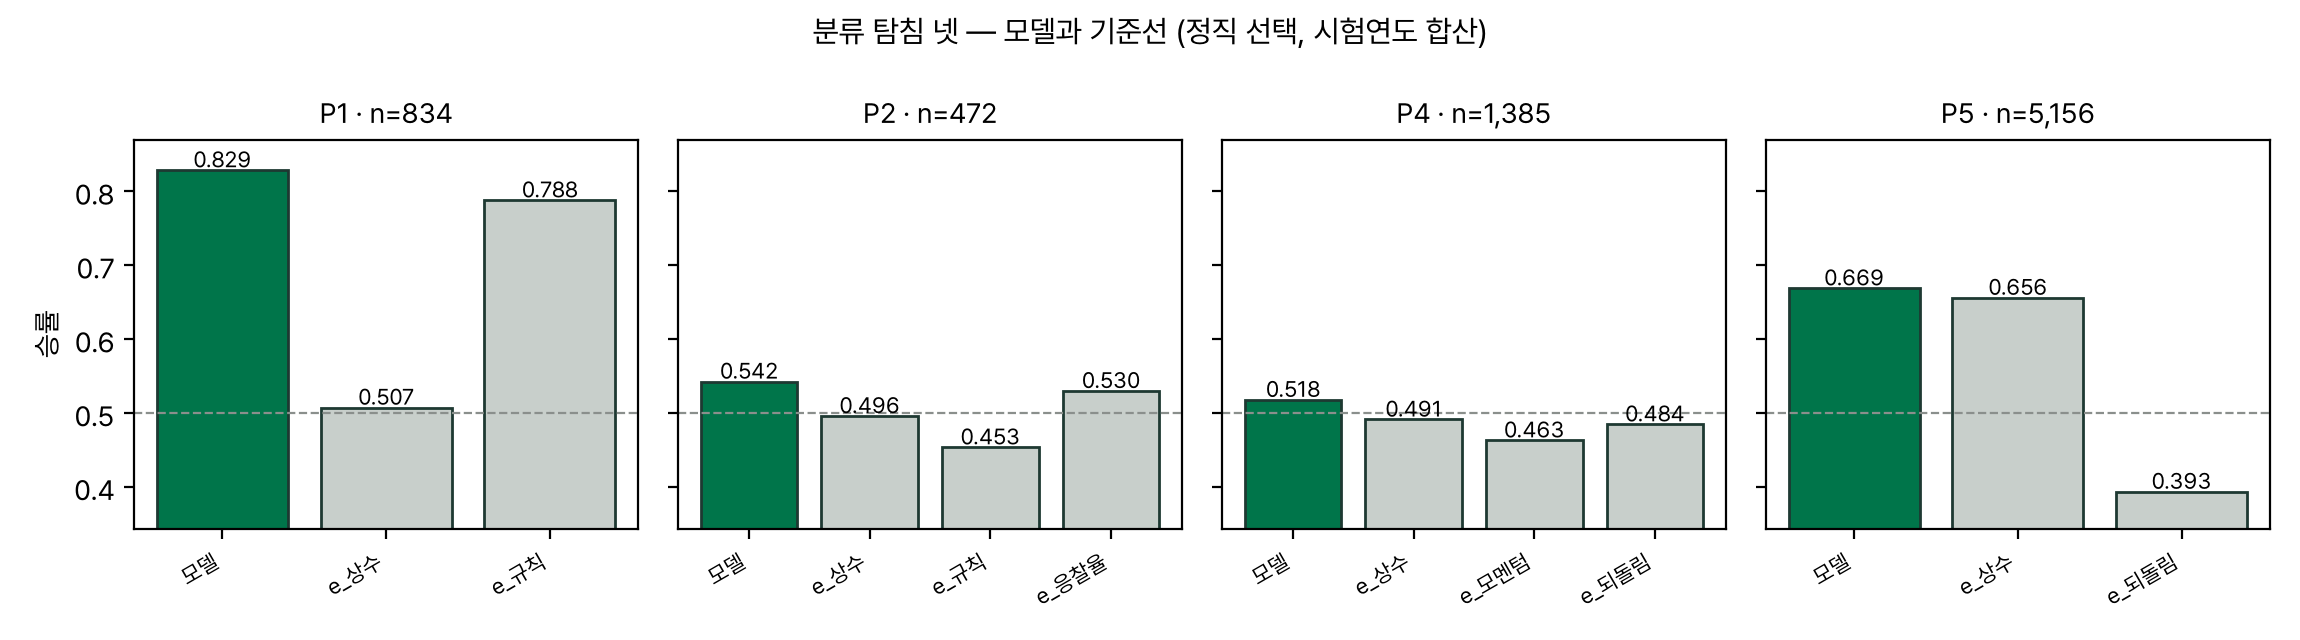
P1 야간 해외금리 → 개장 갭834일 승률 0.8285규칙 0.7878 · 적응상수 0.5072 규칙 대비 b=69:c=35 · p=0.0011채택
P2 입찰 결과 → 오후 방향472일 승률 0.5424응찰율 0.5297 · 적응상수 0.4958 · 오전모멘텀 0.4534 응찰율 대비 p=0.7264 · 상수 대비 p=0.1678미지지
P3 대차·외국인 → 종목 상대가치 103,894 종목-일
(1,401일)
IC +0.0251
(NW t=2.37)
되돌림 −0.0140 · 무작위 0Wilcoxon p=0.0385 (짝 1,327일) 채택
P4 단기자금 → 커브 기울기1,385일 승률 0.5177적응상수 0.4910 · 되돌림 0.4845 · 모멘텀 0.4628 상수 대비 p=0.1312미지지
P5 마감 현선갭 → 익일 잔차5,156 종목-일 승률 0.6687적응상수 0.6559 · 되돌림 0.3933 상수 대비 b=325:c=259 · p=0.0071채택
탐침별 모델과 기준선 승률
분류 탐침 넷. 진한 막대가 모델, 옅은 막대가 기준선이다. P1 은 기준선 자체가 0.788 로 높고 그 위를 넘었다. P5 는 수준(0.669)이 높아 보이지만 적응 상수가 이미 0.656 이다 — 이 탐침이 번 것은 그 위의 1.3%p 다.
연도별 승률
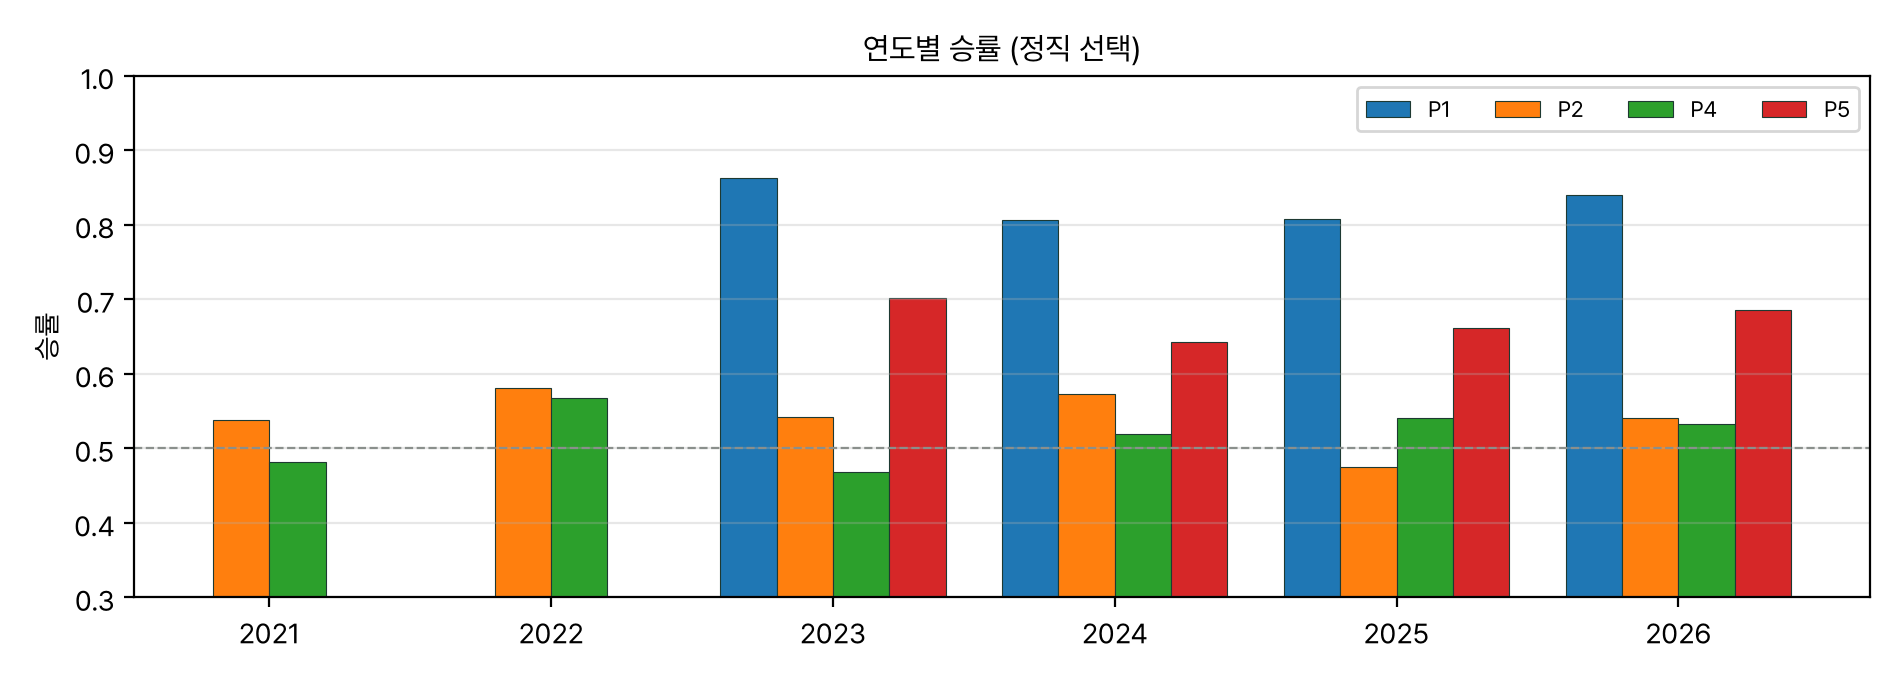
연도별 승률. P1 은 네 해 모두 0.80 이상이고, P2·P4 는 해마다 0.47~0.58 사이를 오간다 — 합산 승률이 가리는 자리다.
설정별 합산 승률(P3 은 일별 IC). 시험연도 전체를 합쳐 사후로 본 값이라 성능이 아니라 참고다 — 판정에 쓴 값은 위 표의 정직 선택이다.
탐침logit_l2logit_l1 knnetrf hgbridge
P10.83570.82490.8249 0.82490.82970.8165
P20.51270.48090.4958 0.48090.49790.5508
P3 (IC) 0.02940.04580.0093
P40.50830.50690.5285 0.52350.51480.4939
P50.66350.66740.6503 0.66780.67360.6505

탐침별로 읽기

P1 — 개장 갭의 대부분은 밤에 정해진다

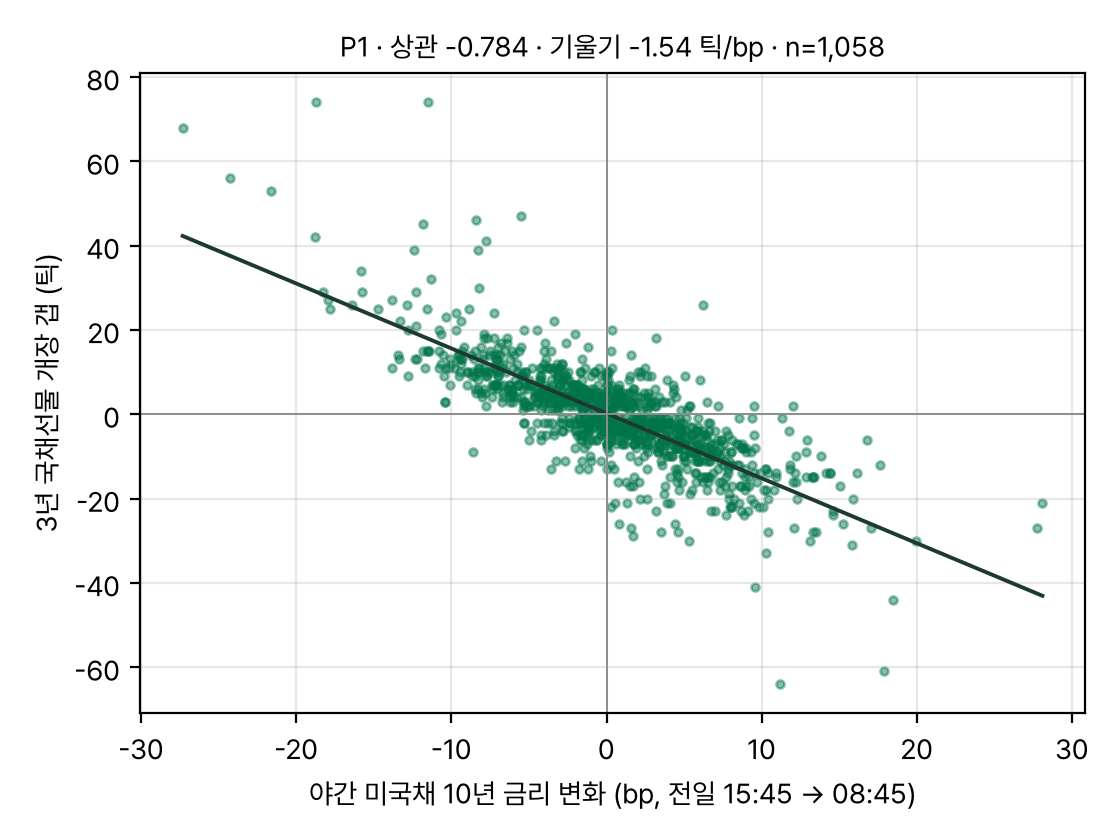
야간 미국채 10년 금리 변화와 개장 갭의 상관이 −0.784다. 한 변수 규칙만으로 78.78% 가 맞고, 모델은 거기서 +4.07%p를 더한다. 네 해 모두 0.806~0.863 이고 무너지는 해가 없다. 설정별로는 선형이 위다(logit_l2 0.8357 > hgb 0.8165) — 금리에서 갭으로 가는 사상이 거의 선형이라 트리가 쪼갤 구조가 적다.

사보타주로 확인했다. 야간 피처를 하루 뒤로 밀면 같은 절차의 승률이 0.8357 → 0.5540 으로 무너지고, 피처 행을 무작위로 뒤섞으면 0.4976 이 된다. 이 승률은 «그날 밤의 정보가 그날 아침에 붙어 있다» 에서 나오며 날짜가 어긋나면 사라진다.

야간 미국채 금리 변화와 개장 갭
점 하나가 하루다. 기울기는 야간 금리 1bp 당 갭 몇 틱인지를 말한다. 규칙은 이 그림의 부호만 쓰고, 모델이 더 버는 4%p 는 기울기가 레짐마다 다르다는 사실과 만기 구간별 차이에서 온다.

P3 — 이 저장소가 처음 연 횡단면 축

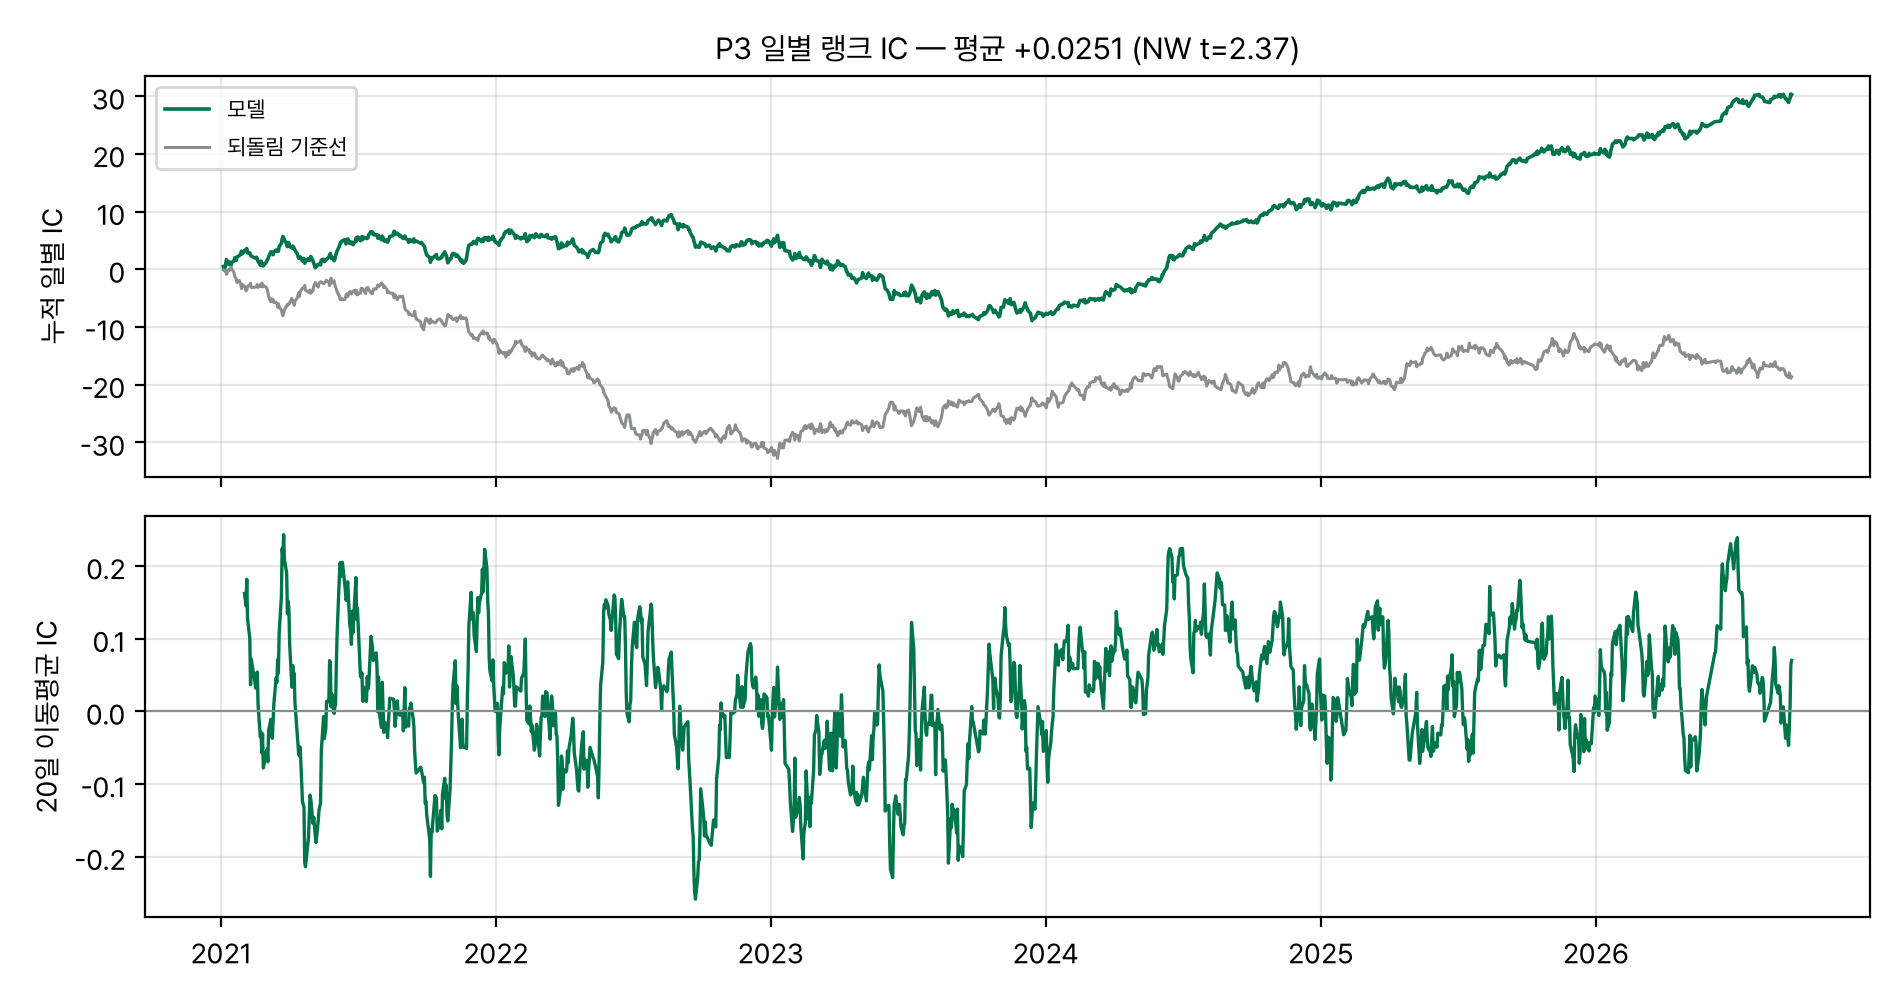
매일 듀레이션 2차 회귀로 커브를 긋고 그 잔차를 종목의 리치/치프로 정의했다. 타깃은 잔차의 익일 변화다. 일별 랭크 IC 평균 +0.0251(NW t=2.37), IC 가 양수인 날 54.26%. 되돌림 기준선은 −0.0140 으로 부호가 반대다 — 잔차는 하루 만에 되돌지 않는다. 상하위 십분위 롱숏은 +0.109bp/일 (NW t=1.75)로, 방향은 맞지만 크기가 작다.

P3 일별 랭크 IC
위: 누적 일별 IC — 모델은 우상향하고 되돌림 기준선은 내려간다. 아래: 20일 이동평균. 2023년 구간이 음수로 내려앉는다(그 해 IC −0.0505).

P5 — 잔차는 되돌지 않고 이어진다

가설은 «오늘 잔차가 내일 반대로 돌아온다» 였고 틀렸다. 되돌림 규칙의 승률이 0.3933 으로 무작위보다 한참 아래다 — 부호가 이어진다는 뜻이다. 다만 이 표의 기저율이 한쪽으로 쏠려 있어(익일 잔차 양수 33.66%) 적응 상수가 이미 0.6559 를 낸다. 모델이 번 것은 그 위의 +1.28%p(p=0.0071)다.

누설 카나리아가 셋 걸렸고 셋 다 누설이 아니다. f_stale_sec·f_tick_bp·f_tenor 가 각각 0.663 을 낸다. 이 카나리아는 «피처 부호만으로» 승률을 재는데, 거의 상수인 피처는 곧 «항상 다수 클래스» 예측이 되고 그 값이 기저율 0.663 이다. 카나리아 설계의 한계다 — 다음에는 기저율 대비 초과분으로 재야 한다.

P2·P4 — 표가 그 질문에는 답하지 않는다

P2 는 응찰율·부분낙찰율·응찰금리 밴드·테일·낙찰금리 서프라이즈·발행 규모를 다 넣어도 오후 방향에서 0.5424 이고 응찰율 규칙과 갈리지 않는다(p=0.7264). McNemar 가 갈린 표본이 204~232건뿐이라 «신호 없음» 과 «표본 부족» 을 이 실험이 가르지 못한다. P4 는 0.5177 로 적응 상수보다 높지만 p=0.1312 다. 다만 모멘텀 기준선(0.4628)은 유의하게 넘는다(p=0.0068) — 기울기는 하루 단위로 모멘텀이 아니라 되돌림에 가깝다는 사실이 남는다.

왜 그런가

세 가지가 갈렸다.

  • 정보가 이미 값에 박혀 있는 자리(P1)에서는 표가 바로 값을 한다. 한국 시장이 닫힌 사이 미국 금리가 움직이면 그 몫은 개장가에 실릴 수밖에 없다. 모델이 할 일은 «얼마나» 를 레짐에 맞게 조정하는 것뿐이고, 그것이 규칙 대비 4%p 다.
  • 횡단면(P3·P5)에서는 작은 신호가 많은 표본으로 유의해진다. 종목-일 표본이 10만 건이면 IC 0.025 도 t=2.37 이 된다. 반대로 그 크기가 작다는 사실도 같이 읽어야 한다 — 0.109bp/일은 비용을 견딜 수 있는 크기가 아닐 수 있다.
  • 일 단위 방향(P2·P4)은 표본이 수백 일이라 4~5%p 차이가 있어도 유의해지지 않는다. 사전등록 §6 에서 «P2 는 문턱이 빡빡하다» 고 미리 적어 둔 그대로다.

그리고 모델 계열의 순서가 탐침마다 다르다. P1 은 선형이 1위, P2·P3 은 부스팅, P4 는 거리(k-최근접이웃), P5 는 배깅트리다. 같은 격자를 다섯 문제에 걸었을 때 이기는 계열이 갈린다는 것은, 모델 축을 더 넓히는 것보다 문제를 바꾸는 쪽이 값이 크다는 앞선 관찰과 같은 말이다.

한계

P1 이 맞히는 값은 체결 가능한 값이 아니다. 갭을 거래하려면 전일 15:45 종가에 들어가 09:00 시가에 나와야 하는데 이 모델의 피처는 08:45 에 관측된다. 국채선물에 야간장이 없으므로 그 사이에 포지션을 만들 수 없다. 이 탐침의 값은 손익이 아니라 개장 호가 산정이다.

  • 비용을 계산하지 않았다. P3·P5 는 원리상 체결 가능하지만 현물 스프레드가 신호 크기(0.109bp/일 · 1.28%p)보다 클 수 있다. 데스크 파라미터가 확정되면 그때 다시 판정한다.
  • 레짐 분해를 하지 않았다. 연도별 표만 냈고, 지표 경고가 그 사실을 적는다.
  • P3 의 커브는 듀레이션 2차 회귀다. 쿠폰·유동성 효과가 잔차에 남고 종목 고정효과를 빼지 않았다. 잔차의 변화를 타깃으로 둔 것이 대부분을 상쇄하지만 전부는 아니다.
  • 시드 흔들림 문턱이 이번에는 판정을 가르지 않았다. 관측 흔들림이 0.0005~0.0061 로 작아 문턱이 헐거웠고 McNemar 가 먼저 걸렸다. 문턱 셋 중 하나가 무력했다는 사실을 숨기지 않는다.
  • 첫 런은 롤 당일 19일을 포함했다(P1 승률 0.8137). 그 19일이 계약 스프레드라는 것을 확인하고 표본에서 뺀 뒤 다시 돌린 것이 정본이며, 포함본은 삭제했다.
산출물

  • 사전등록protocol.md
  • 분석·판정(정본 수치)analysis.md
  • 정본 런results/20260922_164331_probes/
  • 탐침 코드code/probes9.py · code/loaders9.py
  • 채점·워크포워드code/harness9.py
  • 그림·구조도code/render_figures9.py · code/render_model9.py