세 줄 요약
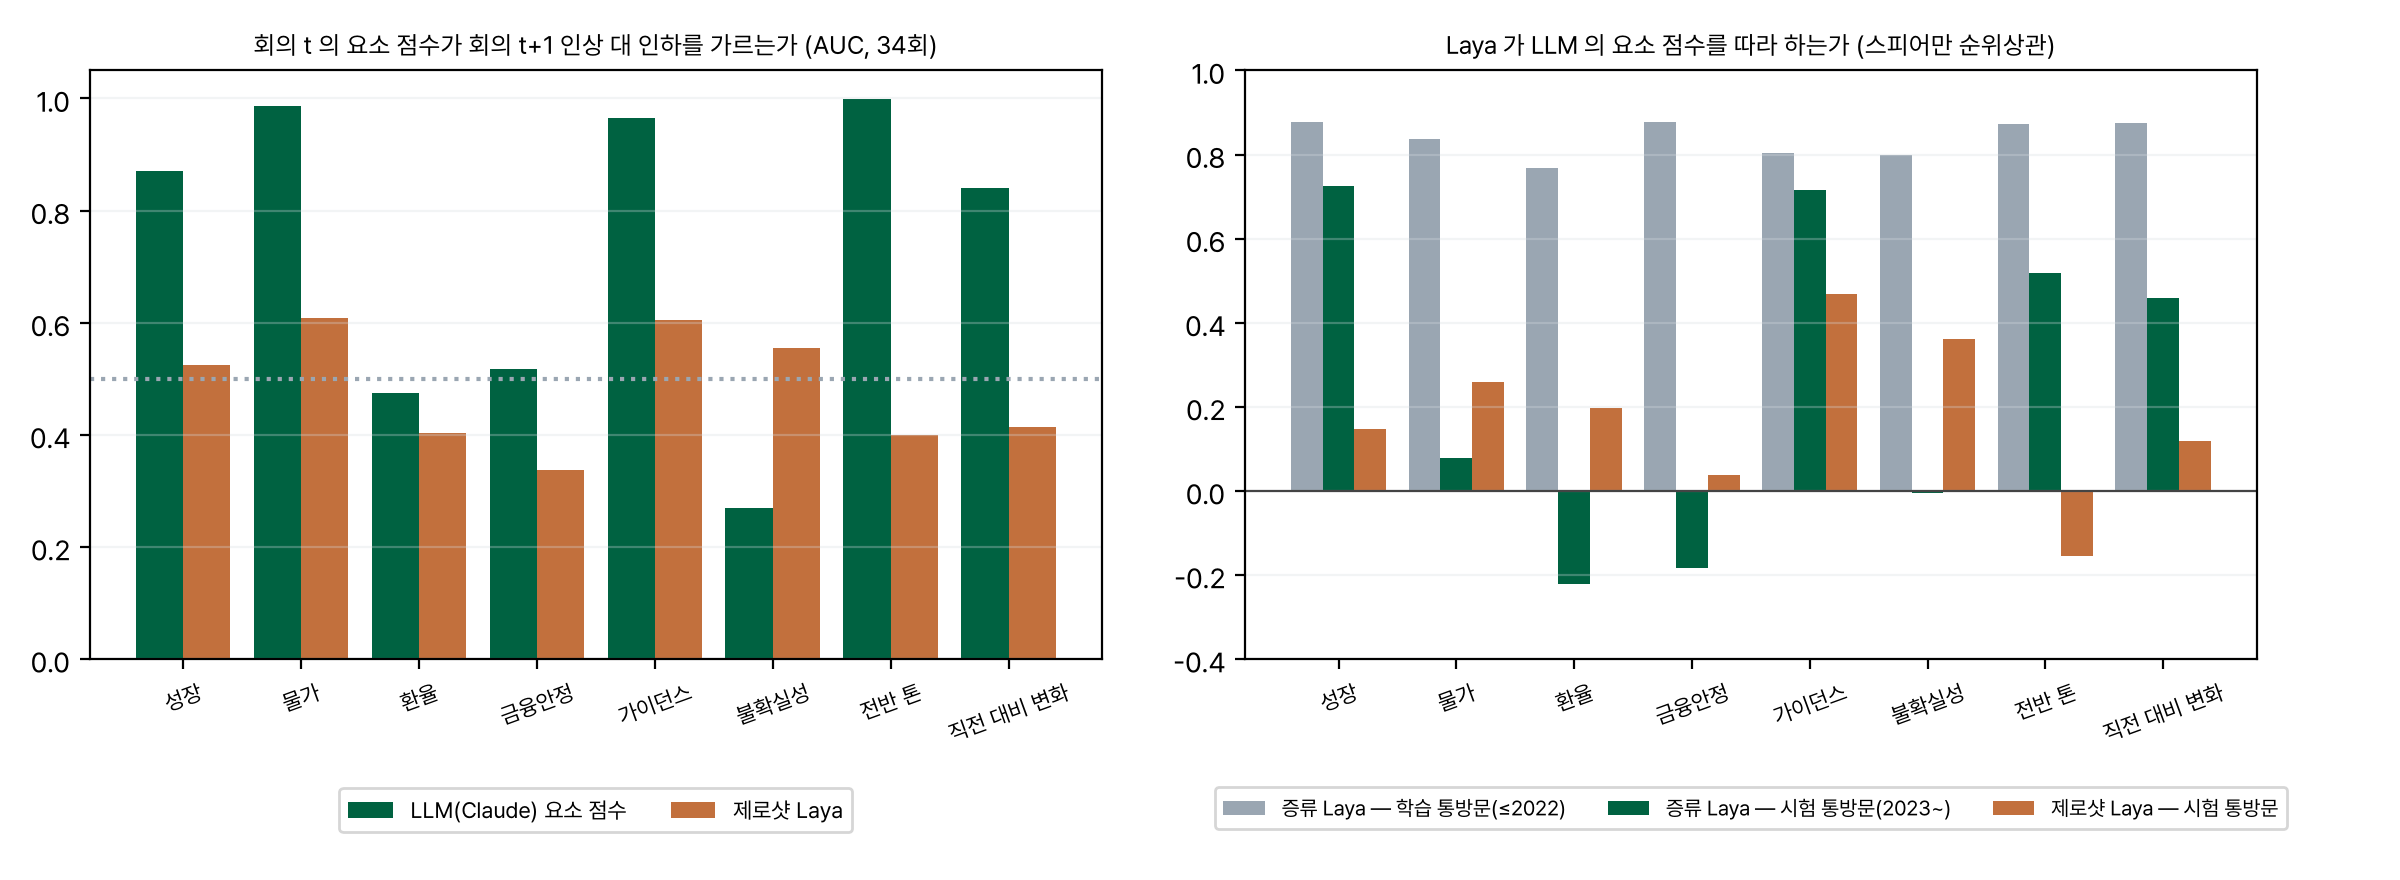
- 통방문의 톤은 읽힌다. LLM 이 매긴 요소 점수가 다음 금통위의 인상 대 인하를 거의 완벽히 가르고(AUC 0.97~1.00), 그 점수로 가르친 Laya 가 새 통방문에서도 전반 톤과 포워드 가이던스를 따라 한다(순위상관 0.52, 0.72).
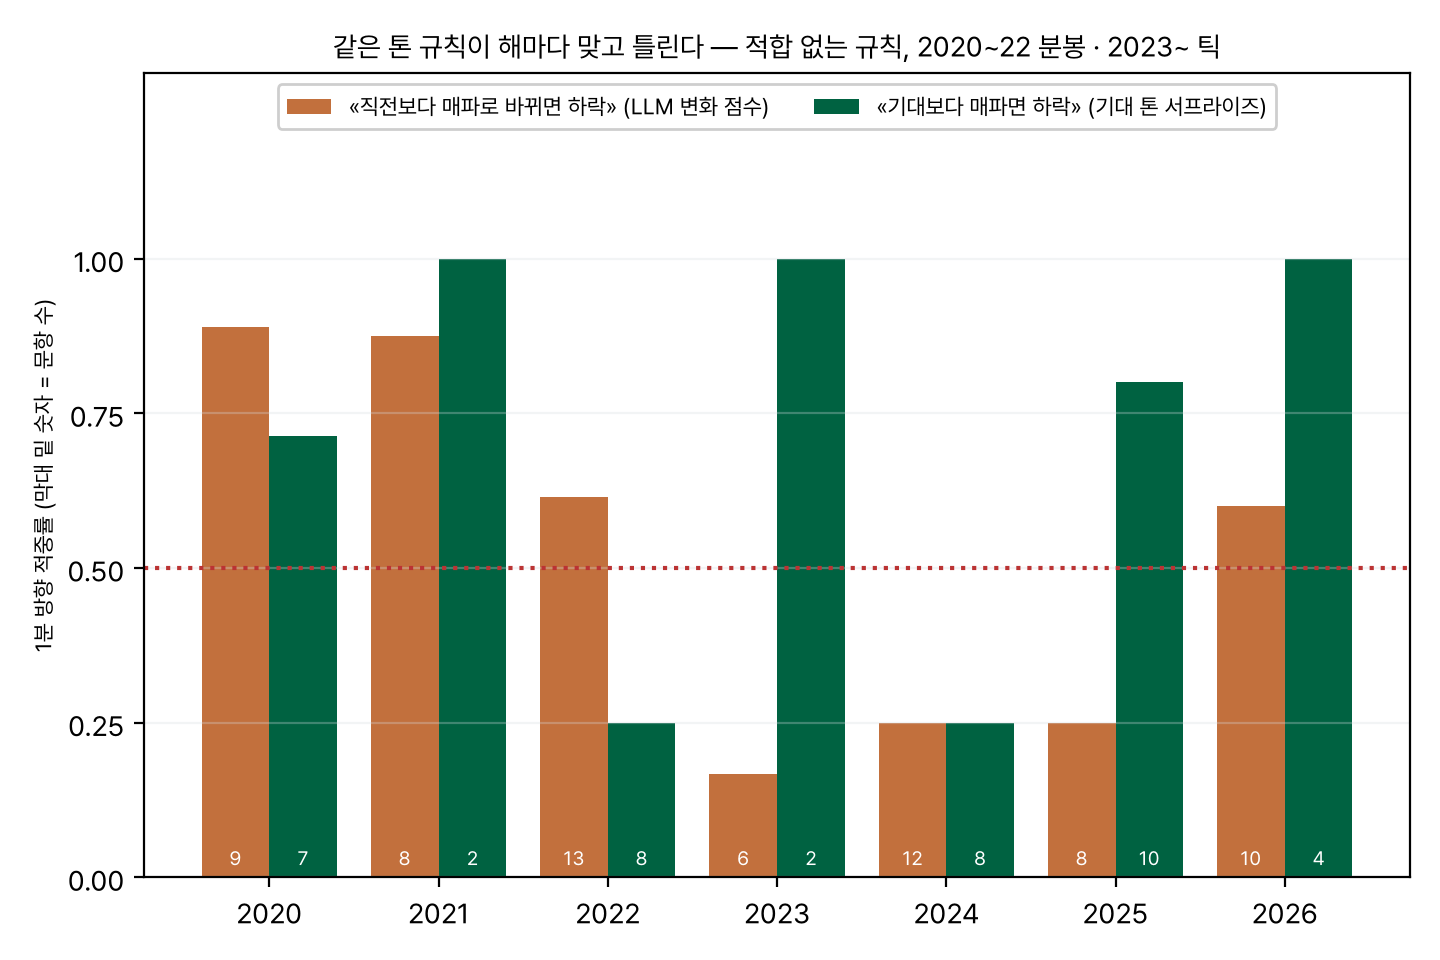
- 그러나 공개 직후 가격 방향은 읽히지 않는다. 시험(2023~2026, 초 단위 틱 1분 반응 47문항)에서 모든 모델이 우연 범위이고, «직전보다 매파면 하락» 같은 규칙은 국면마다 부호가 뒤집혔다.
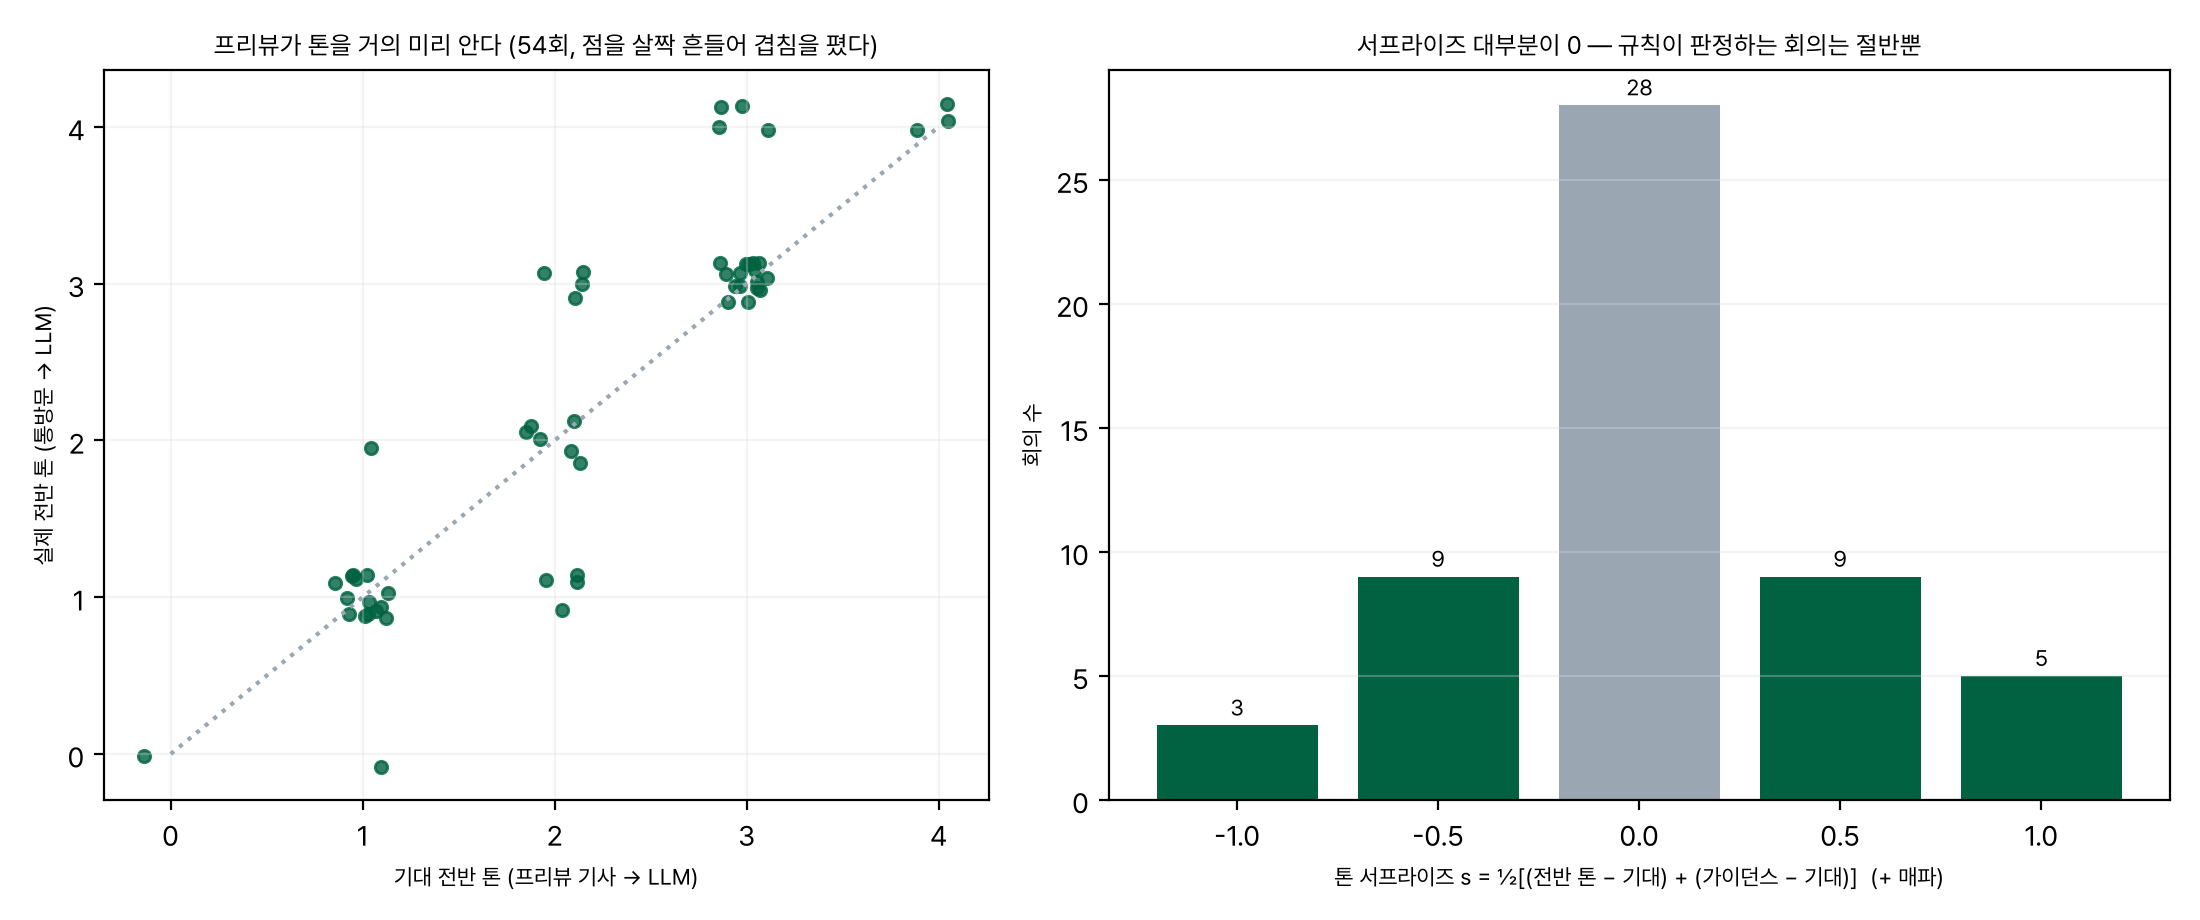
- 시장이 기대한 톤과 비교한 서프라이즈만 두 구간에서 방향이 같았다(0.667, p=0.15). 그러나 유의하지 않다.
가설과 결론
- 가설
- 통방문 텍스트(본문과 직전 통방문 대비 바뀐 문장)에는 공개 직후 3년, 10년 국채선물이 오를지 내릴지를 알려 주는 정보가 있고, 오픈소스 결정 모델 Laya 를 그 정보에 맞게 학습하면 회사 PC(CPU)에서 그 판단을 내릴 수 있다. 판마다 세운 가설 16개 (H61~H76)는 아래 결과 절에 모두 적었다.
- 결론
- 톤을 읽는 부분은 성립한다(H68, H71, H74 지지). 방향을 맞히는 부분은 성립하지 않는다. 레이블 시점을 세 번(결정 속보 뒤 5분 → 통방문 공개 뒤 5분 → 공개 뒤 1분, 초 단위 틱) 바로잡고 Laya 를 네 방식으로 써도 시험 정확도가 우연(0.5) 범위를 벗어나지 않았다. 기대 톤 대비 서프라이즈 규칙이 유일하게 부호를 유지했으나 판정할 회의가 적어 유의하지 않다. 판정은 폐기이고, 기대 톤 서프라이즈는 표본을 늘려 다시 볼 후보로 남긴다.
판을 바꿔 가며 진행했다. v1(결정 속보 기준) 결과를 본 뒤 레이블 시점을 통방문 공개로 바꿨고(v3), 초 단위 틱을 본 뒤 1분 레이블로 바꿨다(v5). 각 판의 가설은 그 판의 결과를 보기 전에 적었다. 여러 판을 거친 만큼, 어느 한 판의 좋은 숫자를 그대로 믿지 않는다. 이 리포트는 모든 판의 시험 결과를 함께 싣는다.
용어와 기호
- 통방문
- 한국은행 금융통화위원회가 통화정책방향 결정회의 뒤 내는 «통화정책방향» 결정문. 기준금리 결정, 경제 판단, 앞으로의 정책 방향을 담는다. 이 실험은 국문 보도자료 PDF 의 본문을 쓴다.
- 3선 · 10선
- 한국거래소 3년, 10년 국채선물(최근월 연결). 가격이 오르면 금리가 내린 것이다.
- 틱
- 국채선물 가격의 최소 단위 0.01. «3틱» 은 0.03 이다.
- 0틱
- 그 시간 동안 가격이 전혀 움직이지 않은 경우. 방향 레이블을 줄 수 없어 문항에서 뺀다.
- Ts
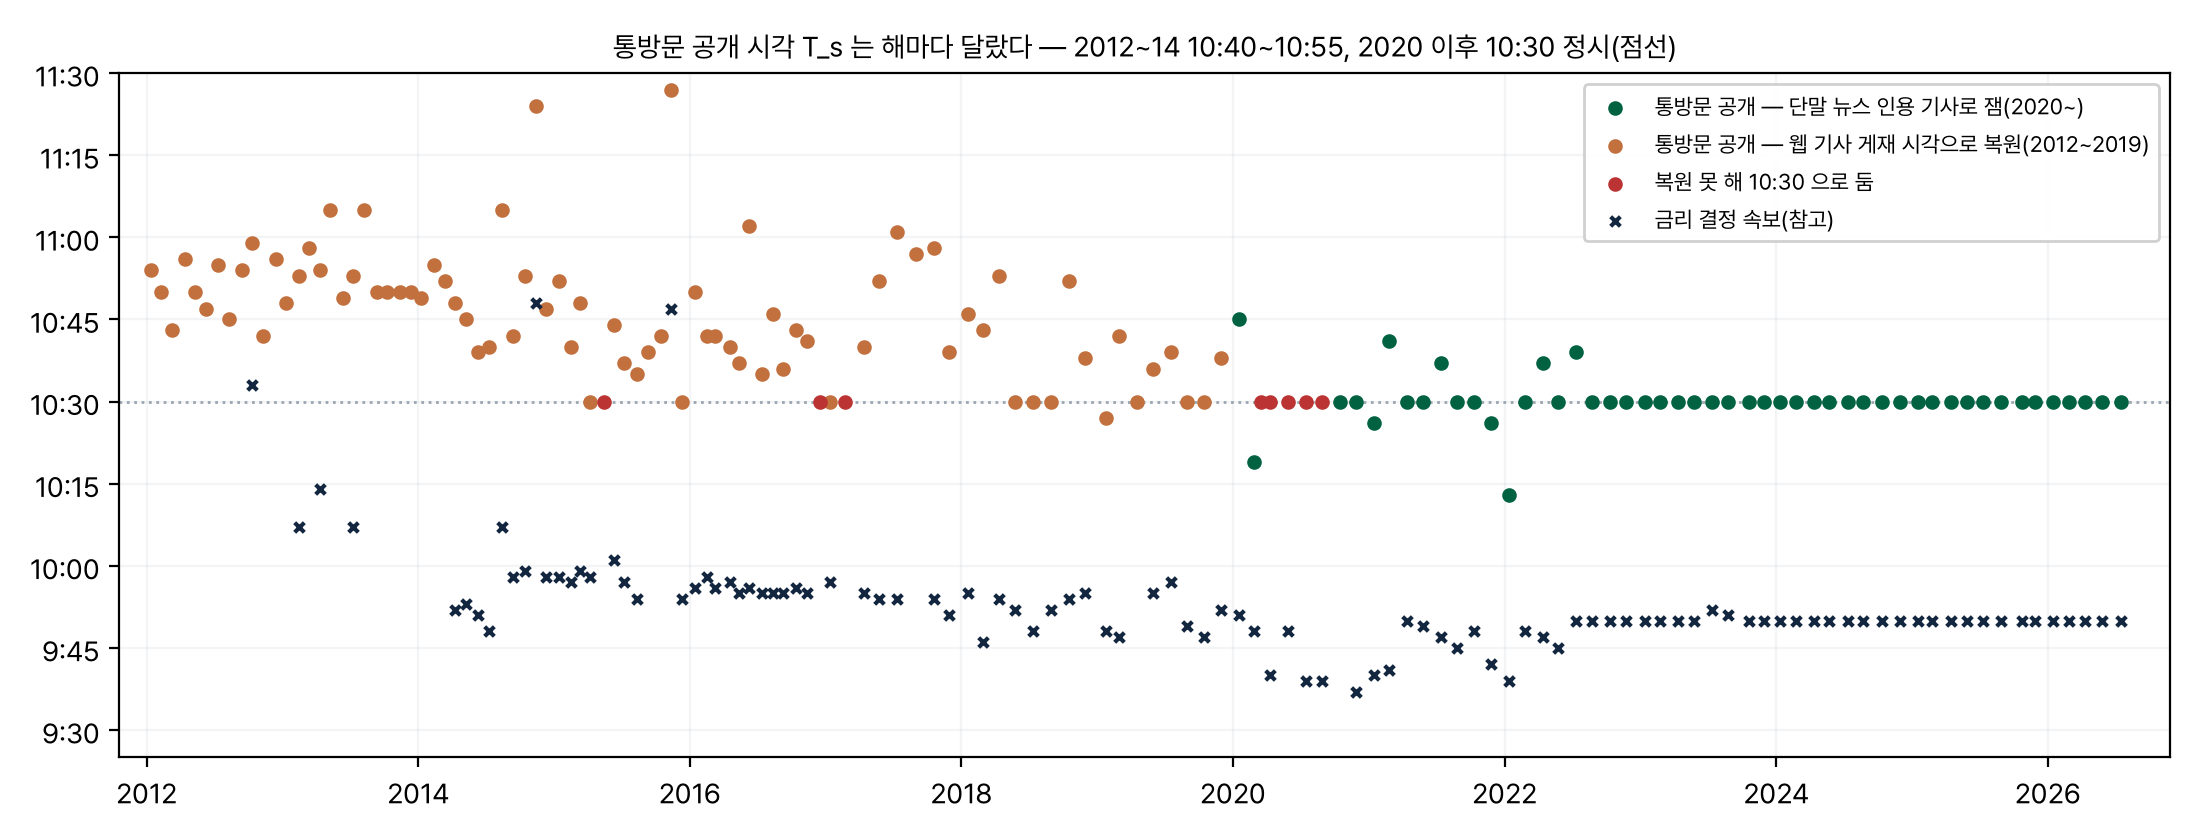
- 통방문 공개 시각. 2020년 이후 10:30 정시, 그 전은 해마다 10:40~10:55 안팎(자료 절 그림 2).
- Td
- 금리 결정 속보 시각(보통 09:40~10:00). 통방문보다 먼저 나온다.
- P(t)
- 시각 t 직전의 마지막 체결가. 분봉이면 «스탬프 t 이하 마지막 봉 종가»(봉 스탬프 = 봉의 끝).
- 반응 · reth
- P(Ts + h) − P(Ts) 를 틱으로 잰 값. h 는 시계(10초, 30초, 1분, 2분, 5분). 레이블은 부호다.
- 문항
- 회의 하나 × 계약 하나(3선 또는 10선). 반응이 0틱이면 문항이 없다.
- 매파 · 비둘기
- 매파 = 긴축(금리 인상) 쪽 톤, 비둘기 = 완화(인하) 쪽 톤. 교과서적으로 매파 → 금리 상승 → 선물 가격 하락.
- 요소 8개
- 통방문을 쪼개 읽는 축이다. 성장, 물가, 환율, 금융안정, 포워드 가이던스, 불확실성, 전반 톤, 직전 대비 변화의 여덟 개다. 각 0~4 단계, 높을수록 매파 쪽 또는 더 강한 강조.
- ek
- 요소 k 의 기대 수준 = Σ 수준 × 확률. 방법 B 는 −2 를 빼 −2(비둘기)~+2(매파)로 둔다.
- 기대 톤 · s
- 금통위 전 프리뷰 기사만 읽고 LLM 이 예상한 요소 수준. 톤 서프라이즈 s = ½[(실제 전반 톤 − 기대) + (실제 가이던스 − 기대)], 양수면 매파 서프라이즈.
- Laya
- 글을 생성하지 않고 «상태(state)» 를 읽어 «타입이 정해진 질문» 에 한 번의 순전파로 답하는 오픈소스 결정 모델(Apache 2.0). 이 실험은
다국어 체크포인트
laya-multilingual(한국어 포함)을 쓴다. - choice · score
- Laya 질문 타입. choice = 선택지 중 하나(여기서는 상승/하락), score = 순서 있는 단계(여기서는 0~4). score 는 단계별 확률과 기대 수준을 낸다.
- 제로샷
- 이 실험의 자료로 학습하지 않은 원래 체크포인트를 그대로 쓴 것.
- 증류
- 큰 모델(여기서는 LLM Claude)이 매긴 답을 정답으로 삼아 작은 모델(Laya)을 학습시키는 것.
- LLM 요소 점수
- Claude 가 통방문 162건을 읽고 요소 8개를 0~4 로 매긴 값. 회의일 이후 지식(이후 결정과 시장 반응)을 쓰지 말라고 지시했다.
- 다수(학습)
- 기준선. 학습 구간에서 더 많았던 방향을 시험의 모든 문항에 답한다.
- 결정 규칙
- 기준선. 인상이면 «하락», 인하면 «상승», 동결이면 다수(학습).
- 직전 반응
- 기준선. 같은 계약의 직전 회의 반응 방향을 그대로 따른다.
- 공개 전 추종
- 기준선. Td 직전 ~ Ts 사이의 가격 움직임 부호를 따른다(통방문 공개 전에 알려진 값).
- 정확도
- 시험 문항 중 방향을 맞힌 비율(0틱 문항 제외).
- AUC
- 점수가 두 집단(여기서는 다음 회의 인상 대 인하)을 얼마나 잘 가르는지. 0.5 = 무작위, 1.0 = 완벽, 0.5 미만 = 거꾸로.
- 스피어만 순위상관 ρ
- 두 값의 순위가 얼마나 같이 움직이는지(−1~+1).
- 이항검정
- 정확도가 0.5 와 다른지 보는 검정. p 는 우연히 그만큼 맞힐 확률.
- McNemar 검정
- 같은 문항을 두 모델이 푼 결과를 짝지어, 한쪽만 맞은 문항 수(b:c)로 두 모델이 다른지 보는 정확 검정.
- ECE
- 기대 보정 오차. 모델이 말한 확신도와 실제 적중률의 차이(0 이면 완벽 보정).
- 보정 온도
- 모델 확률을 부드럽게(온도 > 1) 또는 날카롭게 만드는 배율. 학습 구간 끝 20% 로 맞춘다. 상한 10 에 붙으면 «출력에 쓸 정보가 없다» 는 뜻이다.
- KL 닻 λ
- 방법 B 에서 요소 분포가 학습 전(제로샷) 분포에서 멀어지지 않게 거는 벌점의 세기.
자료
| 자료 | 기간 | 규모 | 해상도 | 쓰임 | 제외·주의 |
|---|---|---|---|---|---|
| 통방문(국문 보도자료 PDF) | 2010-01-08 ~ 2026-08-27 | 163건 | 회의당 1건 | 모델 입력(본문·직전 대비 바뀐 문장) | 2011-05-13 은 본문이 이미지라 제외 → 162건. PDF 줄바꿈 공백 오염 남음 |
| 국채선물 1분봉(3선·10선) | 2012-01 ~ 2026-09 | 회의일 138회 | 1분 | 2012~2022 레이블 | 2010~2011 은 분봉이 없어 레이블 없음 |
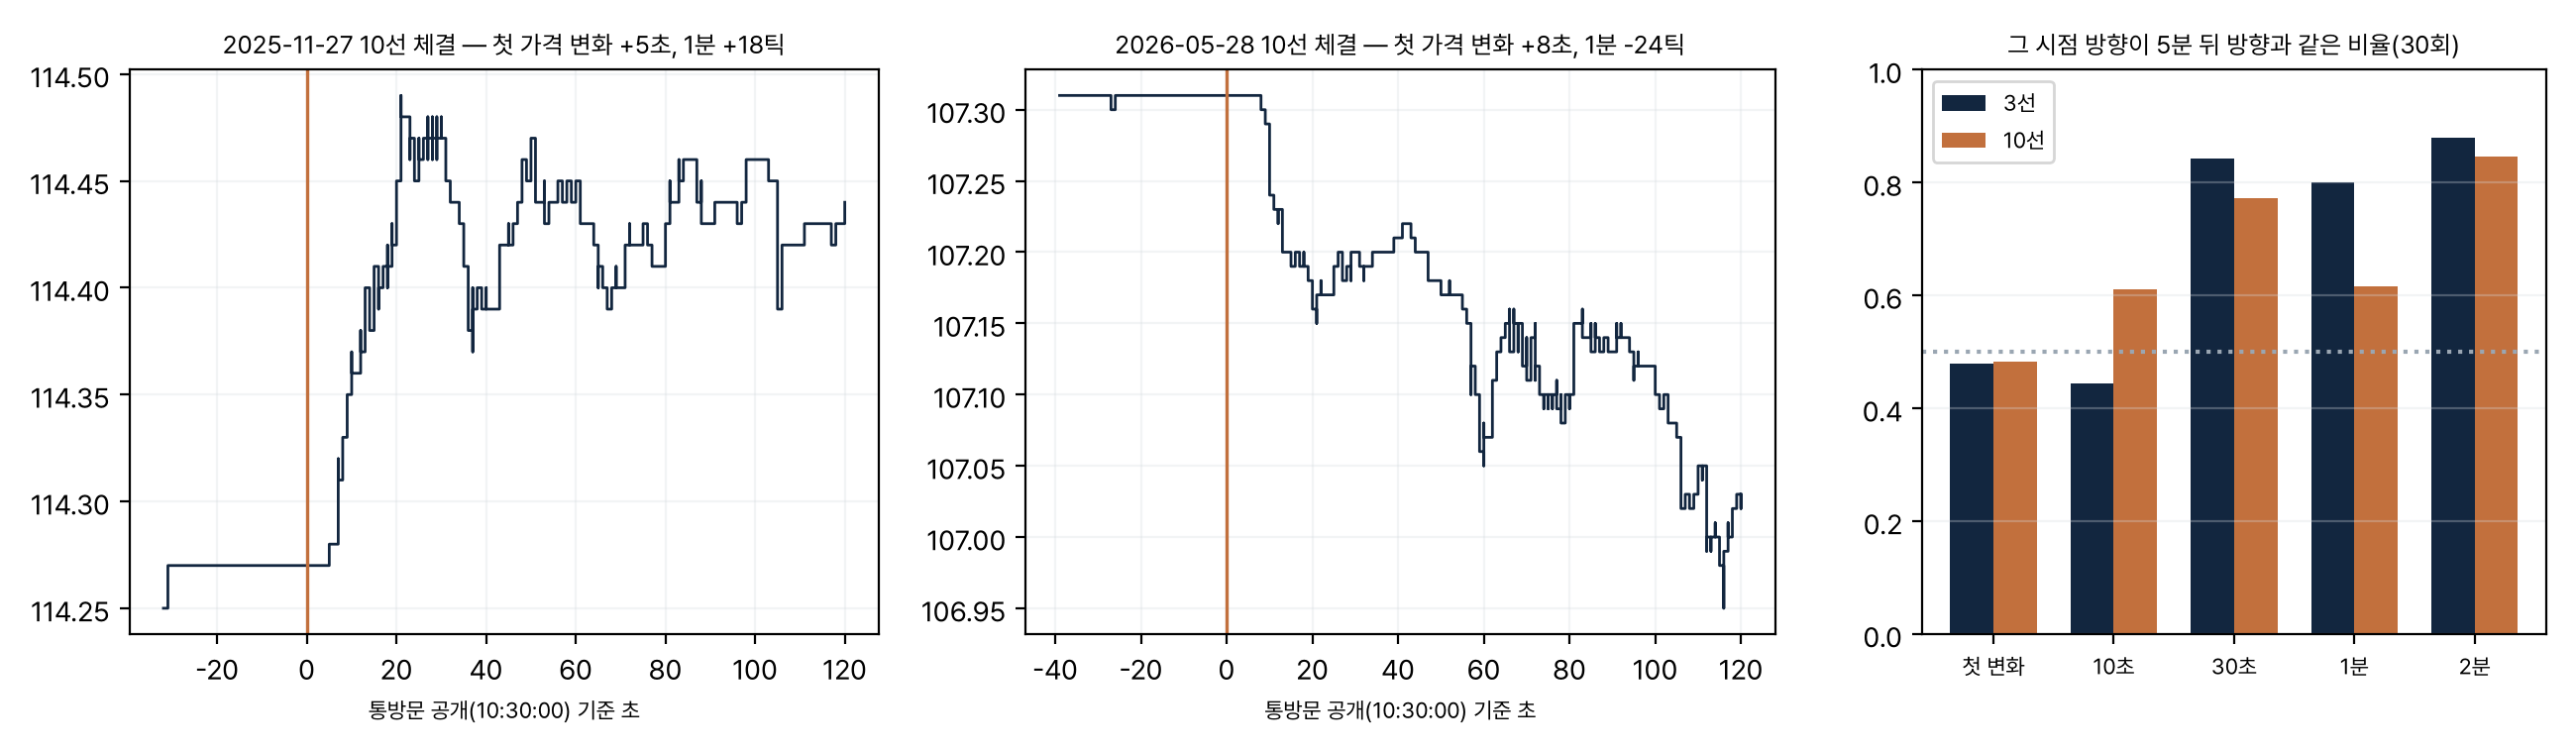
| 국채선물 체결틱(3선·10선) | 2023-01-02 ~ 2026-09-28 | 회의일 30회 | 1초 | 2023~ 시험 레이블(10초~5분) | 2023 이전 초 단위 틱은 어디에도 없다 |
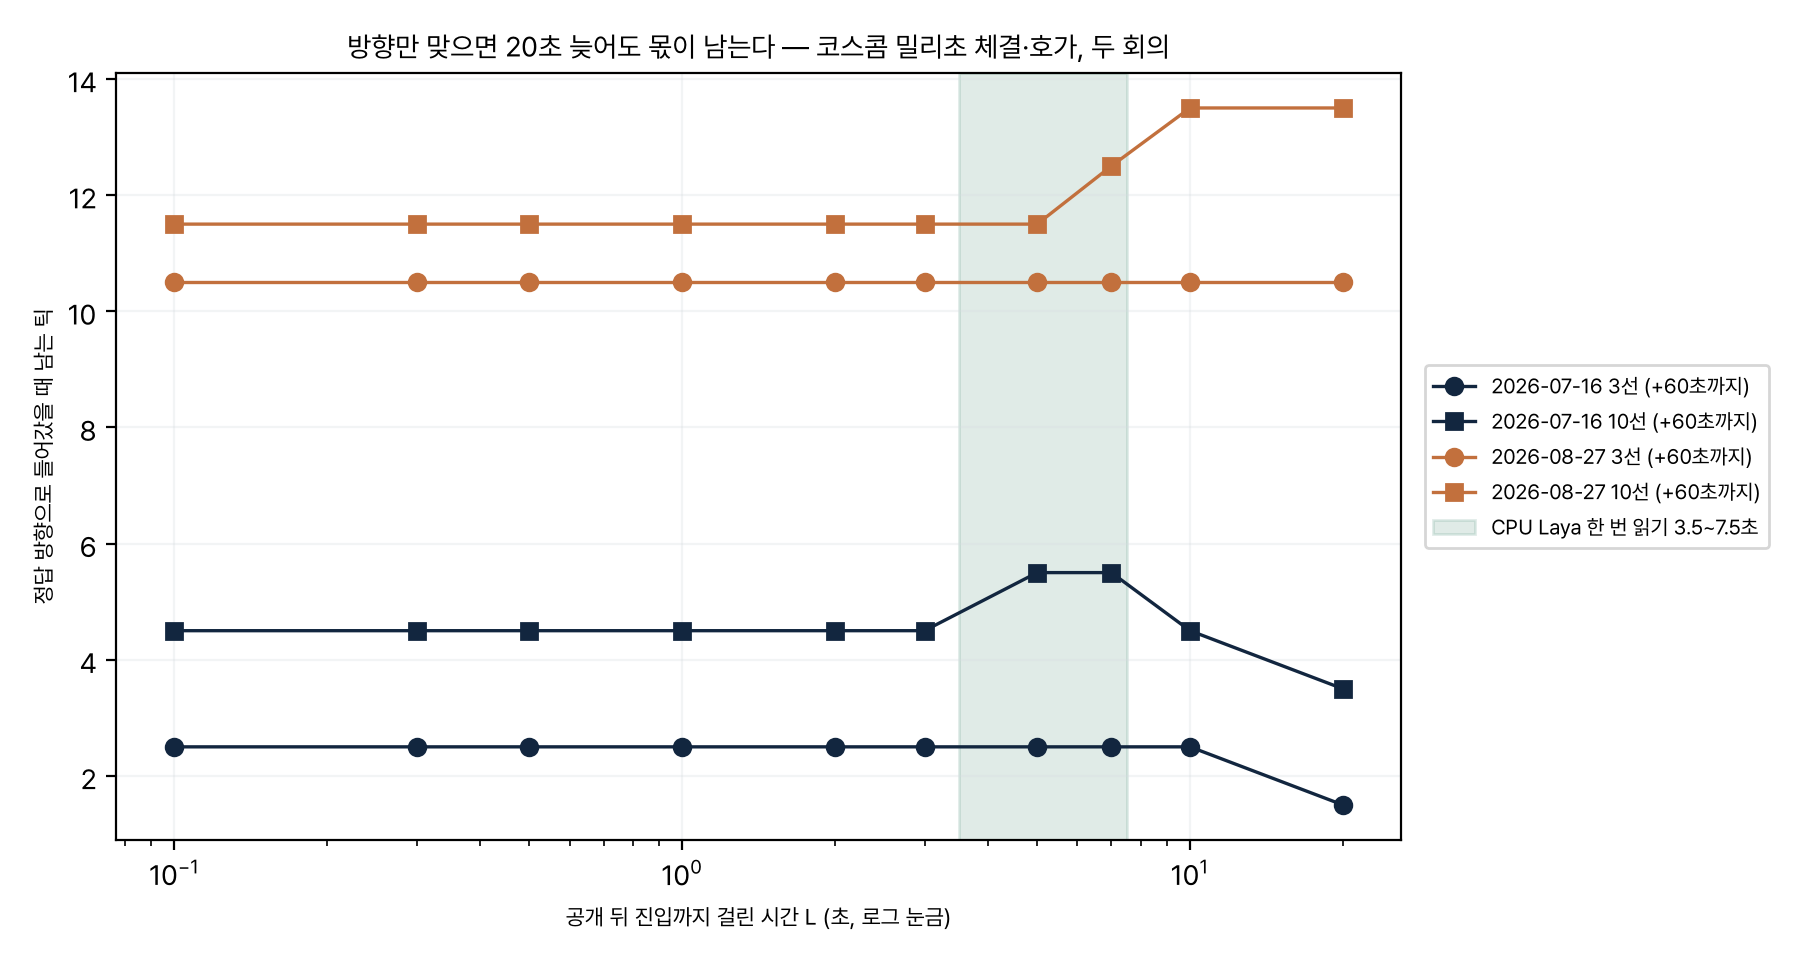
| 코스콤 체결·호가 | 2026-07-08 ~ | 회의일 2회 | 밀리초(거래소 시각) | 반응 속도·지연 비용 | 체결 건수가 초 단위 틱의 약 절반 — 수집에 빠진 체결이 있다 |
| 뉴스 기사 게재 시각 | 2012 ~ 2026 | 회의일 136회 | 초(2020~) · 분(웹) | Ts·Td 복원 | 2012~2019 는 웹 기사 게재 시각 −2분으로 추정 |
| 금통위 프리뷰 기사 | 2020-01 ~ 2026-07 | 54회 | 회의 7일 전 ~ 당일 09:00 | 기대 톤(v6) | 본문은 2021-11 부터, 그 전은 제목만. 연도 숫자를 지우고 회의를 익명화 |
| 채권 전문가 설문 기사 | 2020-08 ~ 2026-07 | 44회 | 회의 2~5일 전 | 결정 서프라이즈(bp) | 비율이 없는 제목은 낱말로 근사 |
| 금통위 결정표 | 2010-01 ~ 2026-08 | 163회 | 회의당 | 결정·기준금리, 결정 규칙 기준선, 다음 결정(AUC) | — |
«직전 통방문 대비 바뀐 문장» 을 고르는 방법과 한계
두 통방문을 문장으로 나누고, 숫자, 공백, 문장부호를 지운 꼴끼리 글자 유사도를 잰다. 이번 문장이 직전 통방문의 어느 문장과도 유사도 0.60 미만이면 «새로 등장한 문장», 거꾸로면 «사라진 문장» 이다(각 6개까지). 숫자만 바뀐 문장은 같은 문장으로 본다. 이 방법은 얼마나 바뀌었는지를 잴 뿐 뜻이 바뀌었는지를 재지 못한다. 2024-04-12 의 «긴축 기조를 충분히 장기간 지속할 것» → «충분히 유지할 것» 은 시장이 가장 주목한 수정이었지만 유사도 0.675 라 같은 문장으로 처리됐다. 인접 통방문 문장 2,651개 중 37.6% 가 «문구 일부가 바뀌었는데 같은 문장 취급» 이다.
레이블과 분할
레이블은 «공개 직후 가격이 올랐나 내렸나» 의 부호다. 판마다 기준 시점과 시계가 다르다.
| 판 | 기준 시점 | 시계 | 해상도 | 학습 | 시험 | 가설 |
|---|---|---|---|---|---|---|
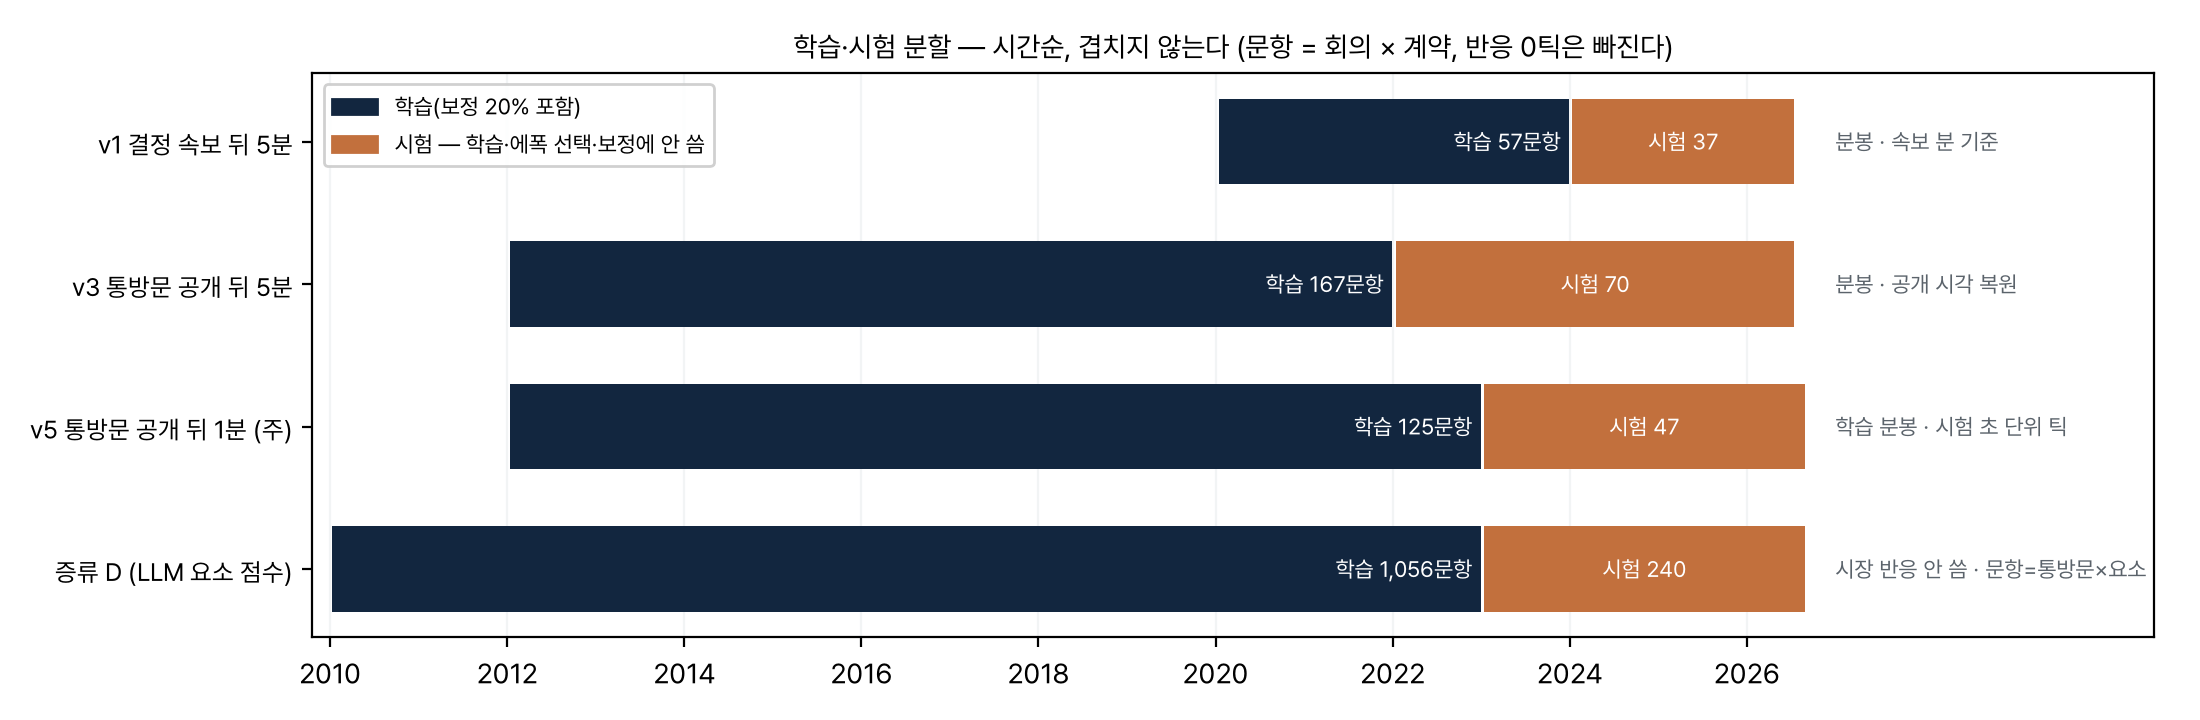
| v1 | 금리 결정 속보(뉴스 첫 게재 분, 거래량으로 정련) | 5분 | 1분봉 | 2020~2023 · 57문항 | 2024~2026-07 · 37문항 | H61~H63 |
| v3 | 통방문 공개 Ts | 5분 | 1분봉 | 2012~2021 · 167문항 | 2022~2026-07 · 70문항 | H64~H67 |
| v4 | Ts = 10:30:00 | 10초~5분 | 1초 틱 | (재평가만) | 2023~2026 · 30회 | — |
| v5 (주) | Ts | 1분 | 학습 1분봉 · 시험 1초 틱 | 2012~2022 · 125문항 | 2023~2026-08 · 47문항 | H68~H73 |
| v6 | Ts | 30초·1분·5분 | 2020~22 분봉 · 2023~ 틱 | (적합 없음) | 2020~2026-07 · 54회 | H74~H76 |
모델
모든 방법은 같은 사전학습 가중치(laya-multilingual, 3억 2,190만 파라미터)에서 출발하거나 그 출력을 쓴다. 학습은 Kaggle 무료 GPU
(T4 2장, 분산 데이터 병렬)에서, 추론 속도 측정은 CPU 에서 했다.
| 방법 | 무엇을 학습하나 | 질문·출력 | 하이퍼파라미터 |
|---|---|---|---|
| 제로샷 choice | 학습 없음 | 상승/하락 choice | 원래 체크포인트, 온도 1.0, max_len 4,096, head_max_len 256 |
| C · choice 파인튜닝 | 인코더·결정 헤드 전체 | 상승/하락 choice | 에폭 12 · 미니배치 2 · 누적 1 · AdamW(가중치 감쇠 0.01) · 학습률 인코더 2.0e-5 · 헤드 1.0e-4 · 코사인 감쇠(최저 1e-6) · 손실 = 정책경사(잡음 표본 4개, σ 0.4→0.1, 보상 = 구면 점수 0.75 + 순위확률점수 1.0) + 소프트 교차 엔트로피 1.0 · 기울기 자르기 1.0 · fp16 · 보정 = 학습 끝 20%(최소 10) 온도 적합(0.1~10) · 시드 0·1·2 |
| B · 요소 가중합 끝단 학습 | 인코더·헤드 + 가중치 w(계약 2 × 요소 8) + 절편 b | 요소 8개 score → e → 로짓 b + w·e | 에폭 8 · 회의 하나(질문 8개)가 한 걸음 · AdamW(0.01) · 학습률 인코더 1.0e-5 · 헤드 1.0e-4 · w·b 1.0e-2(감쇠 0) · 손실 = 이진 교차 엔트로피 + λ·KL(요소 분포 ‖ 제로샷 분포), λ = 1 · 코사인 감쇠 · 기울기 자르기 1.0 · fp16 · 시드 0·1·2 |
| D · LLM 요소 증류 | 인코더·헤드(요소 score 질문) | 요소 8개 score → 시험 통방문을 다시 읽음 | C 와 같은 학습기 · 에폭 10 · 시드 0 · 정답 분포 = LLM 수준 0.70, 이웃 수준 0.15 씩 · 학습 통방문 ≤2022(1,056 항목) · 이어서 요소 [수준 8, 직전 대비 변화 8] → 표준화 → 로지스틱(L2, C = 0.3, lbfgs, 최대 3,000회) |
| A · 제로샷 요소 + 로지스틱 | 로지스틱 계수 | 요소 16개 → P(상승) | 표준화 → 로지스틱(L2, C = 0.3), 계약별 · v3 5분 레이블 |
| E · LLM 요소 + 로지스틱 | 로지스틱 계수 | 요소 16개 → P(상승) | 표준화 → 로지스틱(L2, C = 0.3), 계약별 · v5 1분 레이블 |
| 기대 톤 서프라이즈 규칙 | 학습 없음 | s > 0 → 하락, s < 0 → 상승 | 적합하는 값이 없다 |
아래 구조도와 계수는 학습된 모델 객체에서 그렸다. Laya 는 저장해 둔 체크포인트로 커밋된 시험 예측을 다시 내 같은지 확인했고, 로지스틱 결합기는 다시 적합해 기록된 시험 정확도가 그대로 나오는지 확인했다.
Laya-multilingual — 방법 B·C·D 가 공유하는 결정 모델
| # | 부분 | 텐서(한 층) | 모양 | 층 수 | 원소 수(전체) |
|---|---|---|---|---|---|
| 1 | encoder.embeddings | tok_embeddings.weight | [256000, 768] | 1 | 196,608,768 |
| norm.weight | [768] | |||
| 2 | encoder.layers[0..21] | attn_norm.weight | [768] | 22 | 110,330,112 |
| attn.Wqkv.weight | [2304, 768] | |||
| attn.Wo.weight | [768, 768] | |||
| mlp_norm.weight | [768] | |||
| mlp.Wi.weight | [2304, 768] | |||
| mlp.Wo.weight | [768, 1152] | |||
| 3 | encoder.final_norm | weight | [768] | 1 | 768 |
| 4 | type_emb | weight | [3, 768] | 1 | 2,304 |
| 5 | head.layers[0..1] | self_attn.in_proj_weight | [2304, 768] | 2 | 14,175,744 |
| self_attn.in_proj_bias | [2304] | |||
| self_attn.out_proj.weight | [768, 768] | |||
| self_attn.out_proj.bias | [768] | |||
| linear1.weight | [3072, 768] | |||
| linear1.bias | [3072] | |||
| linear2.weight | [768, 3072] | |||
| linear2.bias | [768] | |||
| norm1.weight | [768] | |||
| norm1.bias | [768] | |||
| norm2.weight | [768] | |||
| norm2.bias | [768] | |||
| 6 | scorer | 0.weight | [768] | 1 | 592,897 |
| 0.bias | [768] | |||
| 1.weight | [768, 768] | |||
| 1.bias | [768] | |||
| 3.weight | [1, 768] | |||
| 3.bias | [1] | |||
| 7 | act_head | 0.weight | [256, 772] | 1 | 198,402 |
| 0.bias | [256] | |||
| 2.weight | [2, 256] | |||
| 2.bias | [2] |
방법 B — 요소 8개 기대 수준의 가중합
| 시드 | 계약 | 성장 | 물가 | 환율 | 금융안정 | 가이던스 | 불확실성 | 전반 톤 | 직전 대비 변화 | 절편 b |
|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 3선 | +0.146 | -0.157 | +0.273 | -0.049 | -0.072 | -0.351 | -0.041 | -0.145 | +0.005 |
| 10선 | +0.302 | +0.201 | +0.624 | +0.495 | +0.427 | +0.604 | -0.062 | -0.072 | -0.079 | |
| 1 | 3선 | +0.319 | -0.249 | -0.028 | -0.156 | -0.291 | -0.511 | -0.011 | -0.152 | +0.057 |
| 10선 | +0.581 | -0.156 | +0.389 | +0.324 | -0.003 | -0.494 | -0.002 | -0.104 | -0.026 | |
| 2 | 3선 | +0.495 | -0.155 | -0.077 | -0.222 | -0.166 | -0.380 | -0.110 | -0.484 | +0.018 |
| 10선 | +0.858 | +0.229 | +0.304 | +0.328 | +0.265 | +0.692 | -0.176 | -0.543 | -0.058 |
w·b)를 그대로 옮긴 것이다.방법 A — 제로샷 Laya 요소 점수 + 로지스틱 (v3, 5분 레이블)
방법 E — LLM 요소 점수 + 로지스틱 (v5, 1분 레이블)
방법 D — 증류 Laya 요소 점수 + 로지스틱 (v5, 1분 레이블)
결과 1 · 방향 예측
| 모델 | 정확도 | «상승» 으로 답한 비율 | p | 비고 |
|---|---|---|---|---|
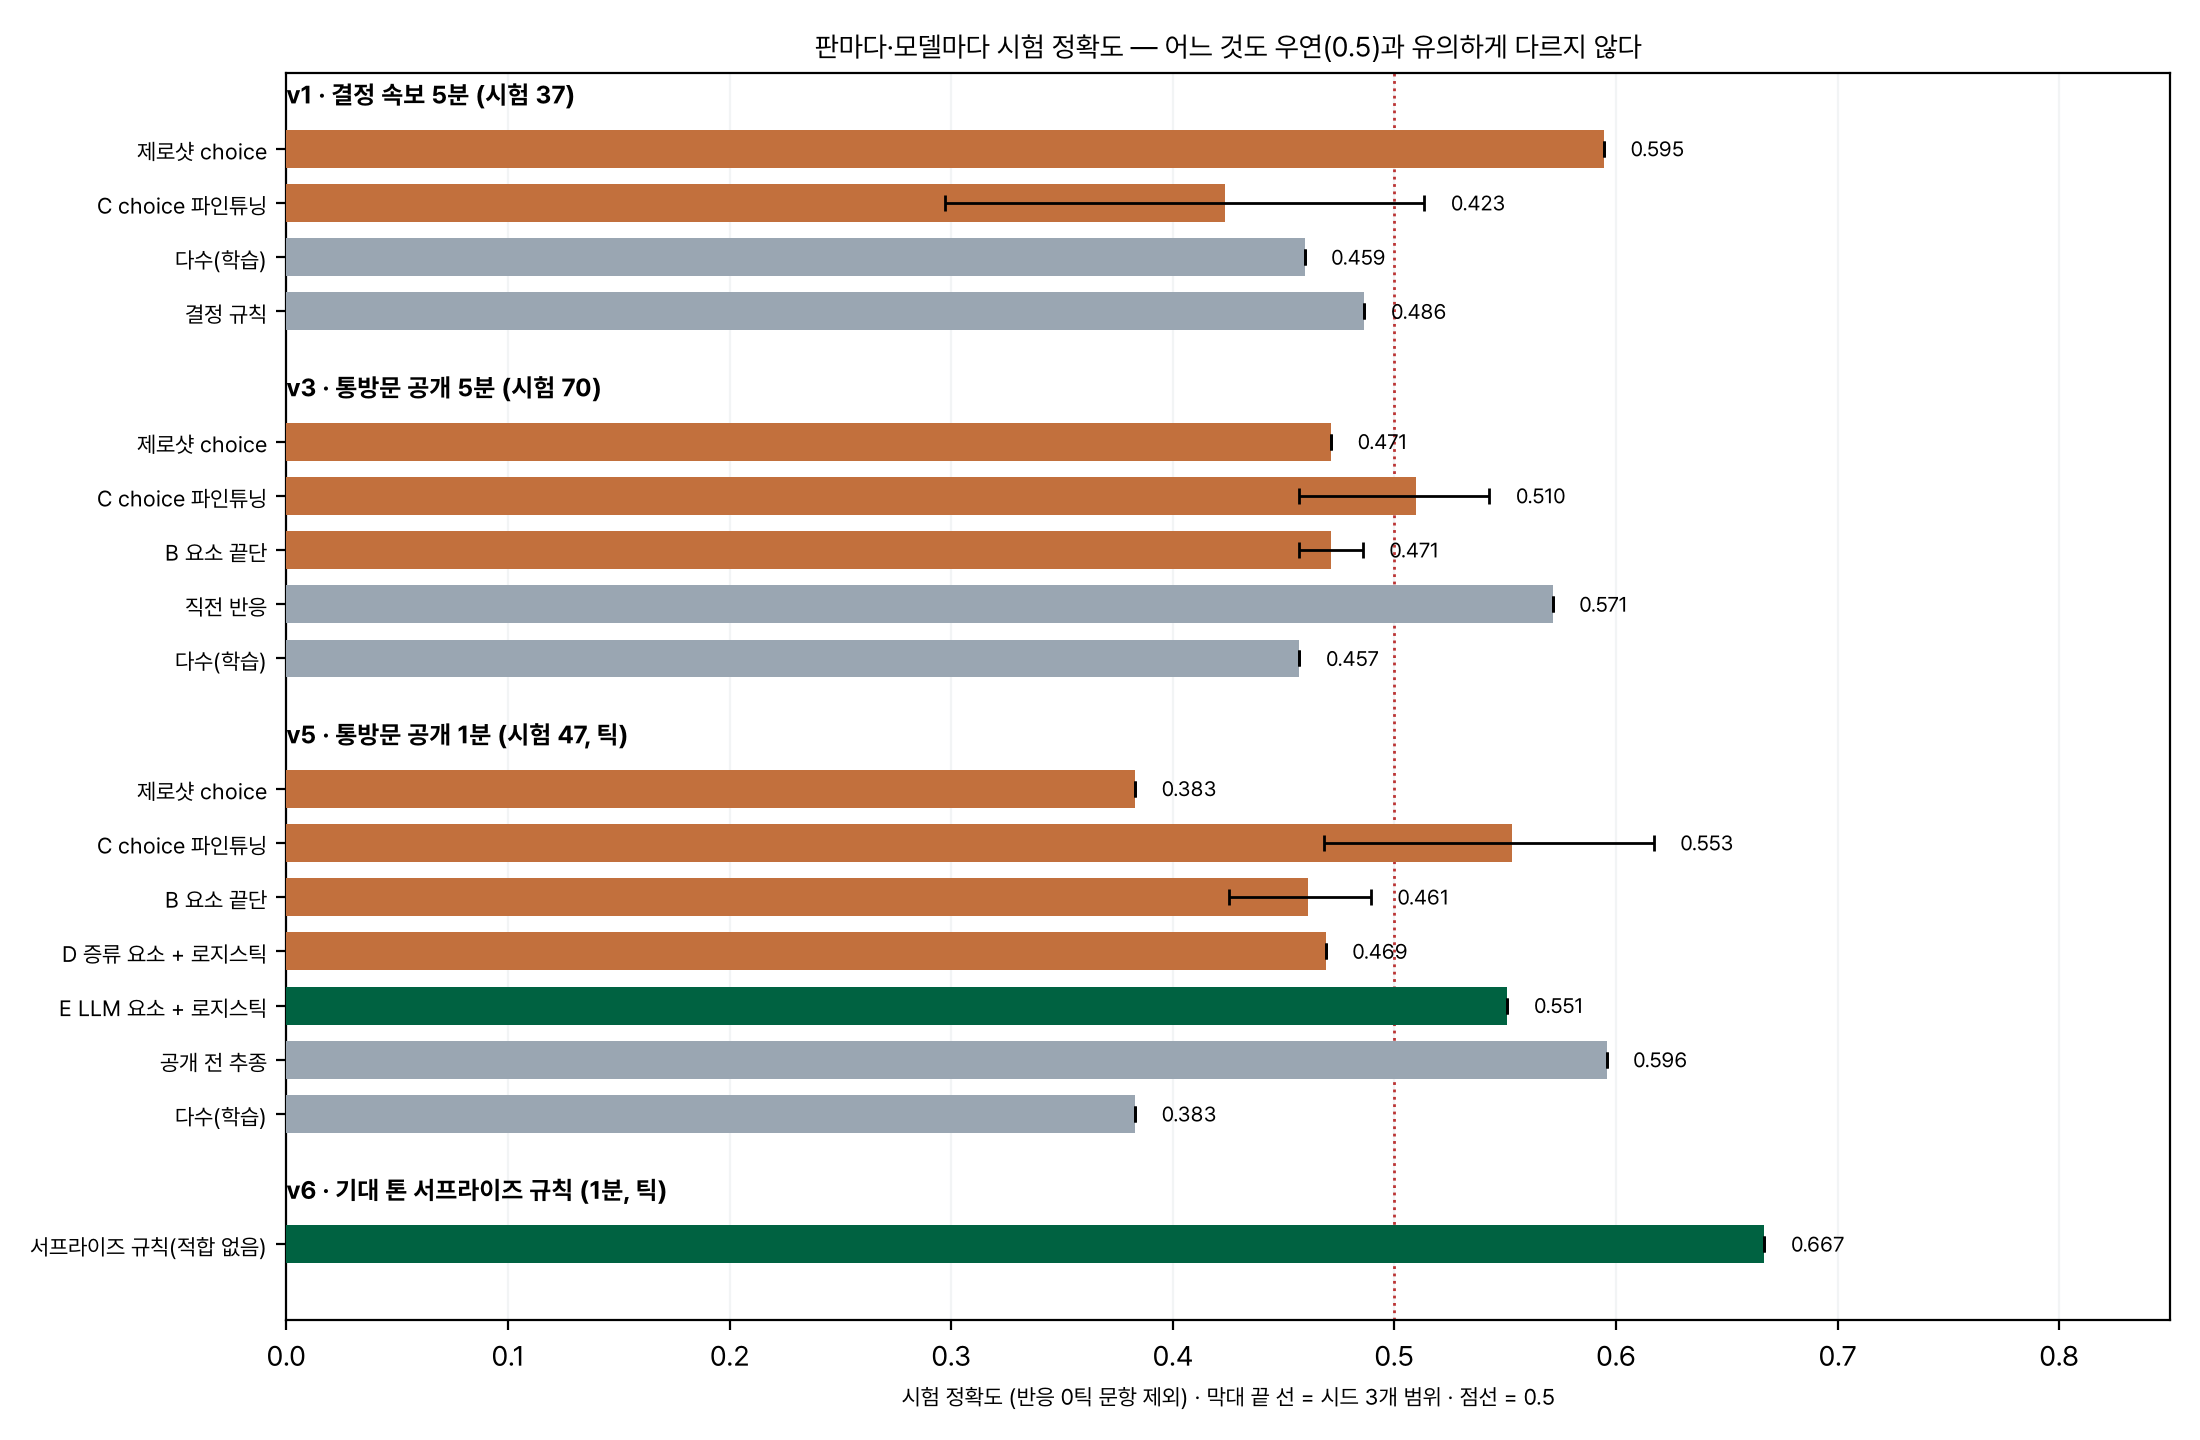
| 제로샷 choice | 0.383 | 0.17 | 0.14 | 대부분 «하락» |
| C choice 파인튜닝 s0 / s1 / s2 | 0.468 / 0.617 / 0.574 | 0.60 / 1.00 / 0.79 | ≥ 0.14 | 잘 나온 시드는 «항상 상승» 과 같다. 보정 온도 세 시드 모두 상한 10 |
| B 요소 끝단 s0 / s1 / s2 | 0.468 / 0.489 / 0.426 | 0.34~0.55 | ≥ 0.38 | 학습 손실 0.69 → 0.22~0.32 — 외웠다 |
| D 증류 요소 + 로지스틱 | 0.469 | — | 0.78 | |
| E LLM 요소 + 로지스틱 | 0.551 | — | 0.57 | 30초 0.595 · 5분 0.446 — 시계마다 흔들린다 |
| 다수(학습) | 0.383 | 0.00 | 0.14 | 학습 구간은 하락이 조금 많았다 |
| 공개 전 추종 | 0.596 | — | 0.24 | |
| 직전 반응 | 0.532 | — | 0.77 |
| 가설 | 내용 | 결과 | 판정 |
|---|---|---|---|
| H61 | v1 C > 다수(학습) | 평균 0.423 < 0.459 | 미지지 |
| H62 | v1 C > 제로샷 | s2 는 제로샷보다 나쁘다(5:16, p = 0.027) | 미지지 |
| H63 | v1 C > 결정 규칙 | 0.423 < 0.486 | 미지지 |
| H65 | v3 A > 최고 기준선 | 0.514 < 직전 반응 0.571(19:23, p = 0.64) | 미지지 |
| H66 | v3 B 평균 > C 평균 | 0.471 < 0.510 | 미지지 |
| H67 | B 가중치 상위 2위에 가이던스·변화 | 시드마다 다름, «변화» 는 없음 | 미지지 |
| H69 | «LLM 변화 > 2 → 하락» > 0.5 (적합 없음) | 시험 1분 0.333(36, p = 0.065) — 거꾸로 유의. 2020~22 분봉 0.767(30, p = 0.005) | 미지지(부호 뒤집힘) |
| H70 | v5 E > 다수(학습) | 0.551 > 0.383 이나 E 가 «대부분 상승» 이라 기저율 차이 | 미지지 |
| H72 | 톤 − 결정 종류별 평균 톤 규칙 > 0.5 | 시험 1분 0.469(49) | 미지지 |
| H73 | v5 C·B 평균 > 다수(학습) | C 0.553 > 0.383 이나 «항상 상승»(0.617)과 같다 | 형식상 충족 · 실질 미지지 |
결과 2 · 톤 판독
| 가설 | 내용 | 결과 | 판정 |
|---|---|---|---|
| H64 | 제로샷 Laya 가이던스가 다음 인상/인하를 AUC > 0.70 | 0.604 | 미지지 |
| H68 | LLM 가이던스가 다음 인상/인하를 AUC > 0.70 | 0.965(전반 톤 0.998) | 지지 |
| H71 | 증류 Laya 의 전반 톤·가이던스가 시험 통방문에서 LLM 과 ρ ≥ 0.5 | 0.518 · 0.716 | 지지 |
LLM 요소 점수의 AUC 는 금리 사이클의 지속성(지금 매파 → 다음에도 인상)을 대부분 반영하고, LLM 이 회의 뒤의 역사를 알고 있을 수 있어 사후 지식이 섞였을 가능성을 배제하지 못한다. 그래도 증류 Laya 가 새 통방문에서 LLM 을 따라 한다는 것은 «온프렘 톤 판독기» 로서의 가능성을 보여 준다.
결과 3 · 기대 톤 대비 서프라이즈
톤 규칙의 부호가 국면마다 뒤집힌다면, 반응을 정하는 것은 «직전 통방문 대비» 가 아니라 «시장이 기대한 톤 대비» 일 수 있다. 회의 7일 전 ~ 당일 09:00 의 프리뷰 기사만 LLM 에게 주고 나올 통방문의 요소를 예상하게 했다(통방문, 결정, 반응은 보여 주지 않았다). 병렬 에이전트가 임시 파일을 같이 써서 서로의 입력을 읽었을 가능성이 발견돼 격리한 뒤 다시 매겼고, 두 실행은 요소별 83~98% 같았다(±1 안 100%).
| 구간 | 30초 | 1분 | 5분 |
|---|---|---|---|
| 2023~2026 틱 | 0.667 (18, p = 0.24) | 0.667 (24, p = 0.15) | 0.577 (26, p = 0.56) |
| 2020~2022 분봉 | — | 0.529 (17, p = 1.00) | — |
| 전체 | — | 0.610 (41, p = 0.21) | — |
H74(기대 톤 ↔ 실제 톤 ρ > 0.5)는 지지, H75(2023~ 1분 > 0.5, p < 0.10)는 방향은 맞지만 판정 불가(p = 0.15), H76(2020~22 도 > 0.5 이고 같은 방향)은 0.529 로 미지지다. 서프라이즈 크기와 틱 반응의 순위상관은 6개(3선과 10선 × 30초, 1분, 5분) 모두 음(−0.07~−0.24, 매파일수록 하락)이지만 어느 것도 유의하지 않다. 다만 같은 회의에서 «직전 대비 변화» 규칙이 0.767 → 0.353 으로 뒤집힌 것과 달리, 이 규칙은 두 구간 모두 0.5 위였다.
금리 결정 자체의 서프라이즈(설문 기대 대비 실제 변동 bp)는 결정 속보 뒤 1분 반응과 3선 ρ = −0.607(p = 0.021, 14회)로 이어지지만, 10:30 통방문 공개 반응과는 이어지지 않는다(3선 −0.02, 10선 −0.26). 결정은 속보 때 이미 가격에 들어간다.
반응 속도와 지연 비용
한계
이 결론이 뒤집힐 수 있는 조건.
- 표본이 작다. v5 시험 47문항의 정확도 표준오차는 약 7%p 다. 0.57 미만의 차이는 모두 우연 범위다.
- 2012~2019 레이블이 약하다. 공개 시각이 기사 게재 시각 −2분의 추정이고, 그 시절엔 공개 직후 거래량 급증도 보이지 않는다.
- 바뀐 문장 목록이 뉘앙스를 못 잰다(자료 절). LLM «변화» 점수도 그 목록만 읽었다.
- LLM 점수에 사후 지식이 섞였을 수 있다. 회의일 이후 지식을 쓰지 말라고 지시했을 뿐 막지는 못했다.
- 밀리초 분석은 두 회의뿐이고 수집이 체결의 절반만 잡는다.
- 비용(수수료, 호가 충격)은 넣지 않았다. 방향 적중률만 쟀다.
다음 단계와 산출물
- 기대 톤 서프라이즈를 연속값으로. 기대 톤을 여러 번 매긴 평균이나 증류 Laya 의 확률 기대값으로 만들어 0 동점을 없앤다.
- 문장 단위 서프라이즈. 프리뷰가 예상하지 못한 포워드 가이던스 문구만 따로 짚는다(바뀐 문장 목록도 뜻 기준으로 다시 만든다).
- 표본을 늘린다. 2012~2019 프리뷰를 기사로 복원하면 기대 톤 표본이 약 두 배가 된다.
- 분석과 판정
analysis.md - 사전등록
protocol.md(v1, v3, v5, v6 개정) - 데이터셋 설명서
DATASET.md - 정본 런
results/20260930_kaggle_v5/,results/20260930_kaggle_v5c/,results/v5_local.json,results/v6_expected_tone.json - 레이블
results/statement_labels_v5.csv,results/tick_labels.csv - 요소 점수
results/llm_factor_labels.json,results/expected_tone.json