Laya 와 Jev 두 결정 모델을 비교했다. 금리 결정 발표와 통방문 공개 뒤 선물과 현물이 강세로 갈지 약세로 갈지를, 회사 PC 의 오픈소스 모델(Laya)과 API 모델(Jev)에
똑같이 물었다. 어느 쪽도 방향을 맞히지 못했고, 통방문 톤을 읽는 능력만 Jev 에서 뚜렷했다.
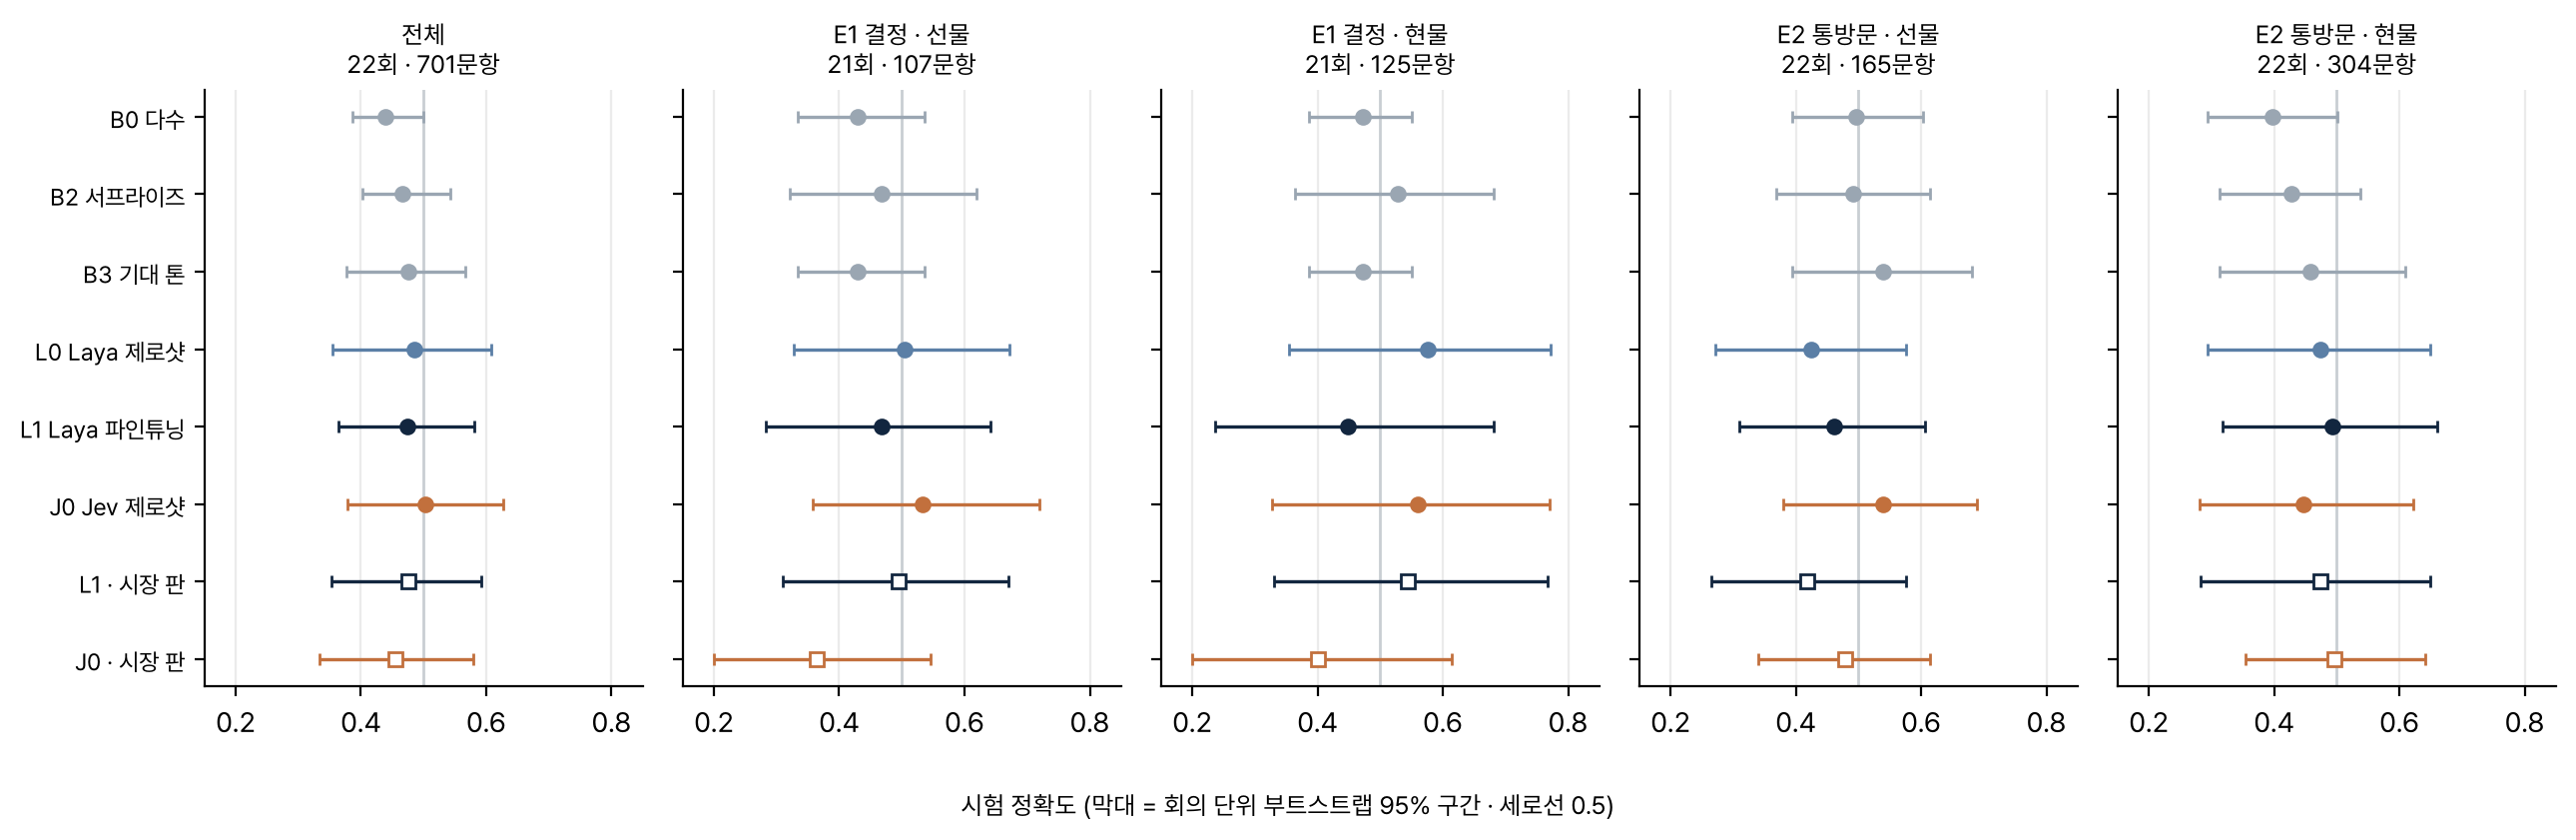
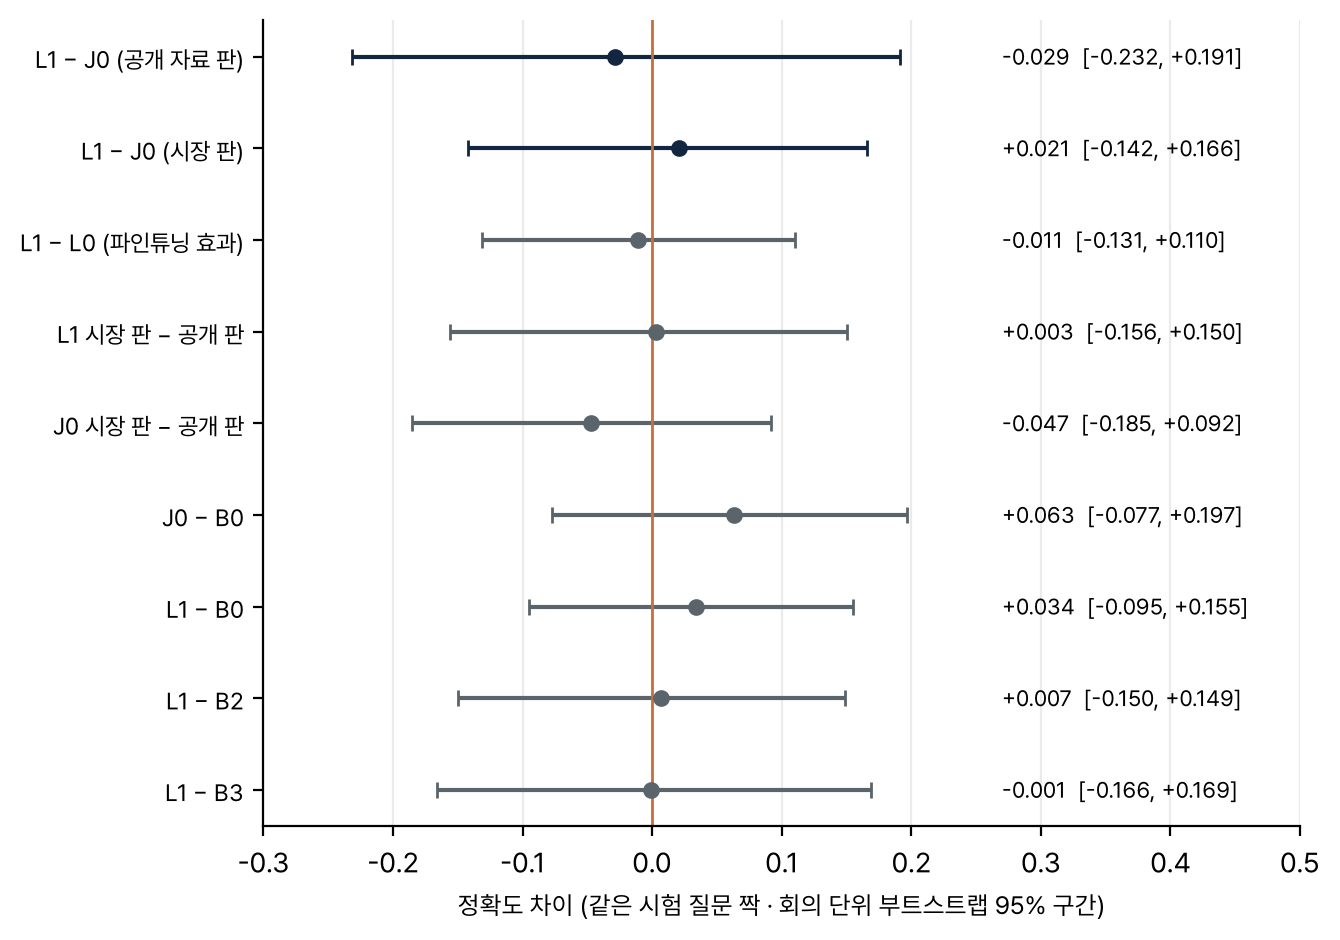
시험 22회의(2024-01~2026-08) 701문항에서 Laya 제로샷 0.485, Laya 파인튜닝 0.474, Jev 제로샷 0.502 로, 학습 구간 다수 방향(0.439)과의 차이가 회의 단위 부트스트랩으로 어느 것도 유의하지 않다. 주 비교 Laya 파인튜닝 − Jev = −2.9%p(95% −23~+19%p).
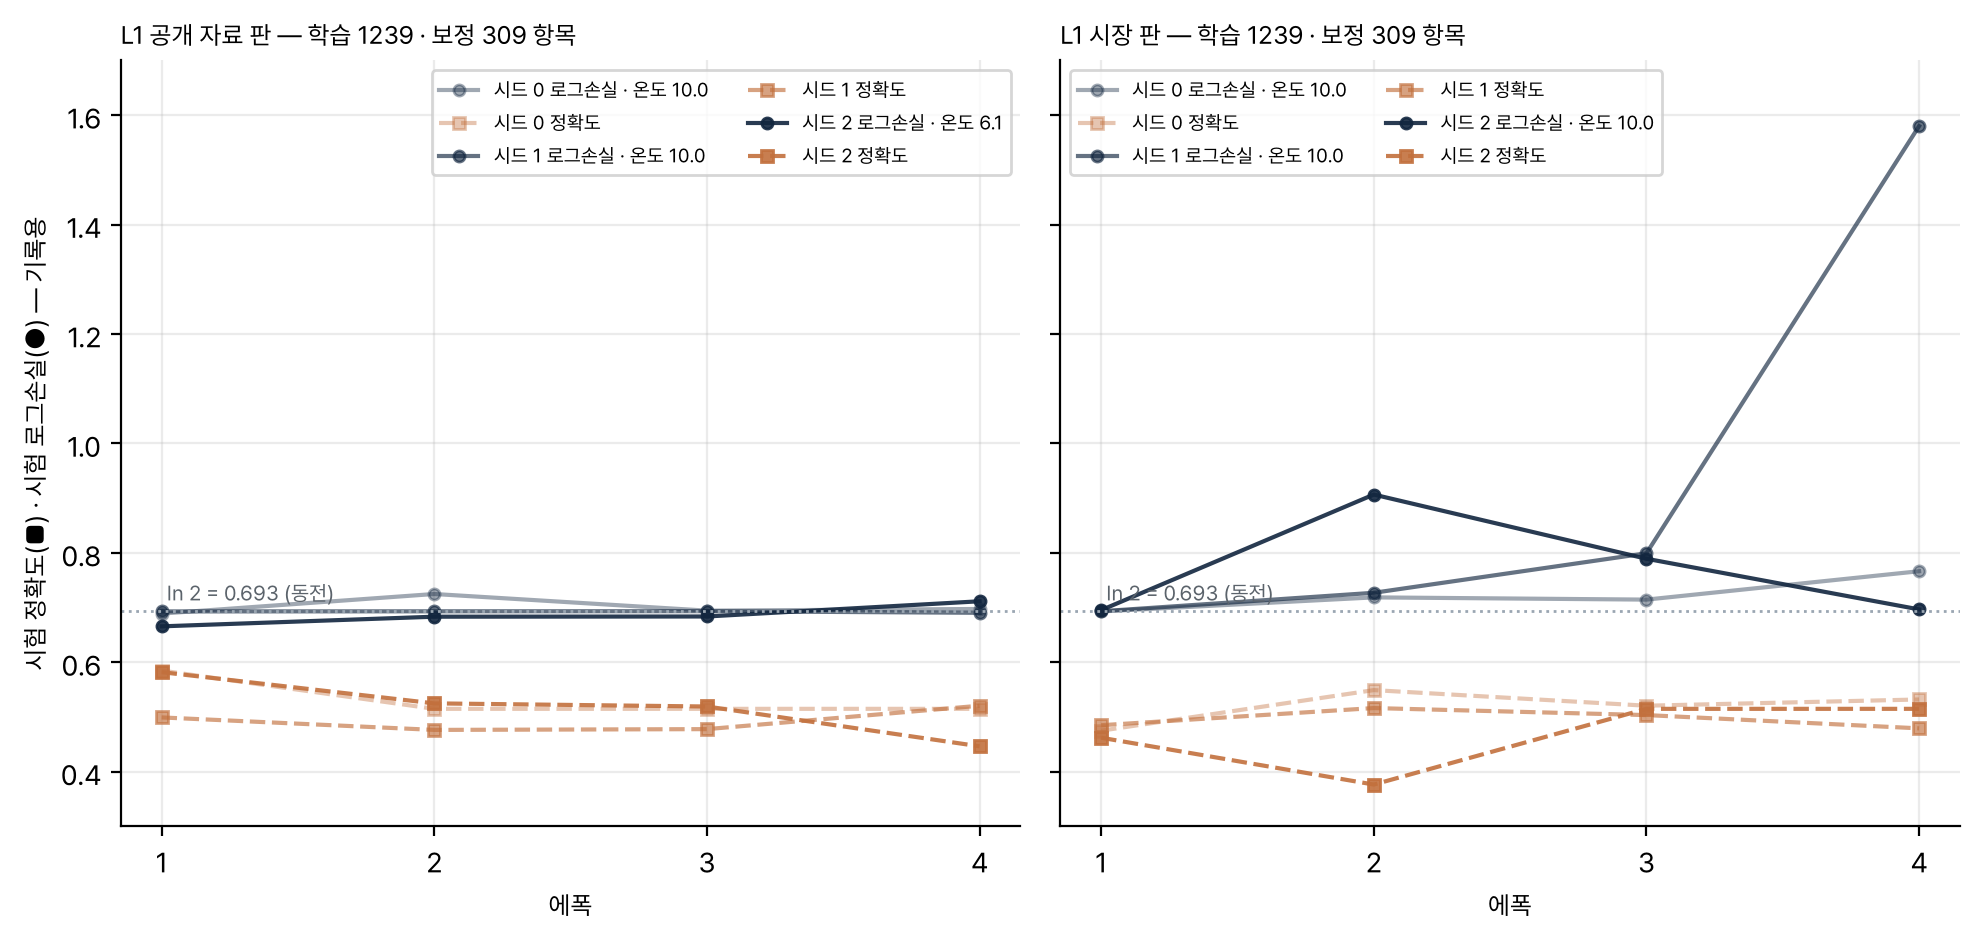
결정 전과 통방문 전 시장 움직임을 입력에 넣어도 같다(Laya +0.3%p, Jev −4.7%p). 파인튜닝 모델의 시험 로그손실은 에폭 내내 동전 수준(0.69)이었다.
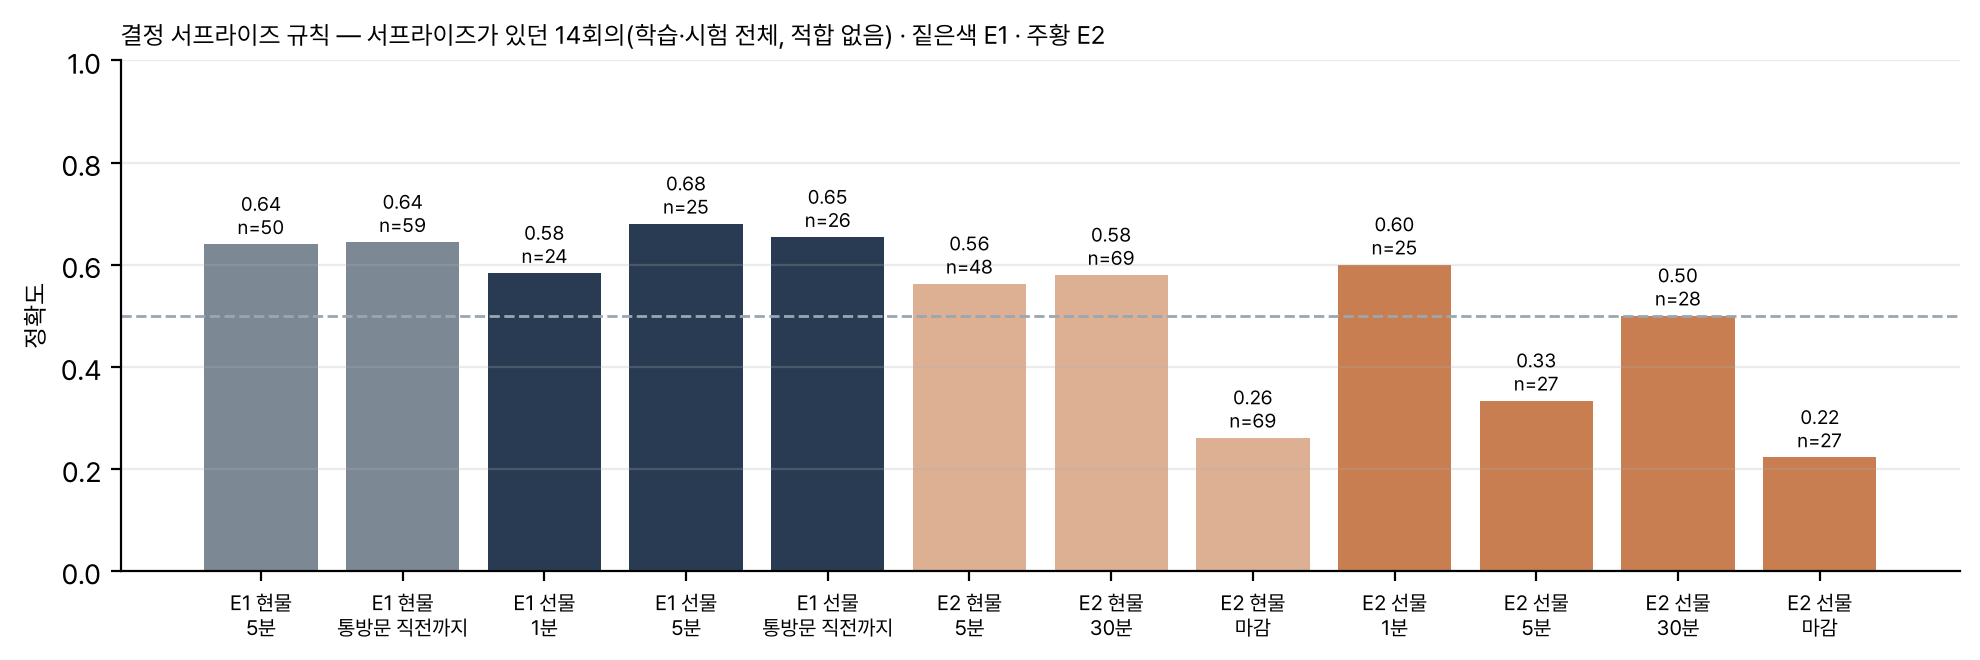
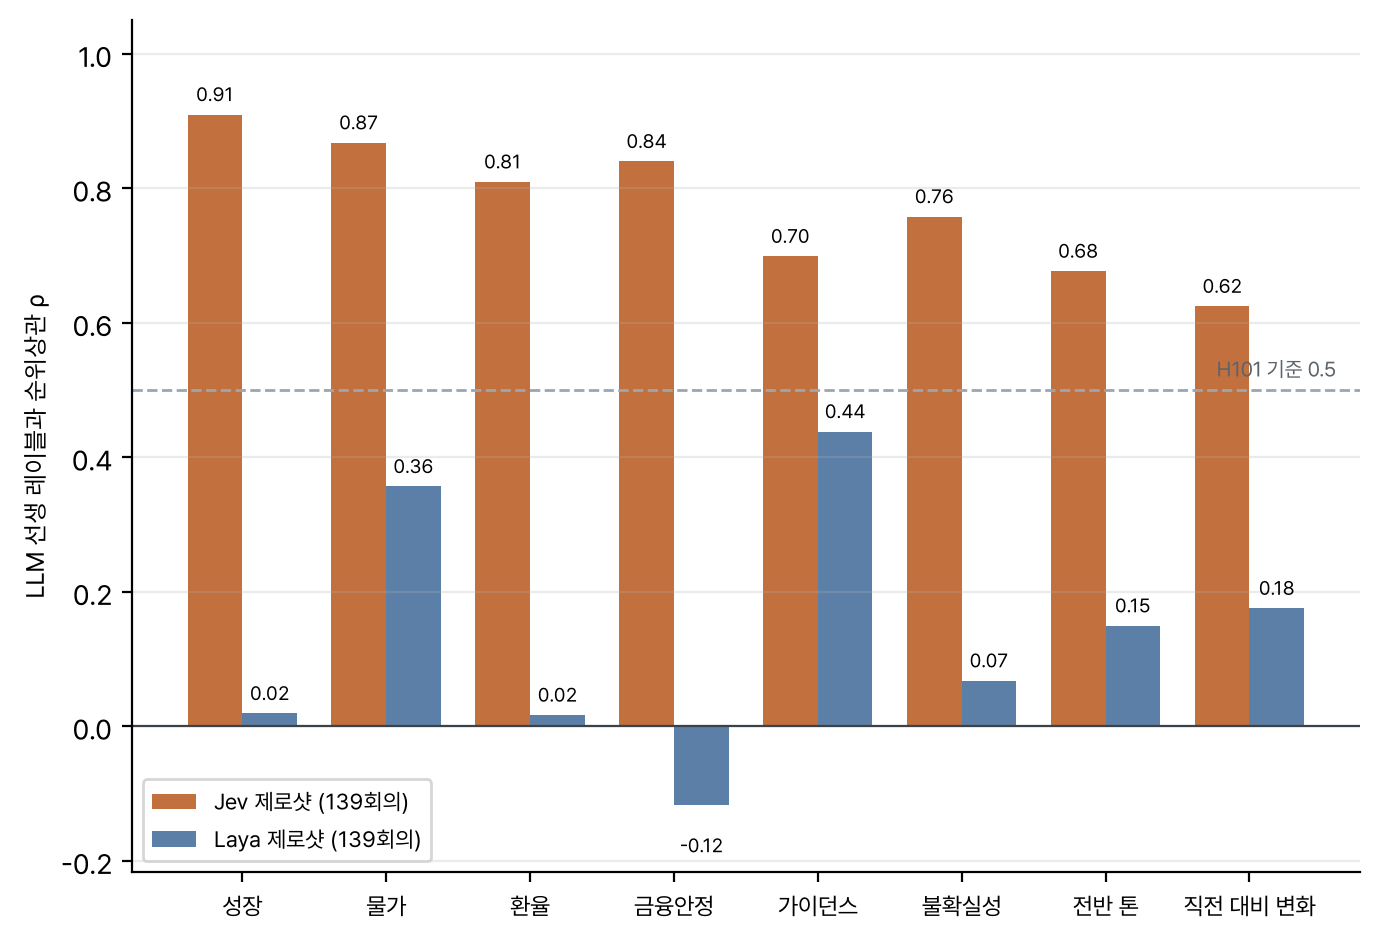
분명한 결과는 둘이다. Jev 는 통방문 톤을 잘 읽고(LLM 선생 레이블과 순위상관 0.62~0.91), 결정 서프라이즈의 반응은 당일 안에 되돌려진다(결정 직후 방향 0.58~0.68, 그날 마감 방향은 거꾸로 0.22~0.26).
가설과 결론
물음
금통위 당일 두 사건(기준금리 결정 발표 E1 과 통방문 공개 E2) 뒤에 3년, 10년 국채선물과 국고채 지표물 금리가 강세로 가는지
약세로 가는지를, 그 시각까지 알 수 있는 정보만으로 결정 모델이 맞힐 수 있는가. 같은 질문을 온프렘 오픈소스(Laya)와 API(Jev)에 똑같이 던지면 어느 쪽이 나은가.
결론
둘 다 맞히지 못한다. 둘의 차이도 없다. 통방문 «읽기»(톤과 요소 판단)는 Jev 가 잘 하지만, 그 읽기가 시장 방향으로 이어지지 않는다.
표 1. 가설과 판정 — 수치는 results/eval.json·analysis.md
번호
가설
판정
근거
H97
결정 서프라이즈 규칙(B2)이 E1 방향을 0.5 보다 잘 맞힌다(양성 대조)
부분 통과
서프라이즈 14회의에서 E1 0.58~0.68. 시험 22회의에는 서프라이즈가 6회뿐
H98
Jev 제로샷이 E2 선물 1분 방향에서 B0 보다 높다
기각
J0 0.525 대 B0 0.325(40문항) — J0 자체가 우연 수준(p 0.87)
H99
Laya 파인튜닝(L1)이 Jev 제로샷(J0)보다 높다 — 주 비교
기각
−0.029, 95% −0.232~+0.191
H100
공개 뒤 첫 1분 선물 방향을 현물이 뒤따른다(과제 C)
기각
국고 3·10·30년 0.39~0.63, 모두 p > 0.35
H101
모델의 통방문 요소 읽기가 LLM 선생과 순위상관 0.5 이상
Jev 통과 · Laya 미달
Jev 0.62~0.91 · Laya 제로샷 −0.12~0.44
H102
Jev API 왕복이 Laya CPU 보다 빠르다
통과
Jev 0.24초 · Laya 통방문 사례 84초
용어와 기호
표 2. 이 리포트의 용어
통방문
금통위가 회의 뒤 내는 «통화정책방향» 결정문. 기준금리 결정과 경제 판단·향후 정책 방향을 담는다.
E1 · Td
기준금리 결정 발표와 그 시각. 결정 속보 첫 게재 분을 3선 거래량 급증으로 정련했다(2020 년 이후 09:50 안팎).
E2 · Ts
통방문 공개와 그 시각. 2020 년 이후 10:30 정시, 그 전은 인용 기사 시각으로 복원(10:40~11:05).
3선 · 10선
3년·10년 국채선물. 1틱 = 0.01. 가격이 오르면 금리가 내린 것이다.
국고N년
국고채 N년 지표물(가장 최근 발행된 대표 종목) 금리. 거래소 장내 체결만 쓴다. bp = 0.01%p.
강세 · 약세
강세 = 선물 가격 상승 = 현물 금리 하락. 선물과 현물의 방향을 같은 낱말로 맞췄다.
시계
사건 직전 가격에서 얼마 뒤까지의 변화인가. 1m·5m·30m = 1·5·30분, to_s = 결정 뒤 통방문 공개 직전까지, close = 그날 장 마감까지.
가족
(사건, 계열[, 시계]) 묶음. 예: «E1 · 현물».
state
결정 모델이 읽는 입력(JSON 사전). 키 순서대로 이어 붙여 읽는다.
choice
선택지 중 하나를 고르는 질문 유형. 이 실험의 모든 방향 질문은 «강세/약세» 2지선다 choice 다.
score
순서 있는 수준(0~4) 중 하나를 매기는 질문 유형. 요소 읽기에 쓴다. 답은 기대 수준(Σ 수준 × 확률).
Laya
오픈소스 결정 모델 convaiinnovations/laya-multilingual. 글을 생성하지 않고 state 를 읽어 질문마다 선택지 확률을 낸다. 회사 PC 에서 돈다.
Jev
TypeSafe 의 결정 모델(API). 같은 state·질문 형식을 받고 선택지 확률을 돌려준다. 가중치에 접근할 수 없어 학습은 못 하고 보정만 한다.
LLM 선생 레이블
LLM 이 통방문마다 요소 8개를 0~4 로 매겨 둔 점수. 요소 읽기(H101)의 정답으로 쓴다.
Platt 보정
학습 구간 예측으로 P = σ(a·logit(p) + b) 를 적합해 확률을 고치는 방법. a·b 두 숫자만 배운다.
부트스트랩 구간
시험 회의 22개를 복원 추출로 2,000번 다시 뽑아 잰 정확도(차이)의 2.5~97.5 백분위. 같은 회의의 질문을 한 덩어리로 뽑는다.
McNemar
같은 질문 짝에서 한쪽만 맞힌 수를 견주는 정확 검정. 질문을 독립으로 세므로 이 실험에서는 p 가 작게 나온다 — 판정은 부트스트랩으로 한다.
자료와 레이블
표 3. 자료
계열
원천
기간 · 회의
해상도 · 가격 정의
선물 3선·10선
연결 1분봉(자체 표 → 벤더 표 → 다른 부서 보관분으로 빈 날 메움 — 겹치는 값 100% 일치)
2012-01~2026-08 · 139회의
1분. 스탬프는 봉의 끝 — P(t) = t 직전 체결가
현물 지표물 6개
지표물 1분 격자(체결량 0 인 행은 이월값)
2022-01~2026-08 · 38회의
1분. y(t) = t 이하 체결량 > 0 인 마지막 수익률. 스탬프가 봉의 끝인지 장내 체결과 대조했다: 400분 중 392분 일치(봉의 시작으로 보면 141)
결정 · 설문
금통위 결정 원장 · 채권 전문가 설문 기사(다수 예상과 비율)
설문 2020-08~ · 44회의
설문 대비 실제 결정 = 서프라이즈(±)
통방문 · 기대 톤
통방문 본문 PDF(띄어쓰기 보정) · 프리뷰 기사로 LLM 이 추정한 기대 톤
본문 162건 · 기대 톤 2020~ 54회의
직전 통방문 대비 새로 생긴/사라진 문장(최대 6개씩)
레이블: 질문 하나 = (회의, 사건, 계약, 시계). 기준가는 E1 은 P(Td − 1분)(속보 분이 늦어도 반응이 기준가에 안 들게), E2 는 P(Ts).
선물 |Δ| < 1틱, 현물 |Δy| < 0.5bp 는 질문을 만들지 않았고(553건), 시계 안에 실제 체결이 없는 현물 질문도 만들지 않았다(57건).
E1 앵커는 2013~2019 웹 복원분까지 넓혔고 정련 뒤 10:20 을 넘는 3개(결정 기사가 아닌 것을 잡은 것으로 봄)를 뺐다. 그래서 E1 은 103회의다.
검증: E1 앵커는 2020 년 이후 52회에서 앞선 앵커 표와 52/52 같고, E2 10선 1분 부호는 초 단위 틱으로 잰 앞선 레이블과 109/109 같다.
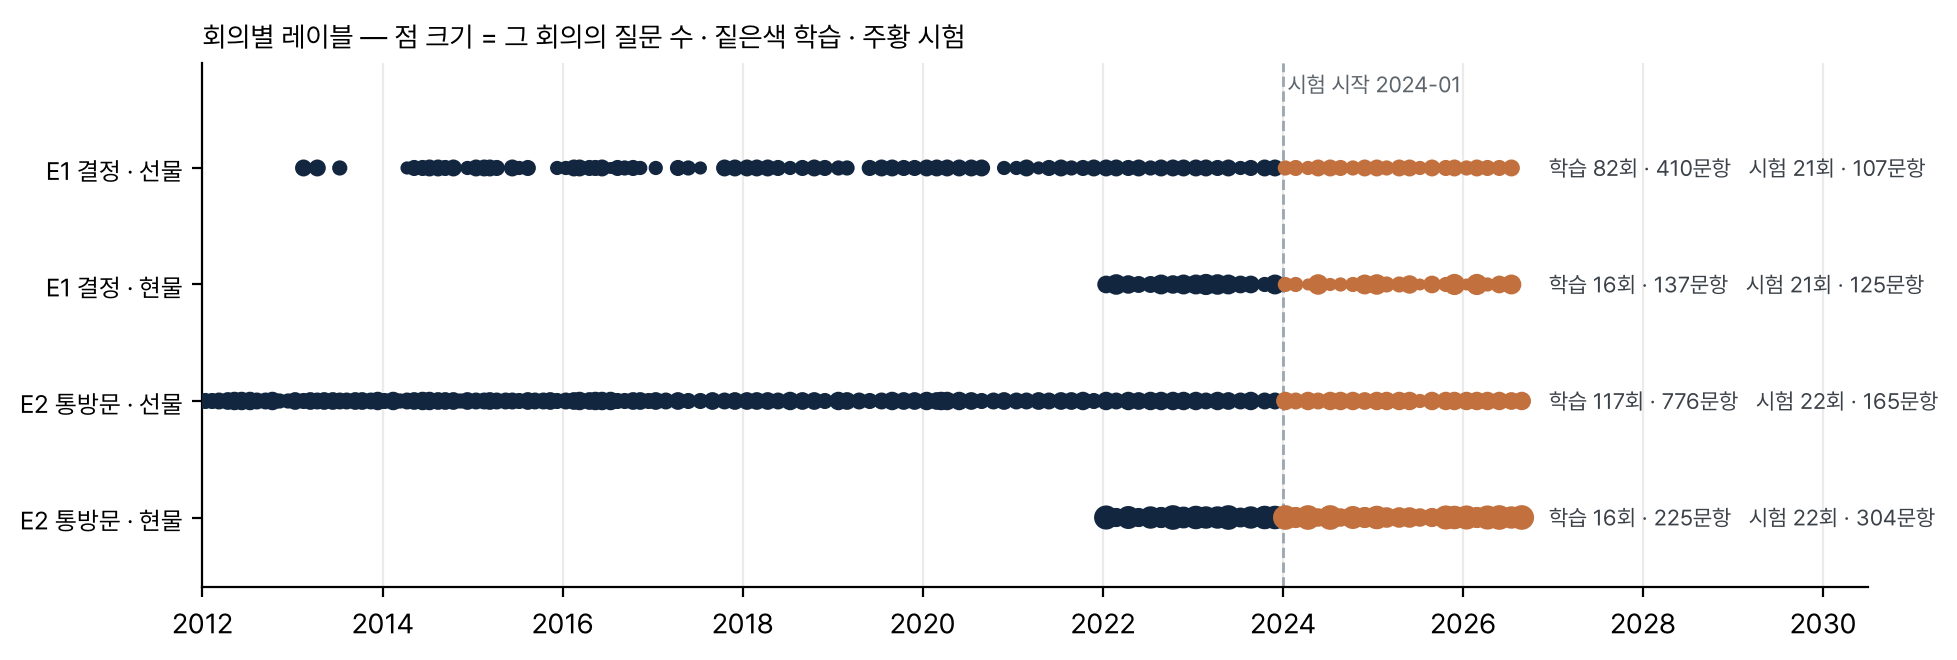
그림 1. 회의별 레이블. 짙은 점이 학습(≤2023), 주황 점이 시험(2024~)이고 점 크기가 그 회의의 질문 수다. 현물은 2022 년부터만 있다.
회의 하나의 모든 질문은 한쪽에만 있다.
입력과 분할
표 4. state 항목 — 위에서부터 순서대로(Laya 는 4,096 토큰을 넘으면 뒤에서 자르므로 순서가 우선순위다). 숫자는 낱말로 준다 — Jev 는 산술을 못 한다.
항목
E1
E2
판
예 (2024-10-11)
기준금리 결정 · 직전 대비
○
○
둘 다
인하 — 새 기준금리 3.25% (직전보다 25bp 인하)
설문 예상 · 예상 대비 결정
○
○
둘 다
응답자 약 64%가 인하 예상 · 예상보다 완화적(비둘기 서프라이즈)
결정 발표 전 30분 국채선물
○
○
시장
3년 상승(2틱 이상) · 10년 상승(2틱 이상)
결정 뒤 ~ 통방문 직전 국채선물
—
○
시장
3년 변동 없음 · 10년 하락(2틱 이상)
결정 뒤 ~ 통방문 직전 국고 3·10년
—
○
시장
3년 금리 상승(1bp 미만) · 10년 거의 변동 없음
시장의 사전 기대(프리뷰 기사)
—
○
둘 다
예상 결정 인하 · 기대 전반 톤 중립 · 기대 포워드 가이던스 중립
직전 대비 새로 생긴·사라진 문장, 통방문 본문
—
○
둘 다
(본문 약 2,000~3,000자)
두 판: 공개 자료 판은 위 표의 «둘 다» 항목만, 시장 판은 그 사건 전에 관측된 움직임 문장 세 줄을 더한다. 움직임은 방향과 한 단계 크기만 적는다.
회의일은 넣지 않았다. 날짜로 회의를 외우거나 사전학습 기억으로 그날 시장을 떠올리는 길을 막는다.
Laya 와 Jev 는 같은 판에서 글자 하나 다르지 않은 state 와 질문을 받는다.
표 5. 분할 — 회의 단위 시간순 하나. 계열마다 나누면 같은 회의(같은 state)의 질문 사이로 정답이 샌다.
구간
회의
사례(회의 × 사건)
질문 E1 선물·현물
질문 E2 선물·현물
학습 ≤ 2023-12-31
117
199
410 · 137
776 · 225
시험 2024-01-01~
22
43
107 · 125
165 · 304
모델
표 6. 모델과 세팅 전부
기호
모델
무엇을 학습하나
세팅
왜 넣었나
B0~B3
규칙 기준선(표 M3)
B0 만 학습 구간 다수 방향
—
바닥 · 경제적 직관 · 앞서 유일하게 부호가 안 뒤집힌 규칙
L0
Laya 제로샷
없음
max_len 4,096 · 질문 머리 256 · 온도 기본값 · Kaggle T4(fp16) / 이 PC CPU 12스레드(fp32)
Jev 와 같은 조건(학습 없음) 비교
L0c
L0 + Platt
a, b
학습 구간 L0 예측 1,548문항
J0c 와 같은 조건
L1
Laya 파인튜닝
인코더·결정 헤드 전부
선물·현물·두 사건 한 모델 · 학습 1,239 · 보정 309 항목(시간순 끝 20%) · 4에폭 · 미니배치 2 · 학습률 인코더 2e-5 / 헤드 1e-4 · 코사인 · AdamW(가중치 감쇠 0.01) · 손실 = 소프트 교차엔트로피 + 정책경사(잡음 σ 0.4→0.1, 묶음 4) · fp16 · T4×2 DDP · 시드 0·1·2 확률 평균 · 마지막 에폭 저장(시험으로 고르지 않음) · 보정 온도는 보정 항목으로 적합
온프렘 모델이 학습으로 얼마나 오르나
J0
Jev 제로샷
없음(불가)
jev-latest(응답 jev-1.13.0) · 사례당 한 호출에 질문 전부
API 모델의 기본 능력
J0c
J0 + Platt
a, b
학습 구간 J0 예측 1,548문항
학습 없이 보정만으로 나아지나
_m
같은 모델의 시장 판
L0_m · L1_m · J0_m — 세팅은 위와 같고 state 만 다르다
시장 정보가 도움이 되나
Laya-multilingual — L0·L1 이 공유하는 결정 모델
그림 M1. 사전학습 체크포인트(L0)에서 읽었다. 이 체크포인트로 커밋된 CPU 시험 예측 46문항(E1 사례 5개)을 다시 냈더니 강세 확률 차이 최대 0.0e+00 — 그림의 텐서가 L0 런의 모델이다. L1 은 같은 구조를 학습 1,239 항목으로 4에폭 미세조정한 것이고, 체크포인트는 Kaggle 노트북이 끝에서 지워 남아 있지 않다(학습 기록은 그림 5).
표 M1. Laya 파라미터 텐서 — 반복 층은 한 층의 텐서(모양)와 층 수. 원소 수는 층 전체 합이다.
#
부분
텐서(한 층)
모양
층 수
원소 수(전체)
1
encoder.embeddings
tok_embeddings.weight
[256000, 768]
1
196,608,768
norm.weight
[768]
2
encoder.layers[0..21]
attn_norm.weight
[768]
22
110,330,112
attn.Wqkv.weight
[2304, 768]
attn.Wo.weight
[768, 768]
mlp_norm.weight
[768]
mlp.Wi.weight
[2304, 768]
mlp.Wo.weight
[768, 1152]
3
encoder.final_norm
weight
[768]
1
768
4
type_emb
weight
[3, 768]
1
2,304
5
head.layers[0..1]
self_attn.in_proj_weight
[2304, 768]
2
14,175,744
self_attn.in_proj_bias
[2304]
self_attn.out_proj.weight
[768, 768]
self_attn.out_proj.bias
[768]
linear1.weight
[3072, 768]
linear1.bias
[3072]
linear2.weight
[768, 3072]
linear2.bias
[768]
norm1.weight
[768]
norm1.bias
[768]
norm2.weight
[768]
norm2.bias
[768]
6
scorer
0.weight
[768]
1
592,897
0.bias
[768]
1.weight
[768, 768]
1.bias
[768]
3.weight
[1, 768]
3.bias
[1]
7
act_head
0.weight
[256, 772]
1
198,402
0.bias
[256]
2.weight
[2, 256]
2.bias
[2]
그림 M2. 질문 하나가 입력이 되는 방식. Laya 는 질문마다 이 열 전체를 다시 읽는다 — 통방문 사례(질문 약 20개)가 CPU 에서 84초 걸리는 까닭이다. 시장 판은 상태 안 3~5번 줄(움직임 문장)만 공개 판과 다르다.
Platt 보정 — L0c · J0c
표 M2. Platt 보정 — 학습 구간 예측으로 적합한 P(강세) = σ(a·logit(p) + b). a 가 0 에 가까우면 원래 확률이 방향과 무관하다는 뜻이고, 그때 출력은 σ(b) 하나로 모인다.
보정판
학습 문항
기울기 a
절편 b
σ(b)
L0c
1,548
+0.098
+0.006
0.501
L0c · 시장 판
1,548
-0.093
-0.116
0.471
J0c
1,548
+0.011
-0.060
0.485
J0c · 시장 판
1,548
+0.008
-0.055
0.486
Jev — API 결정 모델
그림 M3. Jev 는 가중치를 볼 수 없는 API 모델이다. 그래서 구조 대신 실제 호출 기록에서 입출력과 세팅을 읽었다. 같은 입력을 두 번 보내면 강세 확률이 최대 0.16(공개 판)·0.33(시장 판) 달랐다.
기준선 B0~B3 — 규칙
표 M3. 기준선은 적합하는 모델이 아니라 규칙이다 — 학습 구간을 쓰는 것은 B0(가족별 다수 방향)뿐이다.
기호
규칙
판단이 없을 때
B0
학습 구간에서 (사건, 계열, 시계)별 다수 방향
—
B1
인하 → 강세 · 인상 → 약세
동결이면 B0
B2
설문보다 매파 결정 → 약세 · 비둘기 결정 → 강세
설문과 같거나 설문 없음이면 B0
B3
(E2) s = ½[(실제 전반 톤 − 기대) + (실제 가이던스 − 기대)], s > 0 → 약세 · s < 0 → 강세
s = 0 이거나 자료 없음이면 B0
결과 1 · 방향 예측
표 7. 시험 정확도(22회의 · 701문항) — results/eval.json families
가족
문항
B0
B2
B3
L0
L1
J0
L0_m
L1_m
J0_m
전체
701
0.439
0.466
0.475
0.485
0.474
0.502
0.459
0.476
0.455
E1 선물
107
0.430
0.467
0.430
0.505
0.467
0.533
0.318
0.495
0.364
E1 현물
125
0.472
0.528
0.472
0.576
0.448
0.560
0.592
0.544
0.400
E2 선물
165
0.497
0.491
0.539
0.424
0.461
0.539
0.358
0.418
0.479
E2 현물
304
0.398
0.428
0.457
0.474
0.493
0.447
0.510
0.474
0.497
그림 2. 가족별 시험 정확도와 회의 단위 부트스트랩 95% 구간. 모든 막대가 0.5 를 가로지른다. 빈 네모가 시장 판이다.
B0 가 0.5 아래인 것은 학습 구간의 다수 방향(대부분 약세)이 시험 구간(2024~ 인하기)에 뒤집혔기 때문이다.그림 3. 같은 질문 짝의 정확도 차이. 어느 비교도 구간이 0 을 벗어나지 않는다. 주 비교(위 두 줄)는 구간 폭이 ±20%p 안팎이다.
이 표본으로는 «큰 차이가 없다» 까지만 말할 수 있다. McNemar p 는 J0 − B0 0.019, L1_m − L1(E1 현물) 0.0005 처럼 작게 나오는 곳이 있으나,
같은 회의의 질문을 독립으로 센 값이라 판정에 쓰지 않는다.
결과 2 · 확률과 학습
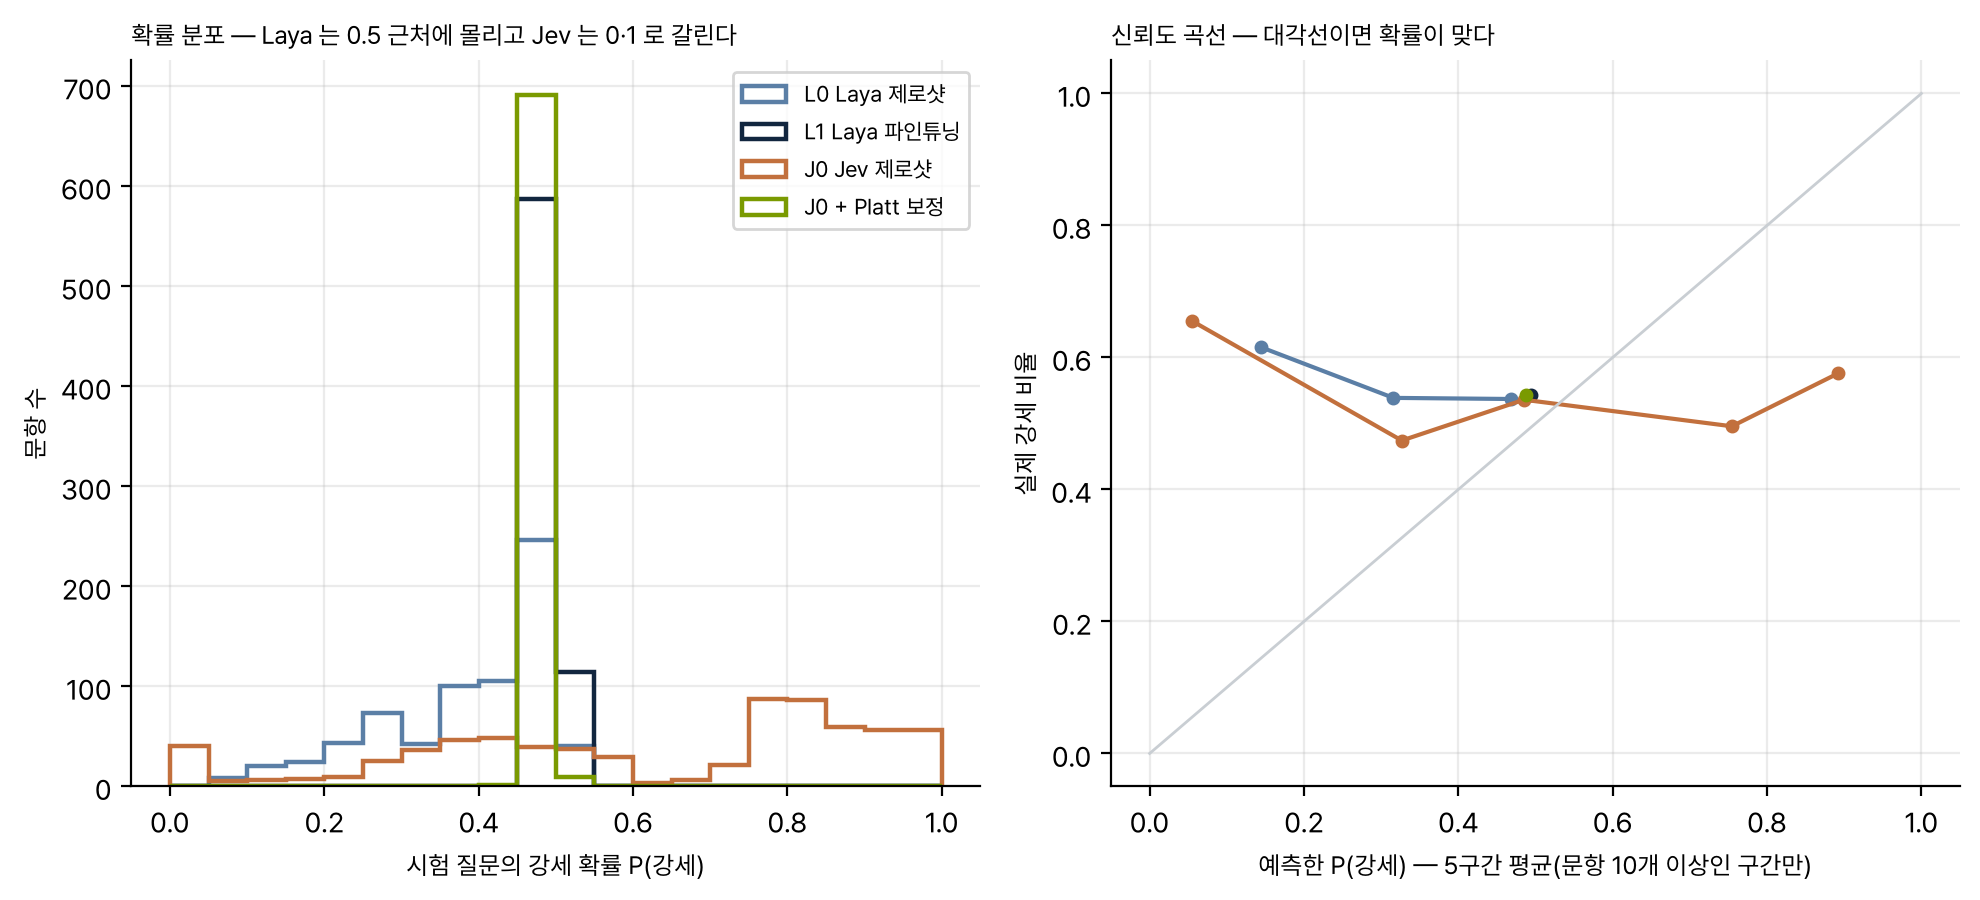
그림 4. 시험 질문의 강세 확률. Laya(L0, L1)는 0.5 근처에 몰려 있고 L0 은 97% 를 약세로 답했다. Jev 는 0 과 1 쪽으로 강하게 갈리지만(강세 63%)
신뢰도 곡선이 평평하다. 0.9 를 낸 질문의 실제 강세 비율이 0.6 안팎이다. 학습 구간으로 Platt 보정을 하면 기울기 a 가 0 에 가깝게 나와(표 M2)
출력이 한 값으로 모인다. Brier 0.331 → 0.251, ECE 0.26 → 0.04 로 «확률로서는» 나아지지만 방향 정보가 없다는 뜻이다.
같은 입력을 두 번 보내면 Jev 의 강세 확률은 최대 0.16(공개 판), 0.33(시장 판) 달랐다.그림 5. L1 의 에폭별 시험 정확도와 로그손실(기록만 했고 에폭 선택에 쓰지 않았다). 로그손실은 첫 에폭부터 ln 2 = 0.693(동전)에 붙어 있고
시장 판 시드 1 은 4에폭에 1.58 로 과적합했다. 학습 구간 끝 20% 로 적합한 보정 온도가 6개 중 5개에서 상한 10.0 이다.
학습 구간 안에서도 확신을 낼 근거를 찾지 못했다. 시드별 시험 정확도는 0.447~0.532 로 흩어진다.
결과 3 · 서프라이즈와 톤 읽기
그림 6. 결정 서프라이즈 규칙(설문보다 매파 결정이면 약세)을 서프라이즈가 있던 14회의 전부(학습과 시험, 적합 없음)에 적용했다.
E1(결정 직후)은 0.58~0.68 로 맞는 쪽이다. 같은 규칙이 E2 마감은 선물 0.22, 현물 0.26 으로 거꾸로 맞힌다. 결정 서프라이즈의 반응이
통방문 공개 뒤 장 마감까지 되돌려진다. 회의가 14개뿐이라 질문 단위 p 값은 쓰지 않는다.그림 7. 통방문 요소 8개를 score 질문으로 읽혀 LLM 선생 레이블과 견준 순위상관(139회의). Jev 는 여덟 개 모두 0.5 를 넘는다(0.62~0.91).
같은 질문의 Laya 제로샷은 −0.12~0.44 로 읽지 못한다. Jev 가 통방문을 «읽는» 데도 방향을 못 맞힌다는 것은 문제의 어려움이 읽기가 아니라
«읽은 톤 → 그날 가격» 사이에 있다는 뜻이다.
과제 C(공개 뒤 첫 1분 10선 방향 → 국고 3년, 10년, 30년의 T+1분~T+h 방향): 9개 가족 0.39~0.63, 모두 p > 0.35 다. 현물이 선물의 첫 움직임을 뒤따르지 않는다.
지연과 비용
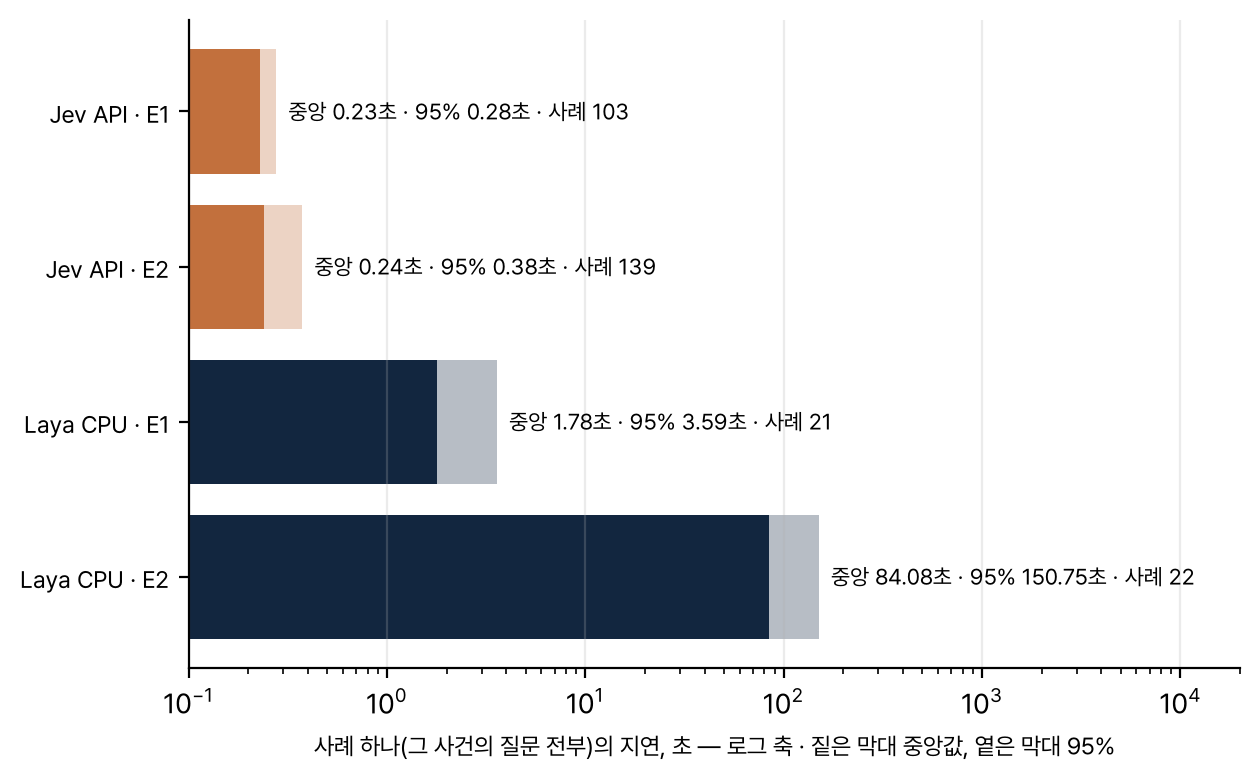
그림 8. 사례 하나(그 사건의 질문 전부)의 지연. Jev API 는 중앙 0.23~0.24초(질문을 묶어도 거의 같다). Laya 는 이 PC CPU 에서 결정 사례 1.8초,
통방문 사례(질문 약 20개) 84초다. 질문마다 본문 전체를 다시 읽는다. 질문 하나만 물으면 약 4초다.
Jev 비용입력 토큰 74만(공개 판) + 76만(시장 판), 약 $0.06(100만 토큰당 $0.042, 출력 무료)
Jev 호출당 입력E2 중앙 2,709, 최대 6,598 토큰(한도 32,000). 질문을 묶어도 state 를 질문마다 다시 세지 않는다
LayaKaggle T4×2 판당 1회(제로샷 + 시드 3개 파인튜닝), 이 PC CPU 제로샷 판당 약 35분
한계
시험은 22회의다. 같은 회의의 질문은 서로 강하게 얽혀 실효 표본이 회의 수에 가깝고, 최소 검출 차이가 15~20%p 다.
«조금 낫다» 는 판정할 수 없다. 시장 문장은 방향과 한 단계 크기만 주었다. 2013~2019 의 결정 시각은 웹 기사 시각으로 복원한 값이다(대조 구간 +3~4분).
서프라이즈가 있는 회의가 적어(시험 6회) 서프라이즈를 아는 모델이 빛날 자리가 작다. Laya L1 체크포인트는 남기지 않아 구조 그림은 L0 에서 그렸다.