세 줄 요약
- 간담회 말의 톤은 다음 회의 결정과 함께 간다. 순위상관은 0.48(161회)이고, 통방문 톤을 통제해도 0.17(p 0.019)이 남는다(H196 지지).
- 표본 밖 시험에서 텍스트 모델은 다음 인상과 인하를 AUC 0.81, 0.82 로 가렸다. 음성과 표정을 더한 모델의 개선은 평균 +0.048 로 문턱 0.05 와 신뢰구간을 넘지 못했다(H200 미지지).
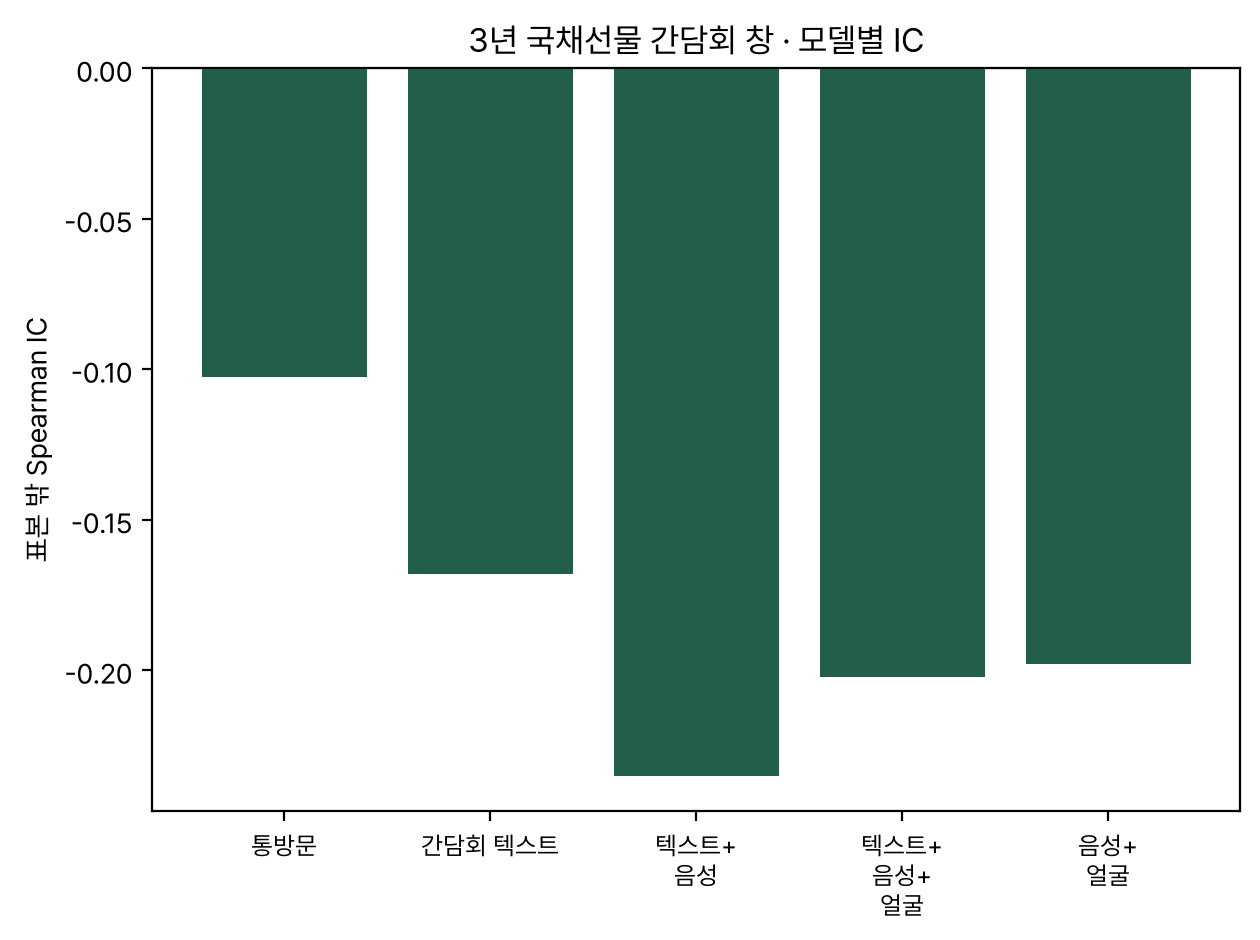
- 간담회 시간대(11:05 → 12:30) 3년 국채선물 방향은 어떤 모델도 맞히지 못했다(IC −0.10 ~ −0.24). 확증 가설 다섯 가운데 하나만 지지되어 판정은 보류다.
가설과 결론
- 질문
- 금통위 결정 뒤 총재 기자간담회의 말에서 읽은 톤이 다음 회의 결정과 그날 국채선물을 설명하는가. 총재의 목소리와 표정은 말을 통제한 뒤에도 더하는 정보가 있는가. 세 가지를 합친 모델이 말만 쓴 모델보다 나은가.
- 가설
- 계획서를 결과 전에 커밋했다(817db7e). 확증 가설은 다섯이다. H196: 간담회 톤과 다음 결정의 순위상관이 0.30 을 넘고(순열 p < 0.05), 통방문 톤을 통제한 부분상관도 0 보다 크다(p < 0.05). H197: 톤 서프라이즈가 매파적일수록 간담회 시간대 3선이 내린다(ρ < −0.20, 단측 p < 0.05). H198b: 음성을 더하면 3선 IC 가 오른다(ΔIC > 0, 짝 bootstrap 95% 구간이 0 위). H199b: 표정을 더해도 같은 개선이 있다. H200: 텍스트, 음성, 얼굴을 모두 쓴 모델이 텍스트 모델보다 다음 결정을 더 잘 가린다(인상과 인하의 평균 ΔAUC > 0.05, 구간이 0 위). 보조 가설은 셋이다. H198a: 질의응답 각성 평균과 반응 크기 |Y_press| 의 순위상관이 0.20 을 넘는다. H199a: 질의응답 부정 표정 비율과 Y_press 의 순위상관이 −0.20 보다 작다. H201: 음성과 얼굴만으로 텍스트 톤을 되맞힌다(표본 밖 ρ > 0.30).
- 결론
- H196 과 H201 은 지지, 나머지는 미지지라 판정은 보류다. 말의 톤은 다음 결정을 가르고 음성과 표정도 톤을 담고 있지만(H201), 말 위에 더하는 정보는 확인되지 않았다. 간담회 시간대 가격 방향은 설명되지 않았다.
용어와 기호
- 금통위
- 한국은행 금융통화위원회. 기준금리를 정하는 회의이고, 이 리포트에서 «회의» 는 금리 결정 회의 하나를 뜻한다.
- 통방문
- 통화정책방향 의결문. 결정 직후(10:30 안팎) 공개되는 글이다.
- 간담회
- 결정 뒤 총재 기자간담회. 11:10 안팎에 시작하고 2012 ~ 2019 년에는 11:20 ~ 11:30 에 시작했다. 모두발언과 질의응답으로 나뉜다.
- 모두발언, 질의응답
- 첫 기자 질문 전까지가 모두발언이고 그 뒤가 질의응답이다. 음성과 표정 특징은 둘을 따로 잰다.
- 3선, 10선
- 3년 국채선물과 10년 국채선물(연결 월물). 가격이 오르면 금리가 내린 것(강세)이다.
- 틱
- 국채선물 가격 0.01 포인트.
- Y_next
- 다음 회의의 기준금리 변동 방향. 인하는 −1, 동결은 0, 인상은 +1 이다.
- Y_press
- 간담회 시간대 국채선물 변화(틱). 11:05 와 12:30 분봉 종가의 차이다. 표에서는 «3선_press», «10선_press» 로 적는다.
- Y_close
- 11:05 에서 그날 마감까지의 변화(틱). 표에서는 «3선_close» 로 적는다.
- next_hike, next_cut
- 다음 회의가 인상인지(인상 대 나머지), 인하인지(인하 대 나머지)를 가리는 두 이진 표적.
- tone_overall
- 간담회 전체 톤. −2 는 강경 비둘기, +2 는 강경 매파다. Claude 에이전트가 간담회 전문만 보고 매기며 시장 가격과 다음 결정은 주지 않는다. 서로 모르는 두 번의 판독을 평균한다.
- 요소별 톤
- growth(성장), inflation(물가), finstab(가계부채, 주택, 금융안정), fx(환율과 대외), guidance(향후 금리 경로)는 각각 −2 ~ +2 이고 uncertainty(불확실성)는 0 ~ 2 다.
- qa_cut_push, qa_hike_push
- 질의응답에서 인하를, 또는 인상을 압박하는 질문의 수.
- 통방문 톤
- 통방문 글을 같은 방식으로 읽은 톤으로, 앞선 실험의 판독을 −2 ~ +2 로 옮겨 쓴다. 모델 M_stmt 의 유일한 입력이다.
- tone_surprise
- 톤 서프라이즈. 간담회 tone_overall 에서 통방문 톤을 뺀 값이고, 양이면 간담회가 글보다 매파적이었다.
- ASR
- 자동 음성 인식(받아쓰기). 공식 자막이 없는 2008 ~ 2016 년 간담회를 Whisper large-v3-turbo 로 받아쓴다.
- arousal, valence, dominance
- 각성(흥분 정도), 정서가(긍정과 부정), 지배성(자신감). 음성 감정 모델(wav2vec2, MSP-Dim 학습)이 4초 창마다 0 ~ 1 로 낸다.
- F0, jitter, shimmer, HNR
- 음높이(기본 주파수, 반음 단위), 음높이 떨림, 음량 떨림, 배음 대 잡음 비. Praat(parselmouth)로 잰 운율 특징이다.
- neg_share
- 부정 표정 비율. 표정 분류기(HSEmotion)가 초당 1 프레임마다 낸 8 감정 확률 가운데 anger, contempt, disgust, fear, sadness 를 더한 값이다.
- ECAPA
- 화자 임베딩 모델. 받아쓰기 연도에서 목소리 군집 가운데 발화 시간이 가장 긴 군집을 총재로 본다.
- ridge 회귀
- 계수 제곱합에 벌점 α 를 주는 선형 회귀. 연속 표적(틱)에 쓴다.
- 로지스틱 회귀
- 선형 점수를 σ(t) = 1 / (1 + e−t) 로 0 ~ 1 확률로 바꾸는 분류기. L2 벌점을 쓰고 역규제는 C = 1/α 다. 이진 표적에 쓴다.
- α
- 규제 강도. 클수록 계수를 더 세게 0 쪽으로 누른다. 후보 0.1, 1, 10, 100, 1000 가운데 학습창 안 5겹 교차검증으로 고른다.
- 확장창 걷기 전진
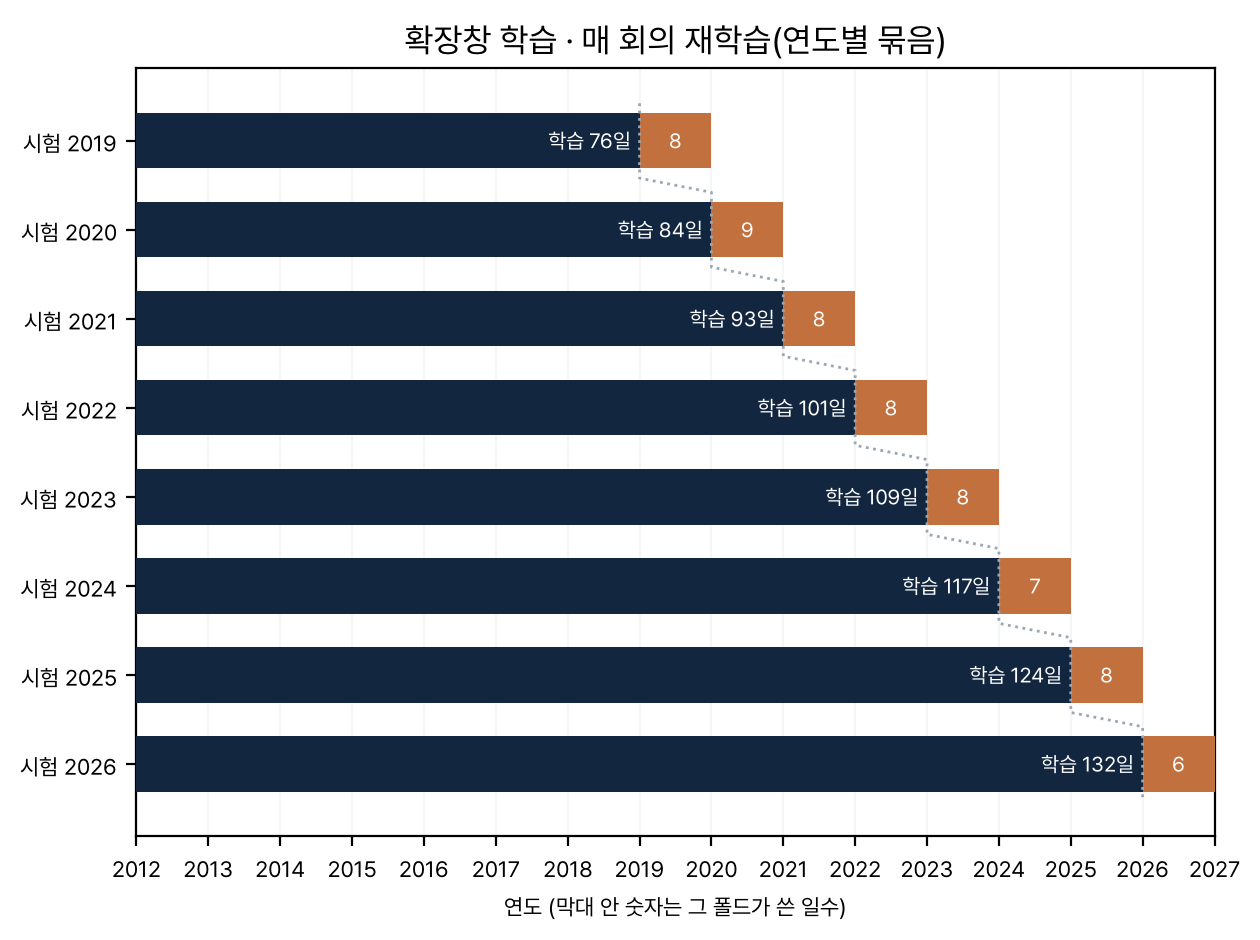
- 시험 회의마다 그 전의 회의 전부로 모델을 새로 학습해 그 회의 하나를 예측한다. 시험 자료가 학습에 들어가지 않는다.
- IC
- 표본 밖 예측과 실제 값의 Spearman 순위상관. 0 이면 무관하고, 음이면 거꾸로 맞힌 것이다.
- ρ
- Spearman 순위상관 계수.
- 방향 일치
- 예측 부호와 실제 부호가 같은 시험 회의의 비율.
- AUC
- 양성(인상 또는 인하) 회의에 음성 회의보다 높은 확률을 줄 확률. 0.5 가 무작위다.
- ΔIC, ΔAUC
- 같은 시험 회의에서 큰 모델 점수에서 작은 모델 점수를 뺀 값.
- 순열 검정
- 표적을 회의 사이에서 무작위로 섞어(5,000회) 관측 상관 이상이 나오는 비율을 p 로 삼는다. «p 0» 은 5,000회 중 0회라는 뜻(p < 0.0002)이다.
- 짝 bootstrap
- 시험 회의를 복원 추출(5,000회)하되 두 모델 점수를 같은 회의로 짝지어 Δ 의 95% 구간을 낸다.
- 부분상관
- 통방문 톤의 몫을 양쪽에서 뺀 뒤 남는 순위상관.
- H196 ~ H201
- 이 실험이 사전등록한 가설 번호(가설과 결론 절). H198 과 H199 는 a(보조)와 b(확증)로 나뉜다.
자료
| 자료 | 기간 | 해상도 | 행수, 결측 | 쓰임 |
|---|---|---|---|---|
| 한국은행 간담회 목록과 YouTube 영상 | 2008-04-10 ~ 2026-08-27 | 간담회 | 184 (회의 190 중 간담회 없는 6 제외) | 모든 특징의 원천 |
| 공식 자막(발화자 표시) | 2016-12 ~ 2026-08 | 발화 | 79 | 텍스트, 총재 발화 구간 |
| ASR 받아쓰기(Whisper large-v3-turbo) | 2008-04 ~ 2016-11 | 발화 | 105 | 텍스트, 총재 발화 구간 |
| 텍스트 톤 판독(Claude, 독립 2회) | 전 기간 | 간담회 | 판독 368, 결측 0 | 텍스트 블록 10열 |
| 음성 특징(wav2vec2, Praat, ECAPA) | 전 기간 | 4초 창을 간담회로 평균 | 184, 결측 0 | 음성 블록 14열 |
| 표정 특징(InsightFace, HSEmotion) | 전 기간 | 초당 1 프레임을 간담회로 평균 | 184, 결측 0 | 표정 블록 10열 |
| 금통위 결정 표 | 2008 ~ 2026-10 | 회의 | Y_next 161 (마지막 회의 미정) | 표적 Y_next |
| 3선, 10선 연결 1분봉 | 2012-01 ~ 2026-08 | 1분 | Y_press 138 | 표적 Y_press, Y_close |
| 표적 | 전체 | 시험 | 비고 |
|---|---|---|---|
| Y_next (다음 회의 결정) | 161 (2010-01 ~) | 61 | 동결 127, 인상 19, 인하 15. 시험에는 인상 12, 인하 7 |
| Y_press, Y_close (3선, 10선) | 138 (2012-01-13 ~) | 62 | 분봉이 2012-01 부터라 그 전 간담회는 빠진다 |
| tone_overall (H201) | 184 | 62 | 음성과 얼굴로 텍스트 톤을 되맞히는 설명용 표적 |
두 텍스트 판독은 tone_overall 에서 순위상관 0.908, 정확히 같은 값 87% 로 일치했다. 판독 근거로 적은 인용 1,104개 가운데 1,052개(95%)가 정규화한 원문에 그대로 있었다.
방법
표적과 시점. 금통위 날은 결정(09:50 안팎), 통방문(10:30), 간담회(11:10 안팎) 순서로 흘러간다. Y_press 창(11:05 → 12:30)은 간담회 시작 5분 전부터라 결정과 통방문 정보는 이미 가격에 있고, 간담회 안의 정보만 창에 들어온다. 음성과 표정은 간담회 전체에서 재므로 11:05 에는 모르는 값이다. 그래서 가격 표적은 간담회가 끝난 뒤 그 신호가 그 창의 움직임을 설명하는지 묻는 사후 설명 검정이고, 실시간 매매 규칙이 아니다. Y_next 는 간담회 뒤의 표적이라 사전 정보다.
걷기 전진. 2019-01-24 회의부터 시험 회의마다 그 전 회의 전부로 표준화와 모델을 새로 학습한다. Y_next 는 다음 결정일이 시험 회의보다 앞선 학습 표본만 쓰고, 답이 나지 않은 회의는 학습에서 뺀다. 결측은 학습창 평균으로 채우고 학습창 표준편차로 나눈다.
검정. 단일 상관(H196, H197, H198a, H199a, H201)은 회의 단위 순열 5,000회로, 모델 차이(H198b, H199b, H200)는 시험 회의 짝 bootstrap 5,000회로 잰다. 확증 가설은 문턱을 모두 넘어야 지지다. 시험이 62회뿐이라 검정력이 약해서, 미지지가 효과가 없다는 증거는 아니다.
모델
모델은 입력 블록만 다른 다섯 개이고, 표적마다 따로 학습한다. 연속 표적(Y_press, Y_close)에는 ridge 회귀를, 이진 표적(next_hike, next_cut)에는 L2 로지스틱 회귀를 쓴다. 표본이 작아 계수를 해석할 수 있는 선형 모델을 골랐고, 블록을 하나씩 더해 증분을 잴 수 있게 짰다.
| 모델 | 입력 | 열 | 왜 넣었나 |
|---|---|---|---|
| M_stmt 통방문 | 통방문 톤 | 1 | 기준선. 글만으로 얼마나 되나 |
| M_text 간담회 텍스트 | tone_overall, 요소별 톤 6개, qa_cut_push, qa_hike_push, tone_surprise | 10 | 간담회 말의 몫 |
| M_tv 텍스트+음성 | 텍스트에 음성 14열을 더함. 질의응답 arousal 평균과 표준편차, valence, dominance, F0 중앙값과 IQR, 강도 표준편차, jitter, shimmer, HNR, 말속도, 모두발언 arousal 과 valence, 각성 차(질의응답 빼기 모두발언) | 24 | 음성 증분(H198b) |
| M_tvf 텍스트+음성+얼굴 | 텍스트와 음성에 표정 10열을 더함. 질의응답 neg_share 평균과 표준편차, anger, sadness, fear, happiness, neutral, surprise, 모두발언 neg_share, 프레임 간 변화량 | 34 | 표정 증분(H199b), 멀티모달(H200) |
| M_vf 음성+얼굴 | 음성과 표정(텍스트 없음) | 24 | 음성과 표정이 톤을 담는가(H201) |
| 항목 | 값 |
|---|---|
| ridge | Ridge. alpha 는 CV 로 선택, fit_intercept True, solver auto, tol 1e-4, positive False |
| 로지스틱 | LogisticRegression. L2(l1_ratio 0), C = 1/α, solver lbfgs, max_iter 2000, tol 1e-4, class_weight None |
| α 후보와 선택 | 0.1, 1, 10, 100, 1000. 학습창 안 KFold 5겹(학습 표본이 적으면 줄임) |
| 전처리 | 학습창 평균으로 결측 대치, 학습창 표준편차로 표준화(시험 회의는 보지 않음) |
| 학습 방식 | 확장창 걷기 전진, 시험 2019-01-24 부터, 회의마다 재학습 |
| seed | 52 (CV 분할, bootstrap, 순열) |
마지막 시험 회의에서 CV 가 고른 α 는 가격 표적(ridge)에서 다섯 모델 모두 1000(후보 중 가장 센 규제)이었다. 계수가 크게 눌렸다는 뜻이고, 학습창 안에서 입력이 가격 움직임을 거의 설명하지 못했다는 신호다. 다음 결정(로지스틱)에서는 M_stmt 와 M_text 가 1000, 음성이 든 세 모델이 0.1(가장 약한 규제)이었다.
아래 그림은 마지막 시험 회의의 모델 26개를 실제로 다시 학습해 그린 표준화 계수다. 모델 다섯에 표적 다섯을 곱한 25개와, M_vf 의 tone_overall 표적 하나다. 그리기 전에 저장된 표본 밖 예측을 오차 1e-8 안에서 그대로 내는지 확인했다. 모델마다 첫 그림은 3선 Y_press 표적이고, 나머지 표적은 펼쳐 볼 수 있다.
통방문
다른 표적의 실제 학습 모델 4개
간담회 텍스트
다른 표적의 실제 학습 모델 4개
텍스트+음성
다른 표적의 실제 학습 모델 4개
텍스트+음성+얼굴
다른 표적의 실제 학습 모델 4개
음성+얼굴
다른 표적의 실제 학습 모델 5개
결과
| 모델 | 3선 IC | 방향 일치 | 10선 IC | 3선 Y_close IC | 인상 AUC | 인하 AUC |
|---|---|---|---|---|---|---|
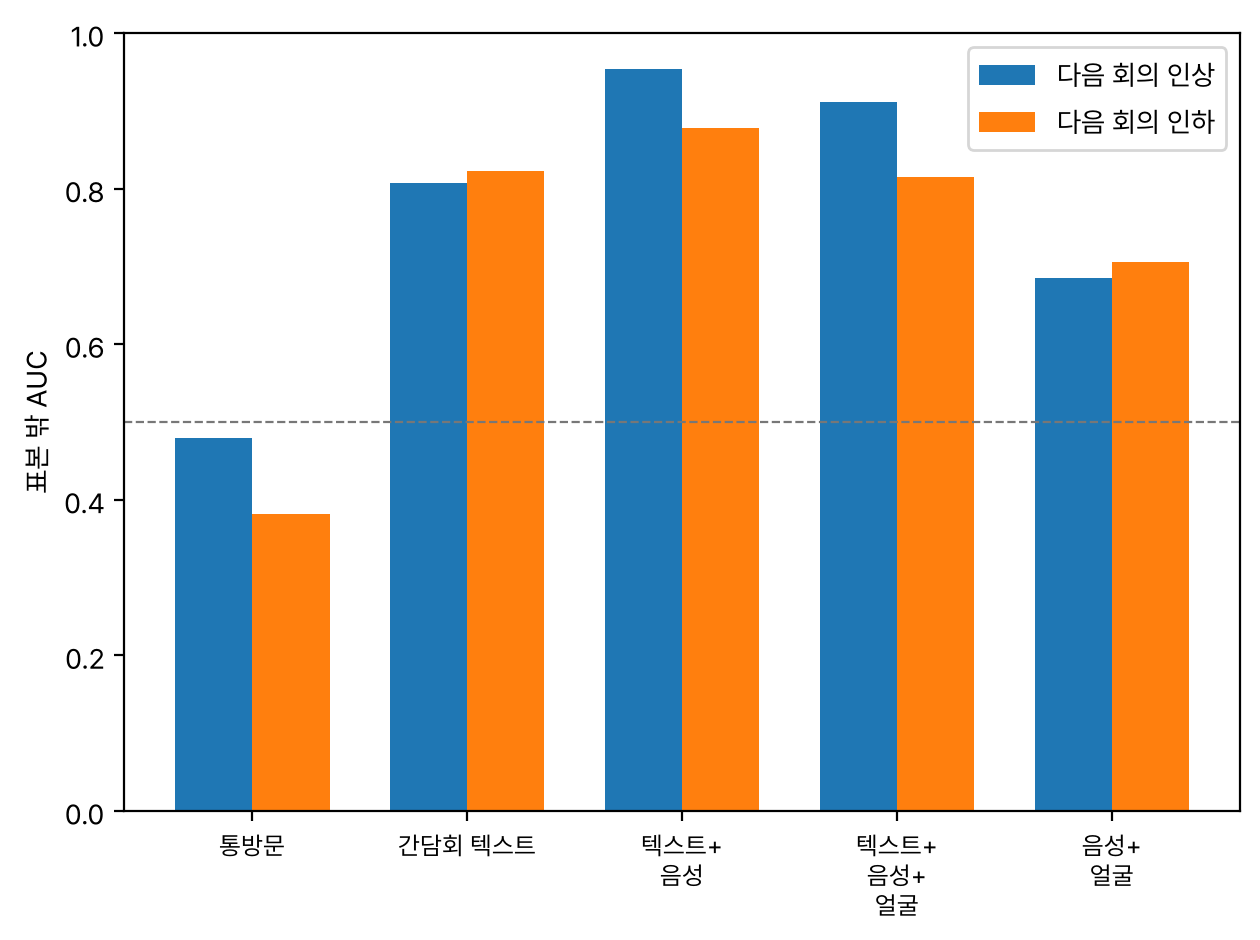
| M_stmt 통방문 | −0.103 | 51.6% | −0.246 | −0.032 | 0.480 | 0.382 |
| M_text 간담회 텍스트 | −0.168 | 45.2% | −0.259 | −0.097 | 0.808 | 0.823 |
| M_tv 텍스트+음성 | −0.235 | 45.2% | −0.152 | −0.074 | 0.954 | 0.878 |
| M_tvf 텍스트+음성+얼굴 | −0.202 | 45.2% | −0.217 | −0.134 | 0.912 | 0.815 |
| M_vf 음성+얼굴 | −0.198 | 45.2% | −0.144 | −0.194 | 0.685 | 0.706 |
| 가설 | 종류 | 값 | 문턱 | 판정 |
|---|---|---|---|---|
| H196 | 확증 | ρ 0.478 (p 0, 161회), 부분상관 0.169 (p 0.019) | ρ > 0.30, 부분 > 0 | 지지 |
| H197 | 확증 | ρ +0.024 (p 0.61, 138회) | ρ < −0.20 | 미지지 |
| H198a | 보조 | ρ −0.034 (p 0.65) | ρ > 0.20 | 미지지 |
| H198b | 확증 | ΔIC −0.067 [−0.224, +0.078] | Δ > 0, 구간 0 위 | 미지지 |
| H199a | 보조 | ρ +0.115 (p 0.92, 부호 반대) | ρ < −0.20 | 미지지 |
| H199b | 확증 | ΔIC +0.033 [−0.071, +0.141] | Δ > 0, 구간 0 위 | 미지지 |
| H200 | 확증 | 평균 ΔAUC +0.048 (인상 +0.104 [−0.022, +0.250], 인하 −0.008) | Δ > 0.05, 구간 0 위 | 미지지 |
| H201 | 보조 | 표본 밖 ρ 0.335 (p 0.0004, 62회) | ρ > 0.30 | 지지 |
다음 회의 결정
간담회 tone_overall 과 다음 결정의 순위상관은 0.478(161회)이고, 순열 5,000회에서 이를 넘은 경우는 없었다. 다만 통방문 톤만으로도 0.545, 향후 금리 경로 톤(guidance)만으로도 0.560 이라 대부분은 글에 이미 있는 정보다. 통방문 톤을 통제하고 남는 간담회의 몫은 부분상관 0.169(p 0.019)로 작지만 0 은 아니다.
표본 밖에서 텍스트 모델은 인상 AUC 0.808, 인하 AUC 0.823 으로 통방문 모델(0.480, 0.382)보다 각각 +0.328(구간 [+0.189, +0.471])과 +0.441(구간 [+0.210, +0.684]) 높았다. 이 비교는 가설 판정에 들지 않는 보고값이다. 통방문 톤 한 열로는 2019년 이후 인상과 인하 회의를 가리지 못했다.
간담회 시간대 국채선물
간담회 시간대 3선 방향은 다섯 모델 모두 IC 가 음수(−0.10 ~ −0.24)였고 방향 일치는 45 ~ 52% 였다. 10선과 마감까지의 변화(Y_close)도 같았다. 톤 서프라이즈와 Y_press 의 상관(H197)은 전체 +0.024 로 예측과 부호가 반대다. 2020년 이후 54회만 보면 −0.225(p 0.049)로 예측 쪽이지만 2012 ~ 2019 년 84회는 +0.200 이어서, 부호가 시기에 따라 뒤집힌다.
음성과 표정이 더하는 것
음성과 표정은 말의 톤을 담고 있다. 음성과 얼굴만으로 텍스트 톤을 표본 밖 ρ 0.335 로 되맞혔고(H201), 질의응답 부정 표정 비율은 톤과 −0.290, 각성은 톤과 +0.166 으로 함께 움직였다. 그러나 말을 이미 넣은 모델에 음성(H198b)이나 표정(H199b)을 더한 개선은 신뢰구간이 모두 0 을 품었고, 다음 결정의 평균 ΔAUC 도 +0.048 로 문턱 0.05 아래였다(H200). 인상만 보면 +0.104 지만 구간 하단이 −0.022 다. 각성과 반응 크기(H198a), 부정 표정과 가격 방향(H199a)의 단순 상관도 문턱에 못 미쳤다.
공식 자막 연도만 본 민감도
받아쓰기 오류를 걷어내려고 공식 자막이 있는 79회만 남겨 다시 쟀다. 탐색 분석이라 판정에는 쓰지 않는다. H196 의 상관은 0.663(78회)으로 더 강해졌고, H197 은 −0.122(p 0.14)로 여전히 문턱 밖이다. 받아쓰기 연도의 잡음이 톤 신호를 약하게 만들었을 수 있다.
한계
사후 설명. 음성과 표정은 간담회 전체에서 재므로 가격 표적(Y_press)과 같은 시간대의 정보다. 실시간 매매 성능으로 읽을 수 없다.
LLM 의 사전 지식. 과거 간담회를 읽은 LLM 이 사전학습에서 그 뒤 사건을 알고 있을 가능성을 배제하지 못한다. 두 판독은 같은 Claude 계열의 독립 세션이라 완전히 독립된 측정기가 아니다. Sonnet 별칭을 써서 정확한 하위 버전이 로그에 남지 않았다.
화자와 얼굴 구분. 총재 음성은 화자 군집과 자막 정렬로, 얼굴은 가장 많이 나온 신원 군집으로 고르므로 오분류가 남을 수 있다. 자막과 받아쓰기의 문자 일치율은 내지 못했다.
감정 라벨. 표정과 음성 감정 분류기의 학습 라벨은 일반 감정이지 통화정책 의도가 아니다.
표본과 보정. 시험 62회, 그중 인하 7회로 검정력이 약하고 다중 가설 보정은 하지 않았다.
구현 보완. 입력과 화자 처리 구현을 결과 계산 전에 보완했고, 계산 최적화 뒤 예측이 앞선 계산과 1e-9 안에서 같음을 확인했다. 영상과 시장 시각은 간담회 시작을 11:10 으로 가정해 맞췄다.
산출물
- 계획과 가설
protocol.md(커밋 817db7e, 결과 전) - 분석과 판정
analysis.md - 설정
config.yaml - 코드
code/bok_presser_inventory.py(목록과 자막),kaggle/(음성, 표정, 받아쓰기 추출),code/read_tone.py(톤 판독 취합),code/evaluate.py(걷기 전진과 검정),code/finalize.py(모델 재현, 구조도, 그림) - 런
results/20261025T225524Z_main/:tests.json,panel.csv,wf_predictions.csv,coefs.csv,model_objects.pkl,model_reproduction.json,sensitivity_subtitle_only.json,evidence_checks.csv - 트래커 반영
tracker_integration.md
Appendix
A. 데이터셋 실물
panel.csv 는 간담회 하나가 한 행이고 249열이다. 마지막 세 행의 주요 열은 다음과 같다.
| 회의 | 결정 | Y_next | 3선 | 10선 | 3선 close | 통방문 | tone | surprise | guidance | arousal | neg | 자막 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 2026-05-28 | 동결 | +1 | −12 | −47 | −7 | 2.0 | 2.0 | 0.0 | 2.0 | 0.410 | 0.497 | 예 |
| 2026-07-16 | 인상 | +1 | +9 | +32 | +3 | 2.0 | 2.0 | 0.0 | 2.0 | 0.374 | 0.543 | 예 |
| 2026-08-27 | 인상 | 없음 | +18 | +50 | +18 | 2.0 | 1.5 | −0.5 | 1.0 | 0.456 | 0.486 | 예 |
2026-08-27 의 Y_next 는 다음 회의(2026-10-22) 결과가 런 시점에 없어 학습과 시험에서 뺐다.
B. 모델 입출력 실물
- Request meta
- M_tvf ridge, 표적 3선 Y_press, 마지막 시험 회의 2026-08-27, 그 전 회의 전부로 학습, α 1000
- Input
- tone_overall 1.5, growth 2.0, inflation 2.0, finstab 2.0, fx 0.5, guidance 1.0, uncertainty 1.0, qa_cut_push 1.5, qa_hike_push 1.5, tone_surprise −0.5, 질의응답 arousal 0.456, valence 0.629, dominance 0.478, F0 중앙값 3.82 반음, 말속도 4.12 글자/초, 질의응답 neg_share 0.486, anger 0.145, sadness 0.269 …(중략, 34열 전부는
model_objects.pkl). 학습창으로 표준화해 넣는다. - Model response
- 다시 학습한 모델이 저장된 표본 밖 예측(틱)을 오차 1e-8 안에서 그대로 냈다(
model_reproduction.json). - Ground truth check
- 실제 3선 Y_press 는 +18틱이었다.
C. 실험 설정
- 표본간담회 2008-04-10 ~ 2026-08-27, 시험 2019-01-24 부터
- 모델Ridge(alpha CV), LogisticRegression(L2, C = 1/α, lbfgs, max_iter 2000), α 후보 0.1 / 1 / 10 / 100 / 1000, KFold 5
- 검정회의 단위 순열 5,000회, 짝 bootstrap 5,000회, seed 52, 다중 보정 없음
- 패키지numpy 2.5.2, pandas 3.0.5, scipy 1.18.0, scikit-learn 1.9.0, matplotlib 3.11.1