세 줄 요약
- 합성 사전학습 인코더에 머리만 붙인 모델의 확인 27일 60초 체결 Brier 는 0.0978 로 큐 길이 로지스틱 0.1037 보다 5.67% 낮았다(H1020 지지, Holm p 0.0006). 독립 감사가 지적한 근월물 선택의 미래 정보를 고친 뒤의 값이다.
- 그러나 손특징 LightGBM(0.0960)과 같은 구조를 실데이터로 처음부터 학습한 모델(0.0967)이 둘 다 더 낫고, 지정가 정책 절감은 LightGBM 보다 −0.0022틱 이다(H1021, H1022 미지지).
- 판정은 보류다. 사전 규칙상 H1020 만 통과해 보류지만, 사전학습이 실행 비용을 줄이는 몫은 없다. 결과 뒤 진단에서 합성 생성기의 잔량이 끝없이 자라는 결함을 찾았다.
가설과 결론
지정가로 사면 스프레드 반을 아끼지만 채워지지 않을 위험을 진다. 앞선 체결 확률 실험은 3년 국채선물 최우선 호가 맨 뒤에 50계약을 넣었을 때 60초 안에 채워질 확률을 호가와 체결 흐름으로 예측하고, 예상 비용이 작을 때만 지정가를 내는 정책이 시장가보다 주문당 약 0.1틱을 아낀다는 것을 보였다. 그런데 그 이득의 93% 가 «1칸 잔량이 짧으면 지정가» 라는 한 줄 규칙에서 나왔다. 남은 몫이 있다면 잔량이 얼마나 빨리 줄어드는지, 시장가가 몰려오는지 같은 비선형 동학일 것이다. 실데이터 두 달 반으로는 그런 동학을 배울 만한 큰 신경망을 학습하기 어렵다.
Bondnote 가 정리한 2026년 10월 논문은 합성 주문장으로 학습한 작은 모형이 이론적 손실 바닥에 닿고, 새 국면으로의 일반화는 모형 크기보다 생성기 국면의 다양성에서 온다고 보고했다. 그렇다면 국면을 넓게 섞은 합성 호가창으로 인코더를 미리 학습하고 실데이터로는 출력 머리만 맞추는 길이 열린다. 이 설계는 원자료를 밖으로 내보내지 않고도 외부 GPU 를 쓸 수 있다는 장점도 있다. 그래서 다음 세 가설을 결과 전에 사전등록했다.
- 가설
- H1020: 확인 구간 60초 체결 확률의 Brier 점수가 큐 길이 로지스틱보다 3% 이상 낮다(날 블록 부트스트랩 한쪽 p < 0.05). H1021: 그 확률로 지정가와 시장가를 고르는 정책의 주문당 절감이 앞선 실험의 LightGBM 정책보다 0.03틱 이상 크다. H1022: 같은 구조를 사전학습 없이 실데이터로만 처음부터 학습하면 Brier 가 더 나쁘다(이득이 사전학습에서 온다).
- 결론
- H1020 만 지지되고 H1021, H1022 는 미지지라 사전 규칙에 따라 보류다. 확인 27일에서 사전학습판(PT) Brier 는 0.0978, 큐 길이 로지스틱 0.1037 대비 5.67% 개선(90% 구간 4.80 ~ 6.49%, 한쪽 p 0.0002)이다. 정책 절감은 PT +0.0966틱, LightGBM +0.0988틱으로 차가 −0.0022틱(p 1.00)이고, 처음부터 학습한 같은 구조(SC)의 Brier 0.0967 이 PT 보다 낮아 H1022 도 반대 방향이다(p 1.00). 이 값은 근월물을 직전 영업일 체결량 1위로 고정하도록 계획을 고친 뒤 다시 돌린 런이며, 첫 런과 판정이 같다.
결론을 한 줄로 줄이면 «합성 호가창은 무엇을 봐야 하는지는 가르치지만, 실제 3선의 조용한 큐를 실데이터보다 잘 가르치지는 못한다» 이다. 사전학습한 인코더는 무작위 인코더보다 확실히 좋은 표현을 만들었다. 얼린 임베딩에서 1칸 잔량을 선형으로 읽는 R² 가 0.98 대 0.71 이다. 하지만 실데이터 17.9만 표본이면 같은 크기의 인코더를 처음부터 학습해도 된다. 앞선 실험이 보인 것처럼 지정가 정책에서 확률 개선이 줄일 수 있는 비용은 원래 작다. 그래서 더 좋은 확률이 생겨도 정책 절감은 0.002틱 단위로만 움직였다. 실무적으로 이 모델을 데스크 실행 규칙으로 올릴 이유는 없다.
용어와 기호
- 3선
- 한국거래소 3년 국채선물. 가격 단위는 포인트, 1틱은 0.01포인트다. 이 실험의 모든 비용은 계약당 틱이다.
- 1칸 잔량 Q0
- 주문 시각 t0 에 우리가 들어갈 쪽 최우선 호가에 이미 쌓인 수량(계약). 매수 주문이면 최우선 매수 잔량이다.
- 60초 체결 y
- t0 에 큐 맨 뒤에 넣은 50계약 지정가가 60초 안에 채워지면 1. 같은 가격 체결량이 Q0 + 50 이상이 되거나 더 나쁜 가격에 체결이 나면 채운 것으로 본다. 앞 잔량의 취소는 세지 않는 보수적 재생이다.
- Brier
- 예측 확률 p 와 결과 y 의 제곱 오차 평균 (p − y)². 낮을수록 좋다. 확인 구간 체결 비율이 13% 라 상수 예측의 Brier 는 약 0.11 이다.
- cM, cF, cU60
- 도착 중간가 대비 비용(틱). cM 은 바로 시장가, cF 는 채워진 지정가(대개 −0.5), cU60 은 못 채워서 60초 뒤 시장가로 낸 비용이다.
- 정책과 절감
- p × cF + (1 − p) × ĉU60 < cM 이면 지정가, 아니면 시장가. ĉU60 은 미체결 대체 비용의 LightGBM 예측으로 모든 정책이 같은 것을 쓴다. 절감 = cM − 정책 비용(틱/주문).
- 토큰
- t0 에서 끝나는 2초 칸 하나의 요약 벡터. 32개를 이어 64초 이력을 만든다. 특징은 주문 쪽으로 돌려 적는다.
- B0
- 큐 길이 로지스틱. log(1 + Q0) 하나만 쓴다. 앞선 실험의 기준선이다.
- LGB
- 앞선 실험의 LightGBM 체결 분류기. 잔량, 불균형, 최근 체결량, 가격 변화, 시각 등 손으로 만든 특징 23개를 쓴다.
- PT
- 확증 모델. 합성 호가창으로 미리 학습한 트랜스포머 인코더를 얼리고 실데이터로 출력 머리(작은 MLP)만 학습한 것.
- SC
- PT 와 같은 구조를 사전학습 없이 실데이터로 처음부터 전부 학습한 것. 사전학습의 몫을 가르는 대조다.
- RF
- 무작위로 초기화한 인코더를 얼리고 머리만 학습한 것. 구조만으로 얻는 몫을 보는 귀무 대조다.
- Hawkes 과정
- 사건 하나가 뒤따르는 사건의 강도를 잠시 높이는 점과정. 분기비는 사건 하나가 평균 몇 개의 자식 사건을 낳는지이며 1 보다 작아야 폭발하지 않는다.
- 국면
- 합성 생성기의 네 가지 시장 상태. 정상, 급변(높은 자기 흥분), 얇은 장(작은 잔량), 쏠림(한쪽 시장가가 더 잦음).
- 날 블록 부트스트랩
- 확인 구간 거래일을 복원 추출로 5,000번 다시 뽑아 통계량 분포를 만든다. 같은 날 표본끼리의 상관을 보존한다. 한쪽 p 는 분포에서 통계량이 0 이하인 비율이다.
- 선형 탐침
- 얼린 임베딩에서 어떤 양(예: 1칸 잔량)을 릿지 회귀로 읽어 낼 수 있는지 보는 진단. 확인 구간 R² 로 잰다.
자료
실데이터와 표본
실데이터는 코스콤 3년 국채선물 근월물의 마이크로초 호가 1 ~ 5단과 체결로, 2026-07-08 부터 2026-11-10 까지 75거래일이다. 얇은 날(07-29)과 행이 중복으로 부푼 날(07-31)은 앞선 실험과 같이 뺐다. 표본은 앞선 실험의 가상 주문 표본을 그대로 이어 받았다. 09:00 부터 15:15 까지 10초마다 매수와 매도 양쪽으로 50계약 가상 지정가를 큐 맨 뒤에 넣고, 그 뒤 체결 흐름을 재생해 60초 안에 채워지는지 기록한다. 직전 300초나 이후 180초 안에 90초 넘는 호가 공백이 있으면 그 표본은 버린다. 11-06, 11-09, 11-10 사흘은 앞선 실험의 표본 코드 사본으로 새로 만들었다. 근월물은 직전 영업일 체결량 1위 종목으로 정했다. 앞선 실험 캐시는 그날 하루 전체 체결량 1위를 썼는데, 이것은 장중에 알 수 없는 정보라고 독립 감사가 지적했고 맞았다. 두 규칙이 다른 날은 9월물 만기 전날인 09-14 하루라 그날만 9월물로 다시 만들었다. 전체 표본은 322,334건이다.
자료 점검에서 두 가지를 찾았다. 첫째, 체결 표의 공격 방향 필드가 10월 말까지 한 값이고 그 뒤 비어 있어서 앞선 실험처럼 직전 호가로 방향을 추정했다(체결가가 직전 매도 1호가 이상이면 매수 공격). 둘째, 2, 3칸 호가 수량이 7 ~ 8월 전부와 9월 일부에 비어 있었다. 코스콤 표의 열이 9월 중순에 늘어난 탓이다. 학습 구간의 절반 이상에서 이 값이 0 이라 두 영역 모두에서 2, 3칸 잔량 특징을 0 으로 가렸다. 이 결정은 결과를 보기 전에 했다. 11-04 와 11-06 에는 두세 시간짜리 호가 공백이 있어 그 시간대 표본은 공백 규칙으로 빠졌다.
| 구간 | 기간 | 거래일 | 표본 | 쓰임 |
|---|---|---|---|---|
| 학습(머리 적합) | 2026-07-08 ~ 09-17 | 42 | 178,660 | PT, RF 머리와 SC 학습 |
| 학습 안 검증 | 2026-09-18 ~ 09-30 | 6 | 27,012 | 조기 종료 전용 |
| 학습 전체 | 2026-07-08 ~ 09-30 | 48 | 205,672 | B0, LGB, ĉU60 적합 |
| 확인 | 2026-10-01 ~ 11-10 | 27 | 116,662 | 모든 판정 |
합성 호가창
합성 호가창은 0.1초 간격의 이산시간 다변량 Hawkes 주문 흐름이다. 매수와 매도 각각에 1 ~ 3칸 지정가 추가, 1 ~ 3칸 취소, 시장가가 있다. 시장가는 같은 쪽 시장가(주문 쪼개기), 반대쪽 시장가, 같은 쪽 1칸 취소(겁먹은 유동성 철수), 반대쪽 1칸 추가(유동성 보충)를 흥분시킨다. 시장가가 1칸을 다 먹으면 가격이 한 틱 밀리고 2칸이 1칸이 된다. 스프레드가 2틱 이상 벌어지면 안쪽을 채우는 새 호가가 들어온다. 이산화 때문에 분기비가 부풀지 않도록 증분에 보정 계수를 곱했고 분기비 합은 0.92 아래로 묶었다.
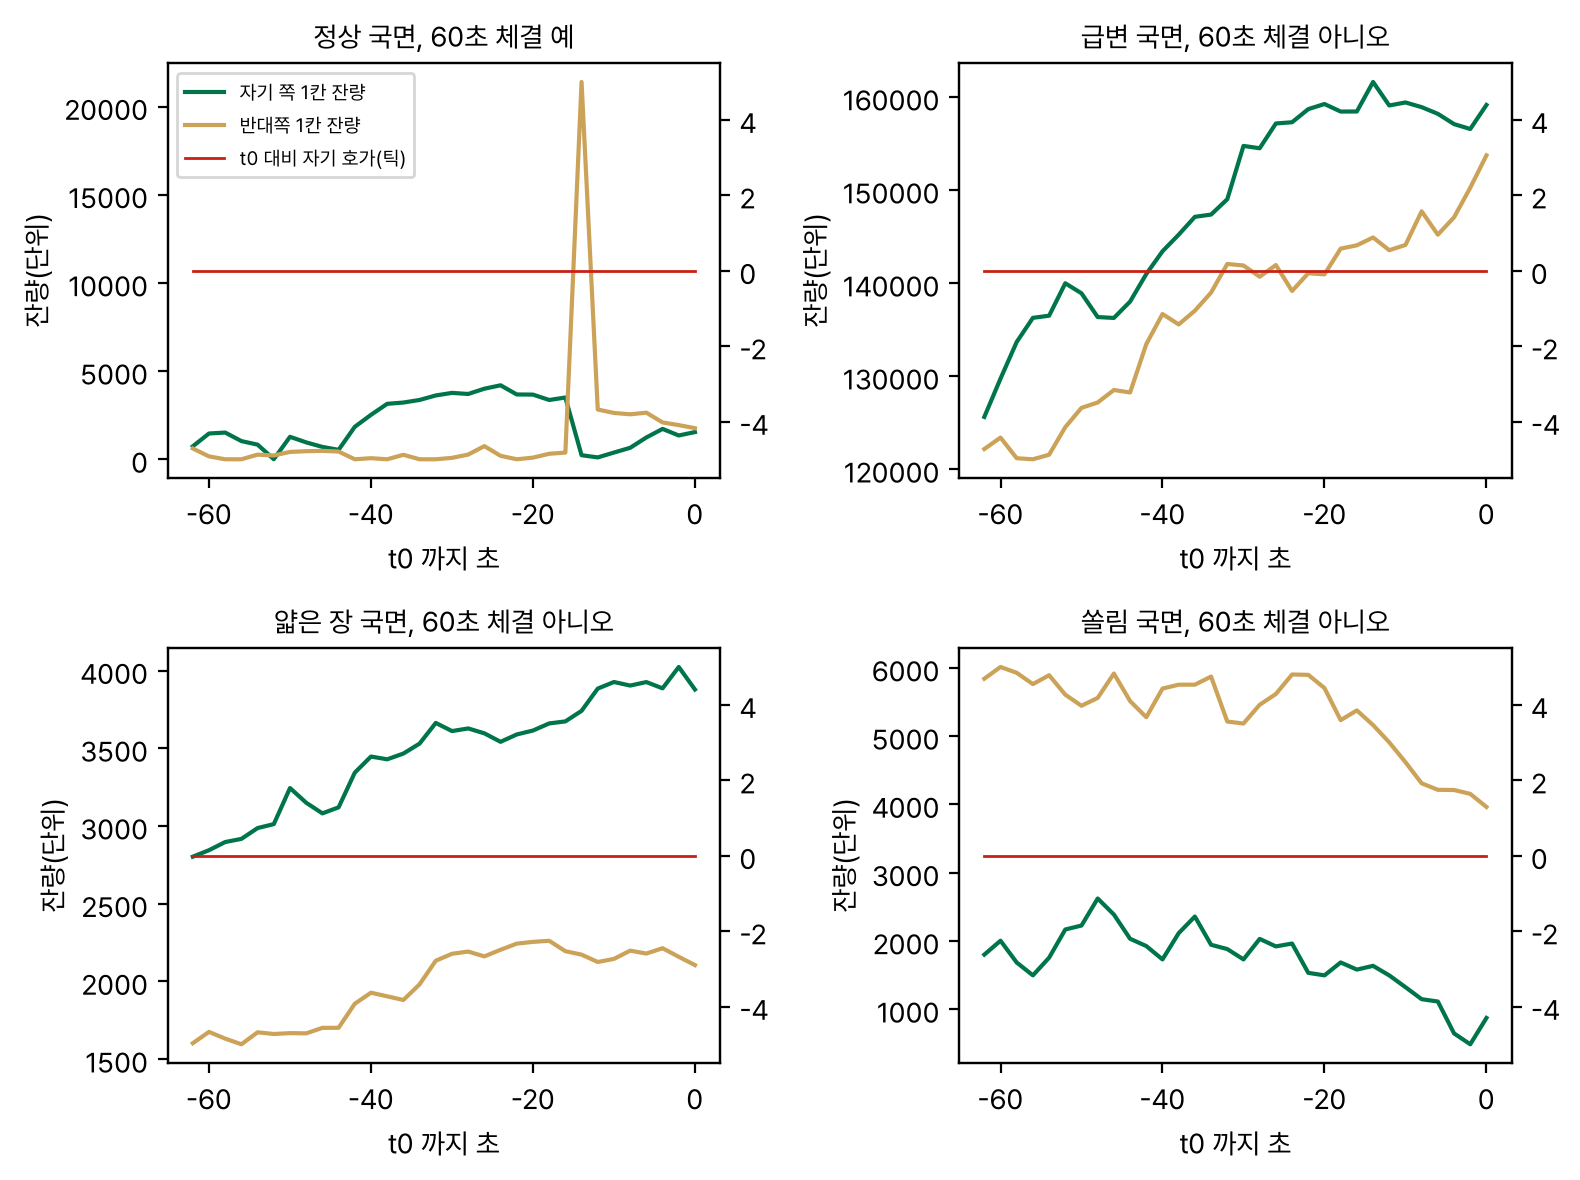
모수는 실데이터에 적합하지 않았다. 문헌의 Hawkes 범위(분기비 0 ~ 0.9, 감쇠 0.5 ~ 5/초)와 3선의 공개된 성격(1틱 스프레드, 수백 계약 잔량)에서 넓은 범위를 잡고, 네 국면 중 하나를 고른 뒤 그 안에서 경로마다 모수를 무작위로 뽑았다. 원 논문이 일반화의 열쇠로 꼽은 국면 다양성을 영역 무작위화로 흉내 낸 것이다. 경로마다 1,200초를 돌리고 10초마다 양쪽에 가상 50단위 주문을 넣어 실데이터와 같은 규칙으로 60초 체결을 판정했다. 아래 그림은 네 국면에서 뽑은 표본 하나씩의 64초 이력이다.
표본 분할과 반출 규칙
학습은 2026-07-08 ~ 09-30 의 48일로 앞선 실험과 같고, 그 안의 마지막 6일(09-18 ~ 09-30)은 머리와 SC 의 조기 종료에만 썼다. 확인은 2026-10-01 ~ 11-10 의 27일이다. 아이디어 원안은 9 ~ 10월 학습, 11월 확인이었지만 11월은 7일뿐이라 검정력이 너무 작아 보조 보고로 내렸다. 확인 구간 10월분은 앞선 실험의 기준선 결과가 이미 공개된 날이라는 점은 한계에 적는다. Kaggle 에는 코드만 올렸다. 합성 자료는 커널 안에서 생성했고 실데이터, 그 토큰과 라벨은 이 PC 밖으로 나가지 않았다. 내려받은 것은 인코더 가중치와 학습 기록뿐이다.
방법
토큰과 표적
실데이터와 합성 자료가 같은 입력을 갖도록 2초 칸 요약을 토큰으로 썼다. 칸 끝의 호가 상태와 그 칸 안의 체결로 12개 특징을 만든다. 자기 쪽과 반대쪽 1칸 잔량의 로그, 2, 3칸 잔량의 로그(가림), 스프레드에서 1틱을 뺀 값, 중간가 변화, 자기 쪽을 친 공격 체결량의 로그, 반대쪽 공격량의 로그, t0 대비 자기 최우선 가격, 가격이 같을 때 자기 1칸 잔량 변화다. 모두 주문 쪽으로 돌려 적어서 매수 주문과 매도 주문이 같은 모양이 된다. 잔량 로그에서는 고정 상수 6 을 뺐을 뿐 실데이터로 표준화하지 않았다. 사전학습 표적은 세 가지다. 60초 체결 여부(이진), 다음 2초 중간가 방향(3분류), 체결 30초 뒤 마크아웃(회귀, ±5틱에서 자름)이다. 실데이터 표적은 60초 체결 여부 하나다.
비교한 모델
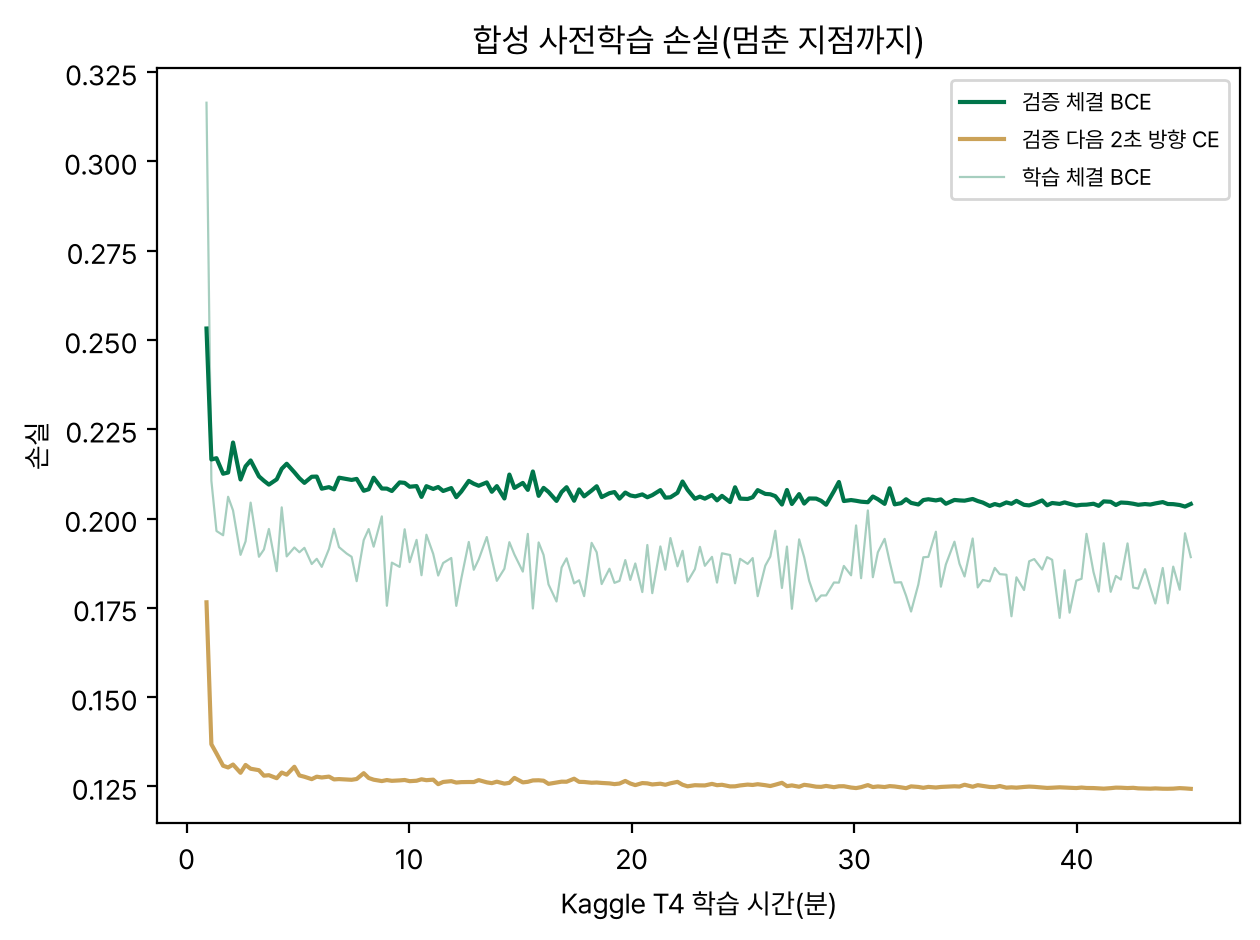
확증 모델 PT 는 4층, 은닉 128, 머리 4개, 피드포워드 512 의 트랜스포머 인코더(약 80만 모수)다. 토큰 32개 앞에 분류 토큰을 붙이고 그 마지막 은닉 128차원을 임베딩으로 쓴다. Kaggle T4 한 장에서 45분 동안, 매번 새로 생성한 경로 1,024개 묶음으로 세 표적의 손실 합을 줄였다. 실데이터에서는 인코더를 얼리고 128 → 64 → 1 MLP 머리만 학습한다(Adam, 학습률 0.001, 검증 손실이 3에폭 나아지지 않으면 멈춤, 시드 둘의 예측 평균). SC 는 같은 인코더와 머리를 실데이터로 처음부터 학습했고(AdamW 0.0005, 최대 6에폭, 검증 손실이 나빠지면 멈춤, 시드 둘 평균), RF 는 무작위 인코더 위에 머리만 학습했다. 기준선 B0 와 LGB 는 학습 48일 전체로 적합했고, LGB 의 모수와 특징은 앞선 실험 그대로다. 로지스틱 23특징도 함께 보고한다.
정책과 검정
모든 정책은 같은 미체결 대체 비용 예측 ĉU60 을 쓰고 체결 확률만 바꾼다. 그래서 정책 차이는 확률의 질 차이다. H1020 은 0.97 × Brier(B0) − Brier(PT) 를, H1021 은 (PT 절감 − LGB 절감) − 0.03 을, H1022 는 Brier(SC) − Brier(PT) 를 통계량으로 삼아 확인 27일을 날 단위로 5,000번 다시 뽑았다. 셋은 Holm 으로 보정한다. 판정은 셋이 모두 통과하면 채택, H1020 만 통과하거나 PT 가 LGB 보다 유의하게 나으면 보류, 그 밖은 폐기로 미리 정했다. 이 정책은 모든 주문에 쓰는 실행 규칙이라 연 24회 빈도 규칙에 걸리지 않는다. 사전등록한 강건성 격자는 대기 10, 30, 60초와 큐 앞 잔량 가정 셋(전부, 절반, 맨 앞)의 9칸이며, 칸마다 B0, LGB, PT 머리를 다시 학습했다. 금통위(10-22)와 큰 공백 날을 뺀 결과, 11월만의 결과, 1초 늦은 주문의 결과도 함께 낸다.
모델
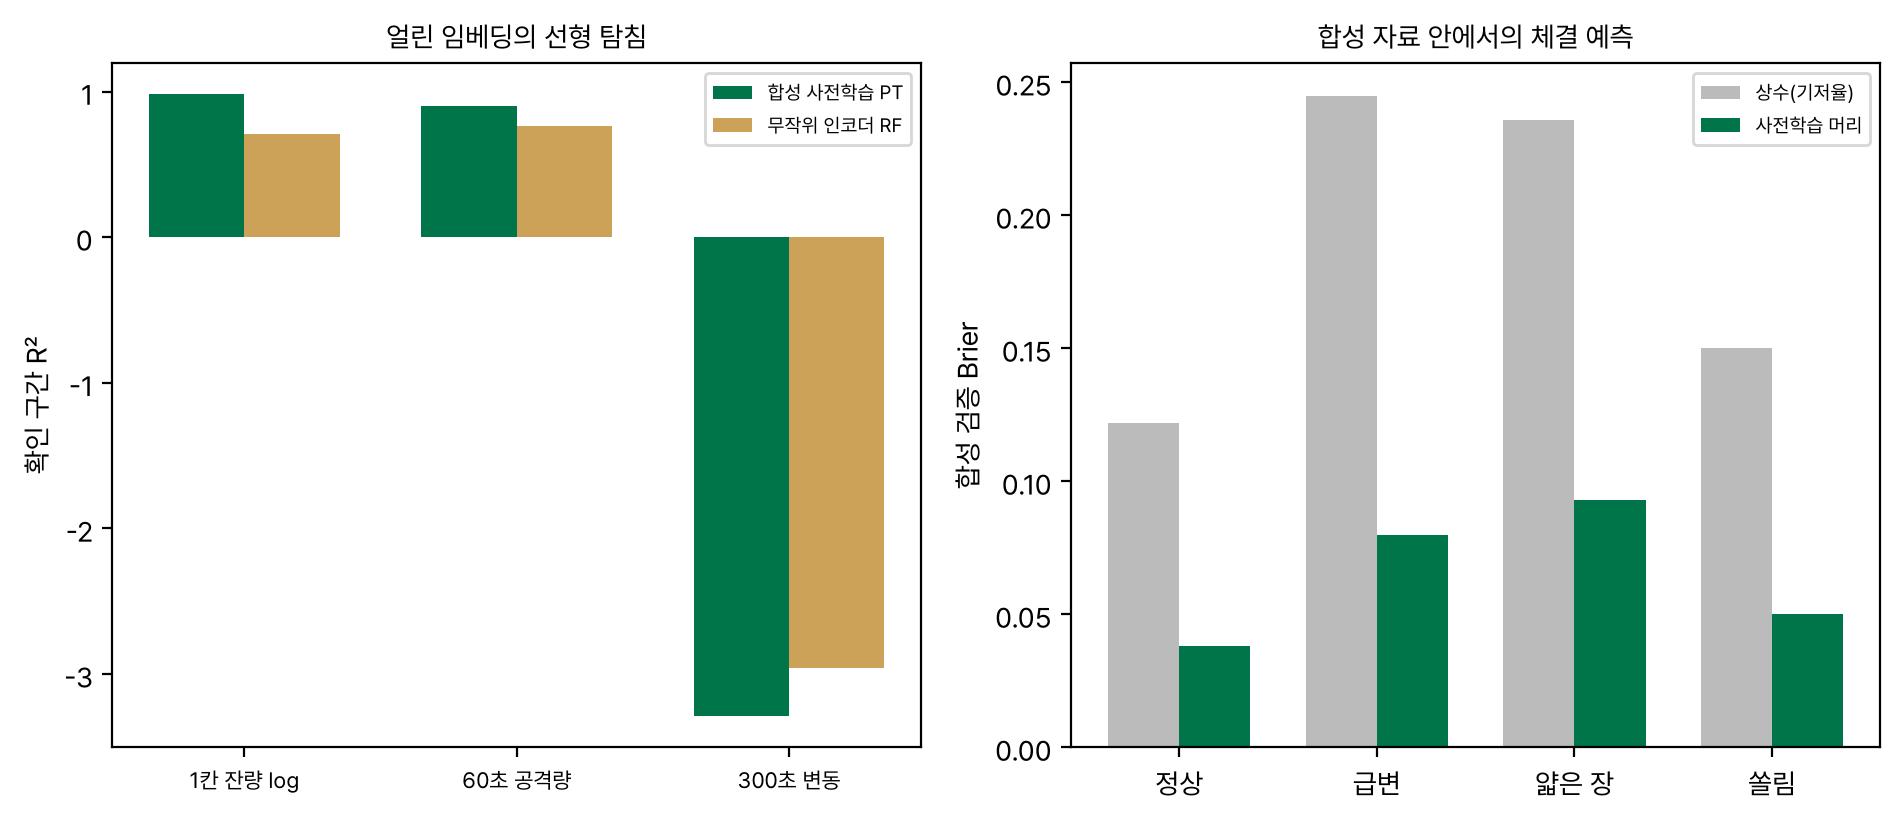
아래 구조도는 저장된 인코더 가중치와 머리 가중치를 다시 읽어 확인 구간 예측이 정본 런과 같은지 확인한 뒤 그렸다. 인코더는 토큰 사영 한 층과 인코더 블록 네 개로 모수 79만 9,360개이고, 실데이터로 학습한 부분은 그 뒤 머리 두 층(8,321개)뿐이다. 사전학습은 45분 동안 경로 1,024개짜리 묶음 171개, 합성 표본 3,642만 개를 한 번씩만 보았다. 같은 표본을 두 번 보지 않으므로 과적합보다는 생성기가 실제와 얼마나 닮았는지가 성능을 정한다. 합성 검증 묶음에서 체결 Brier 는 정상 국면 0.038(상수 0.122), 급변 0.080(0.245), 얇은 장 0.093(0.236), 쏠림 0.050(0.150)으로 합성 세계 안에서는 체결을 잘 맞혔다.
결과
아래 수치는 모두 계획 수정(근월물 선택) 뒤 다시 돌린 정본 런 results/20261111T031322_main 의 값이다. 첫 런은 _void_ 접두어를 붙여 남겼고 판정은 두 런이 같다.
확증 결과
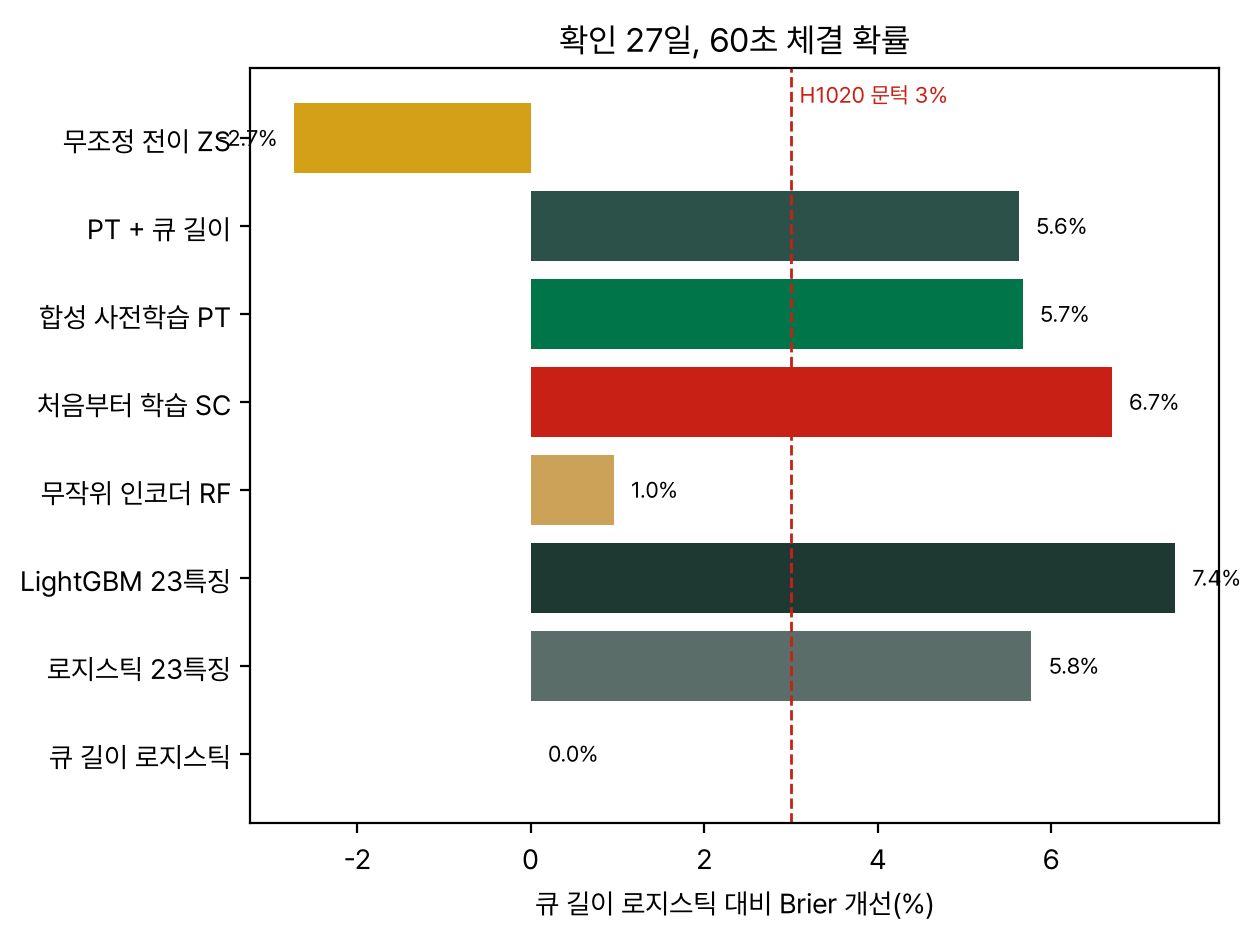
확인 구간은 2026-10-01 부터 11-10 까지 27거래일, 가상 주문 116,662건이고 그중 13.2% 가 60초 안에 채워졌다. 학습 구간 체결 비율을 그대로 쓰는 상수 예측의 Brier 는 0.1144 다. 큐 길이 하나만 쓴 로지스틱(B0)이 0.1037 로 그보다 9% 낮고, 확증 모델 PT 는 0.0978 로 B0 보다 다시 5.67% 낮다. 날 단위 부트스트랩 5,000번의 90% 구간이 4.80 ~ 6.49% 라 3% 문턱을 넘었다. H1020 은 Holm 보정 뒤에도 p 0.0006 으로 지지된다.
나머지 둘은 반대로 나왔다. 지정가 정책의 시장가 대비 절감은 PT 가 주문당 +0.0966틱, 앞선 실험의 LightGBM 이 +0.0988틱이다. PT 가 0.0022틱 덜 아꼈고 90% 구간이 −0.0034 ~ −0.0008 로 전부 음이라 0.03틱 이상 낫다는 H1021 은 전혀 가깝지 않다. 사전학습 없이 같은 구조를 실데이터로 처음부터 학습한 SC 의 Brier 는 0.0967 로 PT 보다 0.0011 낮다. 사전학습판이 낫다는 H1022 와 부호가 반대이고 90% 구간도 전부 음이다. 사전학습은 큐 길이 기준선을 이기는 데는 충분했지만, 실데이터를 직접 쓴 두 모델보다는 못했다.
| 가설 | 통계량 | 값 | 90% 구간 | 한쪽 p | Holm p |
|---|---|---|---|---|---|
| H1020 | B0 대비 Brier 개선 | 5.67% | 4.80 ~ 6.49% | 0.0002 | 0.0006 |
| H1021 | 절감 PT − LGB(틱) | −0.0022 | −0.0034 ~ −0.0008 | 1.00 | 1.00 |
| H1022 | Brier SC − PT | −0.0011 | −0.0014 ~ −0.0007 | 1.00 | 1.00 |
| 보조 | Brier LGB − PT | −0.0018 | −0.0024 ~ −0.0012 | 1.00 |
기준선과 대조 모델
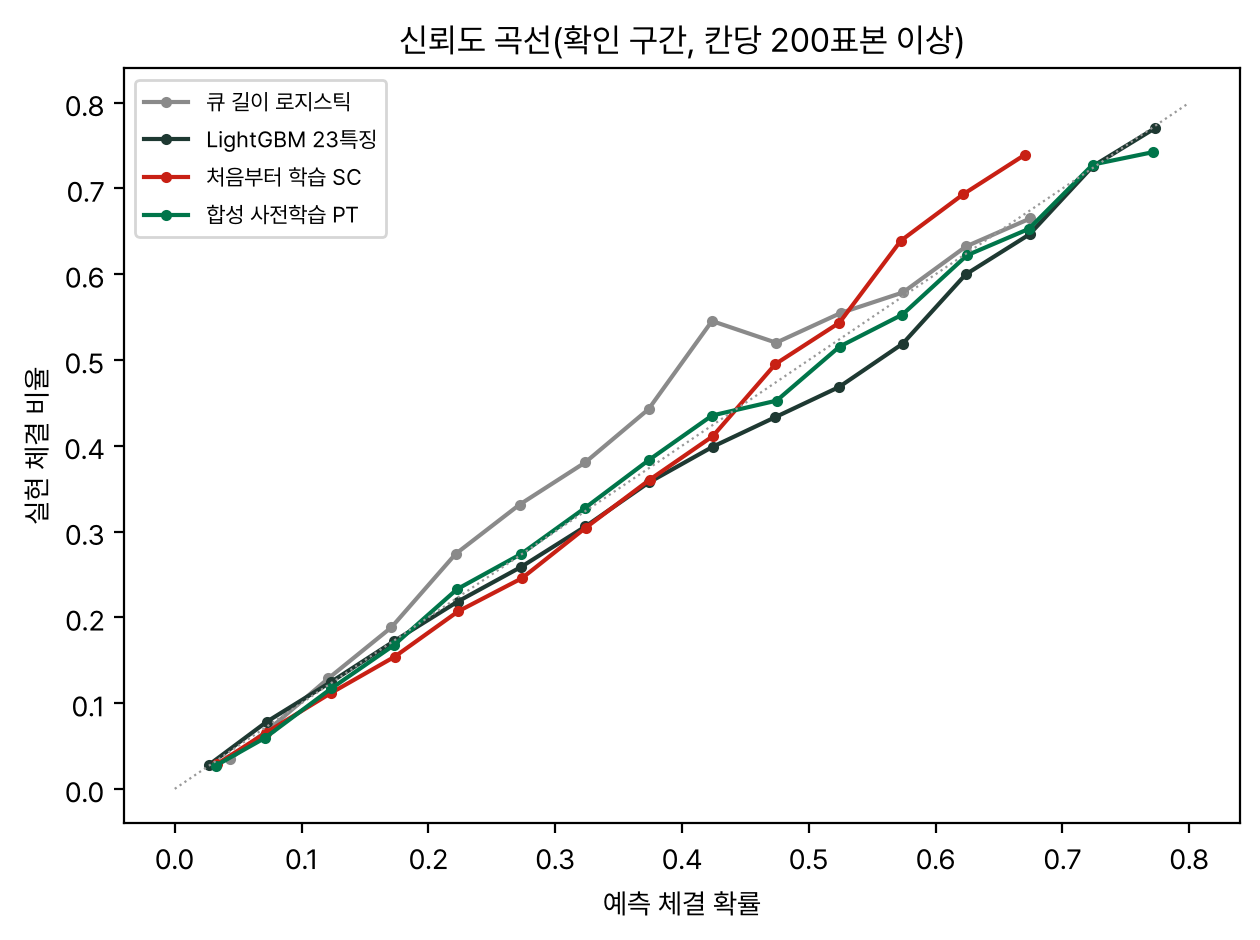
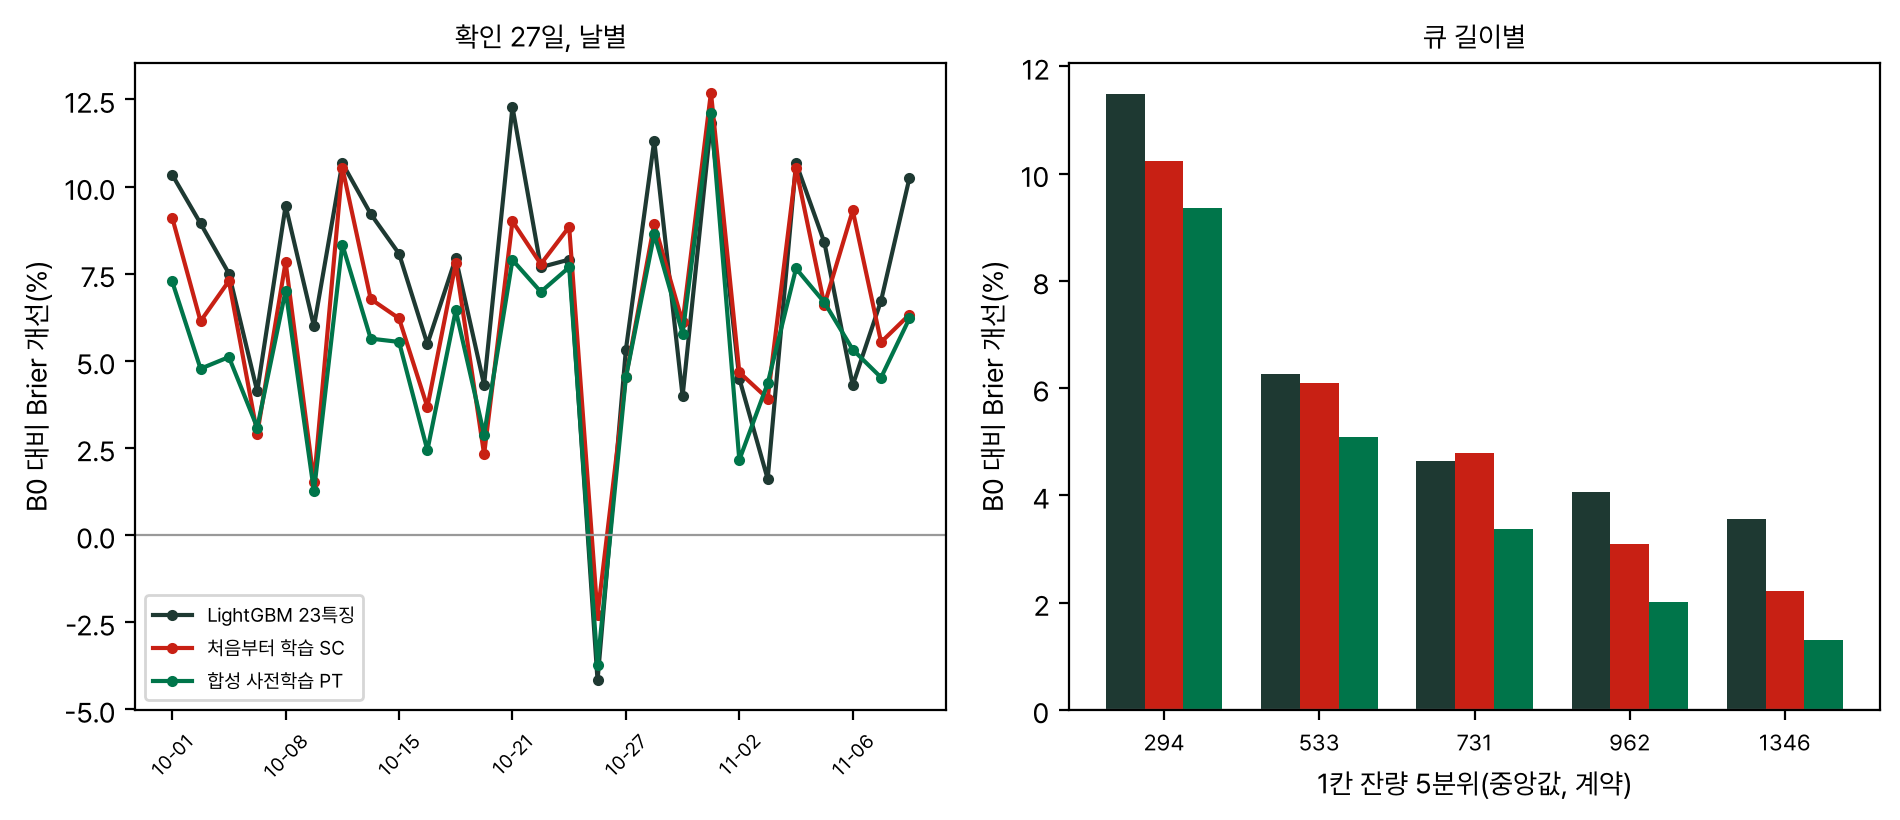
대조 모델 둘이 해석의 축이다. 무작위로 초기화한 인코더를 얼리고 머리만 학습한 RF 는 B0 대비 1.0% 개선에 그쳤고 그마저 유의하지 않다(p 0.061). 같은 구조, 같은 머리, 같은 학습 절차에서 인코더 가중치만 다르므로 RF 와 PT 의 차이(Brier 0.0049, p 0.0002)가 합성 사전학습이 만든 몫이다. 그 몫은 분명히 있다. 반면 SC 는 PT 보다 0.0011 더 낮고 LightGBM 보다는 0.0008 높다. 즉 실데이터 17.9만 표본이면 0.8M 모수 인코더도 처음부터 꽤 잘 배우고, 합성에서 가져온 표현은 그 출발점으로서도 이점이 없었다. 신뢰도 곡선(그림 3)을 보면 네 모델 모두 0.4 아래에서는 잘 보정돼 있고 차이는 높은 확률 구간의 기울기에서 난다.
| 모델 | Brier | B0 대비 | AUC | 정책 비용(틱) | 시장가 대비 절감 | 지정가 비율 |
|---|---|---|---|---|---|---|
| 항상 시장가 | 0.504 | 0 | 0% | |||
| 항상 지정가 + 60초 대체 | 0.466 | +0.038 | 100% | |||
| B0 큐 길이 로지스틱 | 0.1037 | 0 | 0.715 | 0.413 | +0.091 | 56% |
| RF 무작위 인코더 + 머리 | 0.1027 | 1.0% | 0.746 | 0.410 | +0.094 | 57% |
| 로지스틱 23특징 | 0.0977 | 5.8% | 0.775 | 0.407 | +0.097 | 54% |
| PT 합성 사전학습 + 머리(확증) | 0.0978 | 5.7% | 0.769 | 0.407 | +0.097 | 57% |
| SC 처음부터 학습 | 0.0967 | 6.7% | 0.782 | 0.405 | +0.099 | 55% |
| LGB 23특징(앞선 실험) | 0.0960 | 7.4% | 0.787 | 0.405 | +0.099 | 53% |
| 무조정 전이 ZS | 0.1065 | −2.7% | 0.725 | 0.418 | +0.086 | 41% |
| 사후 최선(오라클) | 0.327 | +0.177 | 18% |
정책 쪽에서 보면 모든 확률 모델이 시장가 대비 0.091 ~ 0.099틱 사이에 몰려 있다. 같은 지정가 비율(57%)로 무작위로 고른 정책 1,000번의 99% 분위가 +0.024틱이니 어떤 모델이든 무작위보다는 훨씬 낫다. 그러나 큐 길이 하나에서 가장 좋은 LightGBM 까지 차이가 0.0075틱이고, 오라클 상한 0.177틱과 비교하면 남은 0.085틱 가운데 확률 개선으로 줄인 것이 열에 하나도 안 된다. 합성 머리를 그대로 실데이터에 쓴 무조정 전이는 합성 체결 기저율(16 ~ 44%)과 실데이터(13%)가 달라 확률이 어긋났고, 지정가를 41% 만 골라 절감도 가장 작았다.
강건성 격자
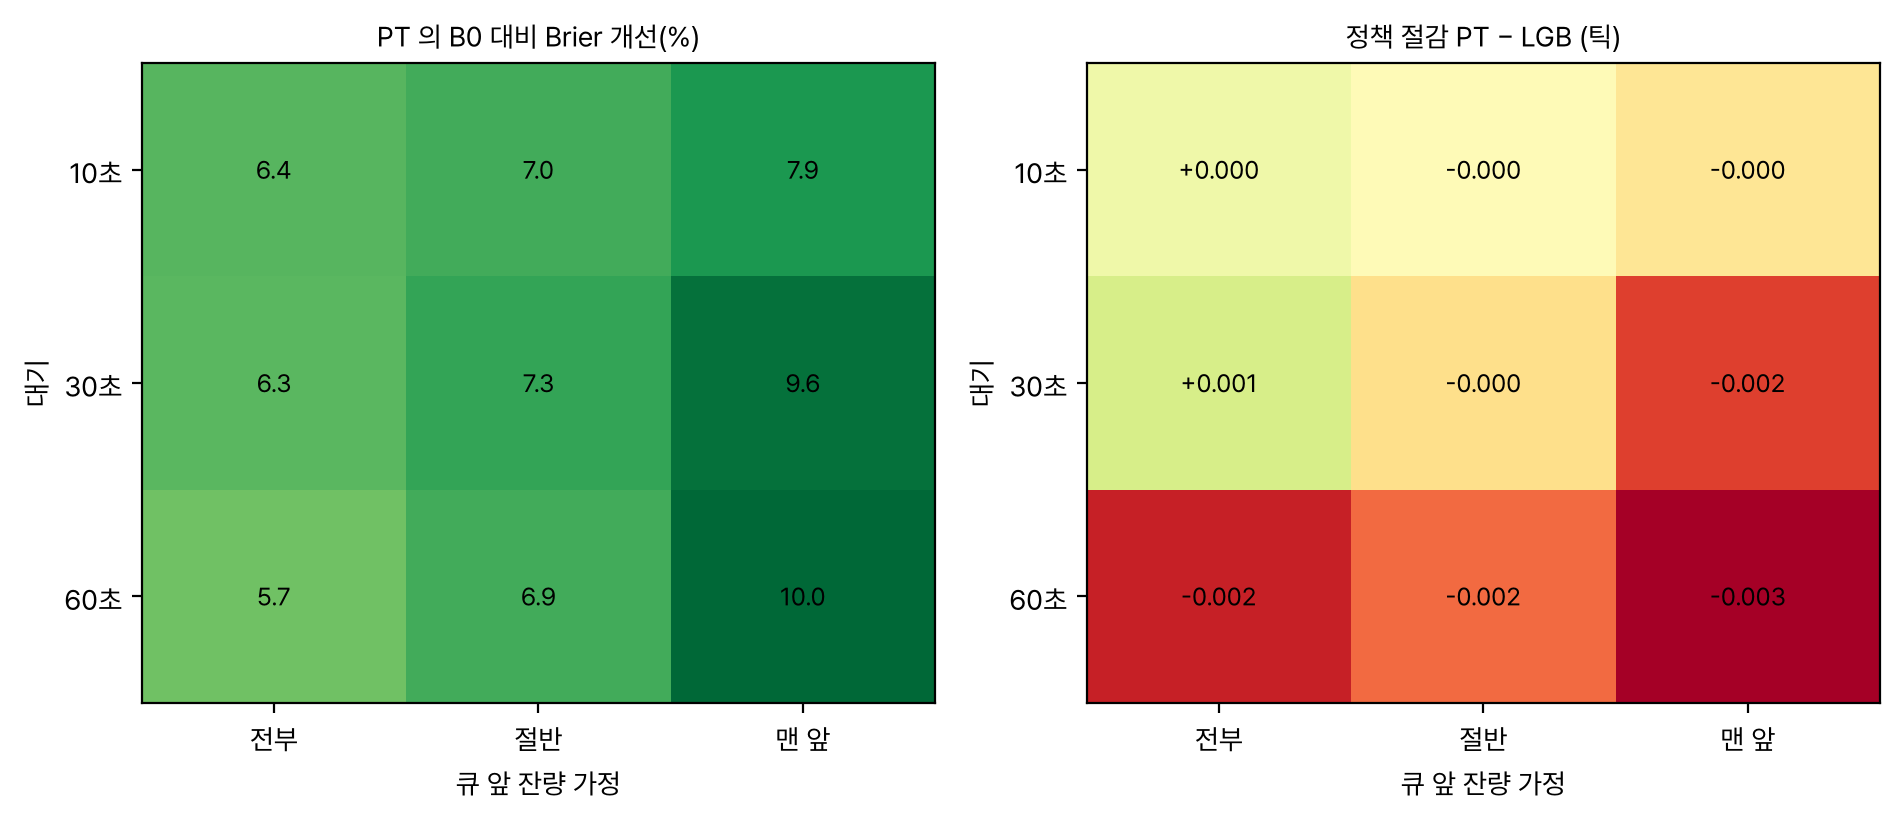
대기 시간 10, 30, 60초와 큐 앞 잔량 가정 셋(전부, 절반, 맨 앞)의 9칸을 사전등록했다. 칸마다 라벨을 바꾸고 B0, LGB, PT 머리를 다시 학습했으며 PT 인코더는 같은 것을 썼다. PT 의 B0 대비 Brier 개선은 9칸 모두 5.7 ~ 10.0% 로, H1020 의 결론은 체결 정의에 민감하지 않다. 큐 맨 앞 가정처럼 체결이 잦을수록 개선 폭이 커진다. 정책 절감의 PT − LGB 차는 −0.0025 ~ +0.0005틱이고, 9칸 모두 PT 의 Brier 가 LGB 보다 높다. 사전학습판이 LightGBM 을 의미 있게 앞서는 체결 정의는 하나도 없었다.
부분 표본, 지연, 비용 환산
아이디어 원안대로 11월 7일만 보면 Brier 는 B0 0.1036, LGB 0.0967, PT 0.0981, SC 0.0967 로 순서가 같고 H1020 p 는 0.0022 다. 앞선 실험이 학습에도 확인에도 쓰지 않은 완전히 새 3일(11-06, 11-09, 11-10, 10,806건)만 보아도 0.0994, 0.0923, 0.0941, 0.0925 로 같은 순서이고 H1020 p 는 0.042 다. 10월만, 금통위 10-22 제외, 큰 호가 공백 날 제외도 모두 같은 순서다. 주문이 1초 늦게 닿는다고 하면 절감이 PT +0.089, LGB +0.091, B0 +0.084틱으로 고르게 0.008틱쯤 줄어든다. 진입과 청산에 모두 이 정책을 쓰면 왕복 절감은 PT 0.193틱으로 판정용 왕복 1틱의 19%, 보고용 2틱의 10% 다. 비용을 0.5틱으로 보면 39% 다. 날별로 보면 27일 중 PT 가 LGB 보다 Brier 가 낮은 날은 5일, SC 는 8일이었다.
| 부분 | 거래일 | Brier B0 | LGB | PT | SC | H1020 p | 절감 PT − LGB |
|---|---|---|---|---|---|---|---|
| 확인 전체 | 27 | 0.1037 | 0.0960 | 0.0978 | 0.0967 | 0.0002 | −0.0022 |
| 11월만 | 7 | 0.1036 | 0.0967 | 0.0981 | 0.0967 | 0.0022 | −0.0028 |
| 새 3일(11-06, 09, 10) | 3 | 0.0994 | 0.0923 | 0.0941 | 0.0925 | 0.0416 | −0.0012 |
| 10월만 | 20 | 0.1037 | 0.0958 | 0.0977 | 0.0968 | 0.0002 | −0.0020 |
| 금통위 제외 | 26 | 0.1009 | 0.0934 | 0.0953 | 0.0942 | 0.0002 | −0.0019 |
| 큰 공백 날 제외 | 25 | 0.1009 | 0.0935 | 0.0953 | 0.0944 | 0.0002 | −0.0018 |
왜 전이가 안 되는가
그림을 그리다 합성 생성기의 결함을 찾았다. 확증에 쓴 v1 생성기는 취소를 «사건 수 곱하기 크기» 로만 두어 잔량에 비례하지 않았다. 그래서 추가가 취소보다 조금이라도 많은 경로에서는 잔량이 끝없이 자랐다. 그림 1 의 급변 국면 예시는 1칸 잔량이 15만 단위까지 올라간다. 합성 1칸 잔량 로그의 표준편차는 국면별 1.8 ~ 2.1 로 실데이터 0.72 의 세 배였고, 실제 3선의 잔량 범위는 합성 분포의 좁은 한쪽에만 놓였다. 둘째로 합성 시장은 실제보다 훨씬 바빴다. 2초 칸 공격량 로그 평균이 합성 0.26 ~ 0.90, 실데이터 0.08 이다. 실제 3선은 2초 칸 대부분에 체결이 없는 조용한 시장인데 사전학습은 체결이 잦은 세계를 배웠다.
| 영역 | 60초 체결 | 1칸 잔량 log | 공격량 log | 중간가 변화 | 자기 호가 위치 |
|---|---|---|---|---|---|
| 실데이터 학습 구간 | 0.13 | 0.42 (0.72) | 0.08 (0.29) | 0.00 (0.19) | 0.00 (0.44) |
| 합성 정상 | 0.16 | 2.02 (1.83) | 0.38 (0.55) | 0.00 (0.14) | 0.00 (0.44) |
| 합성 급변 | 0.44 | 1.42 (2.12) | 0.90 (0.77) | 0.00 (0.39) | 0.04 (1.21) |
| 합성 얇은 장 | 0.27 | −0.40 (1.83) | 0.26 (0.44) | 0.00 (0.19) | 0.00 (0.62) |
| 합성 쏠림 | 0.24 | 1.77 (1.98) | 0.51 (0.61) | 0.00 (0.18) | 0.00 (0.59) |
그래도 사전학습이 아무것도 못 배운 것은 아니다. 얼린 임베딩에서 1칸 잔량 로그를 릿지 회귀로 읽으면 확인 구간 R² 가 PT 0.981, 무작위 인코더 0.708 이고, 최근 60초 공격량은 0.899 대 0.766 이다. 300초 변동은 64초 창 밖의 양이라 둘 다 읽지 못한다(R² 음수). 사전학습은 잔량과 흐름을 정리하는 법을 배웠지만, 그 표현 위의 체결 확률 함수는 실데이터가 직접 가르친 것보다 못했다. 마지막으로 남은 몫이 작다. B0 에서 오라클까지 정책 절감 차는 0.085틱이고 가장 좋은 확률 모델도 그중 0.0075틱만 가져간다.
탐색
여기부터는 확증 런 뒤에 추가한 것이라 판정에 쓰지 않는다. 먼저 64초 토큰 이력이 손특징 위에 정보를 더하는지 봤다. LightGBM 23특징에 PT 임베딩 주성분 16개를 더하면 Brier 0.0957(LGB 대비 −0.0003, p 0.010, 27일 중 18일 개선), 무작위 인코더 임베딩 주성분 16개를 더하면 0.0953(−0.0007, p 0.0002, 20일 개선)이다. 무작위 투영이 사전학습 표현보다 낫다. 원 이력에 손특징이 못 잡은 정보가 조금 있지만 그것을 꺼내는 데 합성 사전학습은 도움이 되지 않았다. LightGBM 과 SC 의 확률을 평균한 앙상블은 Brier 0.0950, 정책 절감 +0.1007틱으로 이번 실험에서 가장 좋았지만 LightGBM 대비 이득은 +0.0020틱으로 문턱 0.03 의 15분의 1 이다.
| 모델 | Brier | LGB 대비 | p(LGB 보다 나음) | 정책 절감 | LGB 대비 절감 | LGB 보다 나은 날 |
|---|---|---|---|---|---|---|
| LGB 23특징 | 0.0960 | 0 | 0.0988 | 0 | ||
| LGB + PT 임베딩 16 | 0.0957 | −0.0003 | 0.010 | 0.1000 | +0.0012 | 18/27 |
| LGB + RF 임베딩 16 | 0.0953 | −0.0007 | 0.0002 | 0.1009 | +0.0022 | 20/27 |
| PT 초기값 전체 미세 조정(무효 런 자료, 시드 하나) | 0.0966 | +0.0005 | 0.88 | 0.1007 | +0.0025 | 10/27 |
| LGB, SC 평균 | 0.0950 | −0.0010 | 0.0002 | 0.1007 | +0.0020 | 23/27 |
사전학습을 «얼린 표현» 이 아니라 «초기값» 으로 쓰는 변형도 돌렸다. PT 인코더에서 출발해 인코더와 머리를 실데이터로 함께 학습하면(학습률 0.0002, 시드 하나), 학습 안 검증 구간 BCE 가 첫 에폭에 0.3548, 셋째 에폭에 0.3515 였다. 처음부터 학습한 SC 의 가장 좋은 값은 시드 둘에서 0.3542, 0.3525 였으니 초기값으로서의 사전학습은 수렴을 앞당기고 검증 손실을 조금 낮춘다. 그러나 확인 구간에서는 이점이 사라졌다. 이 판의 확인 Brier 는 0.0966 으로 그때의 SC 0.0964 와 같고 LightGBM 보다 0.0005 나빴다(p 0.88). 이 판은 계획 수정 전 자료(09-14 가 12월물)로 돌린 것이라 다시 돌리지 않고 무효 런 기준 값으로 표시한다. 시드 하나라 SC 와의 차이는 시드 차이 안에 있다. 잔량 비례 취소로 고친 v2 생성기의 Kaggle 재학습(20분)은 Kaggle 동시 실행 한도 때문에 이 밤 안에 대기열에서 시작하지 못했다. 고친 생성기에서 합성 1칸 잔량 중앙값은 국면별 64 ~ 742 단위로 실데이터 범위에 들어왔다.
해석
원 논문의 주장은 합성 주문장 안에서의 일반화였고 실데이터 전이는 정량으로 보이지 않았다. 이 실험은 그 빈칸을 3선에서 채운 셈이다. 합성 사전학습은 잔량과 흐름을 요약하는 표현을 배웠고 무작위 인코더보다 확실히 나았다. 그러나 실데이터가 17.9만 표본이나 있어서 같은 구조를 처음부터 학습하는 쪽이 더 나았고, 손특징 LightGBM 이 여전히 가장 강한 단일 모델이었다. 합성 사전학습은 실데이터가 매우 적을 때를 위한 도구이고, 3선 체결 확률처럼 실데이터가 충분한 문제에서는 이점이 없다. 생성기가 실제보다 바쁘고 잔량이 불안정했던 것이 전이를 더 약하게 만들었다. 정책 관점에서는 앞선 실험의 결론이 그대로다. 남은 비용은 확률을 더 잘 맞히는 데서가 아니라 큐 앞자리를 확보하는 데서 줄여야 한다.
한계
이 결론이 틀릴 수 있는 이유를 적는다.
확인 구간은 27거래일이고 국면은 2026년 10 ~ 11월 하나다. 그중 10월 20일은 앞선 실험의 확인 구간이라 기준선 성능이 이미 공개된 날이다. 우리 모델은 새것이지만 같은 날로 비교했으므로 확인 구간이 완전히 미지의 날은 아니다. 11월 7일만 따로 본 결과가 같은 순서였다는 점이 이 걱정을 조금 덜어 준다.
합성 생성기 v1 의 잔량 비정상성은 결과를 본 뒤 그림을 그리다 발견했다. 확증 결과는 결함이 있는 생성기로 낸 것이고, 고친 v2 는 20분만 학습한 탐색이다. 사전학습은 시드 하나, 45분 한 번이며 학습 시간, 모형 크기, 국면 수를 바꾼 비교는 하지 않았다. 원 논문이 강조한 국면 다양성은 네 국면과 연속 무작위화 한 가지 설계로만 시험했다. 생성기를 실제 3선 통계에 맞추면 전이가 좋아질 수 있지만, 그렇게 하면 실데이터에서 뽑은 값을 합성에 넣는 것이라 이번 설계의 반출 원칙과 부딪친다.
2, 3칸 잔량은 7 ~ 9월 원자료에 없어 가렸다. 깊이가 있는 10월 이후만으로 학습하면 결과가 달라질 수 있다. SC 는 CPU 시간 때문에 최대 6에폭이었고 실제로는 3 ~ 4에폭에서 검증 손실이 나빠져 멈췄다. 더 학습하면 SC 가 나아질 수 있으며 그러면 H1022 의 결론은 더 강해진다. 체결 재생은 앞 잔량 취소를 세지 않는 보수적 가정이고 체결 방향은 직전 호가로 추정했다. 거래소 수수료와 우리 주문이 시장에 주는 영향은 넣지 않았다. 10선, 30선은 실측 스프레드와 큐가 달라 이 수치를 옮길 수 없다. H1021 문턱 0.03틱은 아이디어 원안 값이며, 오라클까지 남은 0.079틱의 약 40% 라 처음부터 큰 요구였다. 결과를 본 뒤 문턱을 바꾸지 않았다.
독립 감사 지적도 적는다. 첫째, 처음 런은 앞선 실험 캐시를 그대로 써서 그날 하루 전체 체결량 1위 종목을 장중 표본에 썼다. 장중에 알 수 없는 정보라 계획 수정을 먼저 커밋하고 직전 영업일 1위로 바꿔 다시 돌렸다. 바뀐 날은 학습 구간의 09-14 하루였고 판정은 같았다. 둘째, 진입 뒤 180초 안에 90초 넘는 호가 공백이 있으면 표본을 뺐다. 감사는 이것을 미래에 따른 선별로 봤지만, 공백은 시장 상태가 아니라 수집기 누락이라 그 구간의 라벨(60초 체결과 대체 비용)을 아예 잴 수 없다. 거래를 고르는 필터가 아니라 결측 처리다. 앞쪽 공백만으로 빠진 표본은 전체 격자 328,436 가운데 180건(확인 구간 108건, 0.09%)이라 결과를 움직일 크기가 아니다. 셋째, 사전등록 머리말의 작성 시각 00:55 는 잘못 적은 것이고 계획 커밋은 00:13 이다.
다음에 해 볼 것
먼저 사전학습을 초기값으로 쓰는 판을 확증한다. 탐색에서 PT 인코더로 출발한 전체 미세 조정이 처음부터 학습보다 검증 손실은 낮았지만 확인 구간 Brier 는 같았다. 시드 하나로는 가를 수 없는 차이다. 잔량 비례 취소로 고친 v2 생성기로 다시 사전학습하고, 초기값 미세 조정 대 처음부터 학습을 시드 다섯씩 돌려 2026-11-11 이후 새 날을 확인 구간으로 사전등록해 비교한다.
둘째, 합성 대신 실데이터 자기지도 사전학습을 해 본다. 우리 코스콤 호가 전체를 장 내내 2초 토큰으로 만들면 라벨 없는 토큰이 수백만 개다. 다음 토큰 예측으로 로컬 CPU 에서 작은 인코더(2층, 은닉 64)를 학습하고 같은 머리 비교를 한다. 라벨이 붙은 표본은 10초 격자뿐이지만 토큰은 2초마다 있으니 쓸 수 있는 자료가 다섯 배 넘게 는다. 반출 문제도 없다.
셋째, LightGBM 과 SC 앙상블을 큐 앞자리 정책에 붙인다. 앞선 실험의 «큐 맨 앞, 10계약» 격자 칸이 0.37틱 상한이다. 양쪽 1호가에 작은 주문을 상시 두고 신호가 나면 이미 앞자리에 있는 쪽을 쓰는 정책을 같은 코스콤 자료로 재생하고, 어느 쪽 주문을 유지할지를 이번 실험의 가장 좋은 확률로 고른다. 원치 않는 체결의 비용과 재게시 큐 위치를 함께 센다.
산출물
정본 런 하나와 Kaggle 사전학습 한 번의 산출물이다. 페이지의 수치와 그림은 모두 정본 런 폴더와 Kaggle 결과 폴더에서 읽는다. 실데이터 표본과 토큰 캐시는 저장소 밖 캐시 폴더에 두며, 재현할 때는 자료 스크립트를 먼저 돌린다.
- 사전등록
protocol.md - 분석과 판정
analysis.md - 자료와 표본
code/data.py,code/s1_samples_0241.py,code/s1_real.py - 합성 생성기와 모델
code/sim.py,code/model.py,code/pretrain.py,code/build_kernel.py - Kaggle 커널과 결과
kaggle/kernel/→results/20261111T001601_kaggle/ - SC 학습
code/s3_scratch.py - 정본 런
code/s2_main.py→results/20261111T031322_main/(첫 런은results/_void_20261111T011256_main/) - 부록 실물, 공백 점검
code/s4_appendix.py,code/s7_gapcheck.py→results/appendix/ - 그림과 구조도
code/render_figures.py,code/render_model.py - 재현 명령
uv run python code/data.py,code/s1_real.py,code/build_kernel.py 45뒤 Kaggle 실행,code/s3_scratch.py,code/s2_main.py results/20261111T001601_kaggle/out/encoder.pt results/20261111T001601_kaggle/out/pretrain_full.pt
Appendix
A. 데이터셋 실물
2026-11-09 11:00:00 매수 가상 주문 하나를 따라간다. 아래는 t0 직전 6초의 3선 근월 호가 행이다. 10:59:59.04 에 매도 공격 939계약이 103.73 매수 호가를 다 먹어 최우선 매수가 103.72 로 내려갔고, 그 칸의 잔량 1,053계약이 우리 주문 앞에 선다.
| 거래소 시각 | 매수1 | 매수1 잔량 | 매도1 | 매도1 잔량 | 매수2 잔량 | 매도2 잔량 |
|---|---|---|---|---|---|---|
| 10:59:56.076 | 103.73 | 1,049 | 103.74 | 955 | 1,283 | 1,455 |
| 10:59:57.570 | 103.73 | 1,049 | 103.74 | 955 | 1,272 | 1,455 |
| 10:59:58.815 | 103.73 | 939 | 103.74 | 832 | 1,279 | 1,455 |
| 10:59:59.097 | 103.72 | 1,075 | 103.73 | 817 | 1,598 | 908 |
| 10:59:59.355 | 103.72 | 1,053 | 103.73 | 865 | 1,606 | 912 |
| 10:59:59.722 | 103.72 | 1,053 | 103.73 | 865 | 1,606 | 913 |
t0 뒤 체결은 103.72 에 1, 50, 358, 82, 1, 1, 5계약 순으로 이어졌다. 같은 가격 누적이 Q0 + 50 = 1,103계약에 닿은 것은 65.5초 뒤라 60초 라벨은 0 이고, 60초 뒤 시장가 대체 비용 cU60 은 −0.5틱(가격이 우리 쪽으로 와서 오히려 이득)이었다. 아래는 이 표본의 마지막 토큰 셋(가린 2, 3칸 열은 뺌)과, 같은 모양의 합성 급변 국면 표본 토큰 셋이다. 합성 쪽은 공격량 로그가 칸마다 1.5 를 넘어 실데이터(대부분 0)보다 훨씬 바쁘다.
| 칸 | 자기 1칸 log | 반대 1칸 log | 스프레드 | 중간가 변화 | 자기 공격량 | 반대 공격량 | 자기 호가 위치 |
|---|---|---|---|---|---|---|---|
| 실 t0 − 4초 | 0.957 | 0.863 | 0 | 0 | 0.000 | 0.000 | +1 |
| 실 t0 − 2초 | 0.957 | 0.863 | 0 | 0 | 0.000 | 0.000 | +1 |
| 실 t0 | 0.960 | 0.764 | 0 | −1 | 2.322 | 0.828 | 0 |
| 합성 t0 − 4초 | 0.338 | −0.418 | 0 | 0 | 1.673 | 1.815 | +1 |
| 합성 t0 − 2초 | −0.444 | 0.705 | 0 | +1 | 1.682 | 1.594 | +2 |
| 합성 t0 | 0.223 | −0.251 | 0 | −2 | 1.649 | 1.479 | 0 |
B. 모델 입출력 실물
같은 날 10:59:30 ~ 11:00:30 가상 주문 가운데 열 건에 각 모델이 낸 60초 체결 확률이다. 입력은 위와 같은 토큰 32개(PT, SC, RF)와 손특징 23개(LGB), 큐 길이 하나(B0)다. 11:00:00 매수 주문(앞 잔량 1,053)은 실제로 채워지지 않았는데 LGB 0.312, PT 0.257, SC 0.209 로 직전 대량 체결에 반응했다. 11:00:30 매수 주문은 앞 잔량이 121계약뿐이라 모든 모델이 높게 봤고 실제로 채워졌다.
| 시각 | 방향 | Q0 | 실제 y | B0 | LGB | PT | SC | RF | ĉU60 |
|---|---|---|---|---|---|---|---|---|---|
| 10:59:30 | 매도 | 1,195 | 0 | 0.063 | 0.133 | 0.109 | 0.041 | 0.077 | 0.579 |
| 10:59:30 | 매수 | 897 | 1 | 0.082 | 0.048 | 0.079 | 0.114 | 0.071 | 0.581 |
| 11:00:00 | 매도 | 865 | 0 | 0.085 | 0.117 | 0.191 | 0.544 | 0.588 | 0.860 |
| 11:00:00 | 매수 | 1,053 | 0 | 0.071 | 0.312 | 0.257 | 0.209 | 0.165 | 0.695 |
| 11:00:10 | 매도 | 917 | 0 | 0.080 | 0.120 | 0.104 | 0.340 | 0.517 | 0.732 |
| 11:00:10 | 매수 | 493 | 1 | 0.138 | 0.339 | 0.347 | 0.400 | 0.180 | 0.649 |
| 11:00:20 | 매도 | 527 | 1 | 0.131 | 0.513 | 0.321 | 0.553 | 0.718 | 0.747 |
| 11:00:20 | 매수 | 1,136 | 0 | 0.066 | 0.183 | 0.186 | 0.191 | 0.328 | 0.907 |
| 11:00:30 | 매도 | 870 | 0 | 0.084 | 0.045 | 0.071 | 0.245 | 0.409 | 1.016 |
| 11:00:30 | 매수 | 121 | 1 | 0.386 | 0.699 | 0.601 | 0.562 | 0.302 | 0.516 |
정책은 p × cF + (1 − p) × ĉU60 < cM 이면 지정가를 낸다. 이 시각들의 cM 은 0.5, cF 는 −0.5 다. 11:00:00 매수 주문에서 PT 는 0.257 × (−0.5) + 0.743 × 0.695 = 0.388 < 0.5 라 지정가를 골랐고, 실제로는 못 채웠지만 60초 뒤 대체 비용이 −0.5틱이라 결과적으로 시장가보다 1틱 나았다.
C. 실험 설정
| 항목 | 값 |
|---|---|
| 표본 | 0241 가상 주문 표본, 09:00 ~ 15:15, 10초 x 양방향, 50계약, 큐 맨 뒤, 공격 방향 직전 호가 추정 |
| 분할 | 학습 2026-07-08 ~ 09-30(48일, 그중 09-18 ~ 09-30 6일은 조기 종료 검증), 확인 10-01 ~ 11-10(27일) |
| 토큰 | 2초 x 32개, 특징 12개(2, 3칸 잔량 4개는 0 으로 가림) |
| 합성 생성기 v1 | 0.1초 이산 Hawkes, 국면 4, 분기비 합 < 0.92, 감쇠 0.5 ~ 5/초, 경로 1,024 x 1,200초 묶음 |
| 인코더 | Transformer, d_model 128, 층 4, 머리 4, FF 512, GELU, 사전 정규화, 드롭아웃 0.1, 모수 799,360 |
| 사전학습 | Kaggle Tesla T4, 45분, AdamW 5e-4 코사인, 배치 1,024, 혼합 정밀도, 묶음 171, 표본 36,421,632 |
| 머리 | MLP 128 → 64 → 1, Adam 1e-3, 배치 1,024, 최대 30에폭, 인내 3, 시드 1, 2 평균 |
| SC | 같은 인코더 + 머리, AdamW 5e-4, 배치 512, 최대 6에폭, 인내 1, 시드 1, 2 평균, CPU 8스레드 |
| B0, LGB, ĉU60 | 로지스틱 C = 1, LightGBM 300그루, 학습률 0.05, 잎 31, 최소 표본 200(0241 그대로) |
| 검정 | 확인 27일 날 블록 부트스트랩 5,000회(seed 274), 한쪽 p, Holm(H1020 ~ H1022) |
| 비용 | 도착 중간가 대비 틱, 왕복 환산 판정 1틱, 보고 2틱, 민감도 0.5틱 |